SoundFlow / Kardome Echo 테스트 데이터 전체 분석
이 문서는 지금까지 모은 AEC 녹음과 로그를 정리한 자료다. 2026-10-15에 실제 재생 구간의 억압량, 외부 자료에 근거한 성능 의견, 음성 LLM의 barge-in 구성과 판정 조건을 추가했다. 새 녹음이나 barge-in 실기기 시험 결과를 추가한 것은 아니다.
실제 음성 재생 구간: 약 43 dB는 어느 정도인가?
현재 의견: 약 43 dB의 입력 대비 출력 감소는 억압량 관점에서 좋은 성능을 기대하게 하는 긍정적인 결과다. 다만 순수 AEC 성능 인증이나 barge-in 동작 보장을 뜻하지 않는다. 여기서 활성 구간은 재생 기준 신호 REF가 활성인 구간이다. 사용자가 동시에 말하는 구간을 검증했다는 뜻은 아니다.
| 측정 자료 | 선택한 재생 구간 | MIC 대비 Kardome 출력 감소량 | 판정 범위 |
|---|---|---|---|
| v1.1.18 다섯 명령 | REF RMS > 0.01, 총 23.00초 | 통합 42.48 dB | 모든 선택 샘플의 전력을 합산한 대표값 |
| 같은 다섯 명령을 각각 계산 | 명령별 2.50~6.75초 | 39.41~44.92 dB, 명령별 평균 42.68 dB | 관측 범위이며 최소 보장값이 아님 |
| 별도 실녹음의 유효 구간 | 4~9초 / 20~25초 | 43.63 / 43.51 dB, 단순 평균 43.57 dB | 같은 녹음의 두 구간이며 독립 반복 시험이 아님 |
| 별도 실녹음의 제외 구간 | 35~40초 | 성능 판단에서 제외 | MIC가 잡음 바닥 수준으로 REF 유입을 확인하지 못함 |
계산값은 20 log10(RMS_MIC4ch / RMS_Kardome)이다. 약 43 dB는 이 두 디지털 신호의 RMS 비로 약 141:1에 해당한다. raw MIC 4채널과 처리 후 mono 출력 사이의 빔포밍·전처리·게인 차이를 포함하므로 이를 에코만 99.995% 제거했다거나 사용자 음성이 그만큼 선명해졌다고 해석하지 않는다. 상세 수치와 선택 기준은 아래 기존 분석에 유지했다.
일반적인 에코캔슬 성능과 비교한 자료 기반 의견
| 1차 자료 | 자료에서 확인한 내용 | 이번 43 dB에 적용할 수 있는 해석 |
|---|---|---|
| Microchip dsPIC33F Product Overview, DS70155C, 인쇄 p.53 / PDF p.55 | AEC 라이브러리의 에코 제거량을 전형적으로 40 dB 초과, 최대 50 dB로 제시 | 40 dB대가 실용 AEC 제품에서 제시하는 유의미한 억압량 규모라는 근거. 2005년 8 kHz·0~4 kHz 협대역 자료로, 우리 제품과 동일 시험이거나 현재 업계 합격선이라는 뜻은 아님 |
| Lectrosonics — Acoustic Echo Cancellation | 자연적인 경로 손실 ERL 15 dB와 AEC 처리 이득 ERLE 25 dB를 더해 총 40 dB가 되는 설명 예시 | 수십 dB의 추가 억압이 실용적으로 의미 있음을 설명하는 맥락. 총 경로 손실 40 dB와 우리의 MIC/출력 차이를 동일 지표로 비교하면 안 됨 |
| Microsoft 등 — ICASSP 2022 AEC Challenge, §1 | ERLE는 조용한 single-talk 조건에 적합하며 double-talk에는 부적합. 음성 인식 단어 정확도도 평가에 포함 | 억압량이 커도 사용자 동시 발화의 보존과 인식 성능은 별도로 확인해야 함 |
공학적 판단: 같은 경로·게인에서 에코 성분의 43 dB 제거가 검증됐다면, 제조사 공개 사양과 비교해 억압량 측면에서 좋은 수준이라고 평가할 근거가 있다. 현재 우리 결과는 그 규모에 해당하는 입력/출력 감소를 보여 주므로 긍정적으로 평가하되, 동일한 ERLE 43 dB를 확보했다고 단정하지 않는다. 위 자료는 “43 dB 이상이면 모든 제품에서 barge-in 합격”이라는 공통 기준을 제시하지 않는다.
Barge-in 목적의 현재 판정
목적은 기기가 말하는 동안 사용자가 끼어들었을 때, 재생 에코 때문에 잘못 멈추지 않고 사용자 목소리를 놓치지 않으며 빠르게 재생을 중단하고 새 명령을 인식하는 것이다. 사용자 목소리까지 작게 만드는 처리는 출력 감소량이 커도 이 목적에 맞지 않는다.
| 필요한 조건 | 현재 판단 | 제품 판정에 필요한 확인 |
|---|---|---|
| 재생 소리의 입력 대비 처리 출력 감소 | 긍정적: 약 43 dB 관측 | 실제 VAD/STT가 받는 입력 경로에서도 잔여 에코를 확인 |
| 사용자 없이 TTS만 재생할 때 오검출 방지 | 미검증 | 잘못된 중단 횟수 / 재생 시간, TTS 내용의 자기 인식 여부 |
| TTS 중 사용자 음성 보존 | 미검증 | 첫 음절 손실, TTS OFF 대비 명령 성공률·WER/CER 변화 |
| 끼어들기 감지 후 실제 소리가 빠르게 멈춤 | 미검증 | 사용자 발화 시작→실제 스피커 재생 중단 지연의 중앙값·95백분위 |
| 거리·방향·음량·소음 변화에서도 성공 | 미검증 | 조건별 성공/시도 수, 누락률, 오검출률 |
판정: 에코 억압량은 긍정적이며 barge-in 통합 시험을 진행할 근거가 있다. Barge-in 제품 성능 보장은 아직 보류한다. 합격 수치는 제품의 허용 지연·오검출 수준에 맞춰 시험 전에 정해야 하며, 여기서는 검증되지 않은 공통 dB 합격선을 만들지 않는다.
음성 LLM 솔루션은 AEC만으로 barge-in을 처리하는가?
대표적인 음성 에이전트 프레임워크는 AEC만으로 처리하지 않는다. AEC는 입력에서 재생 에코를 줄이는 역할이고, 사용자 발화 감지·끼어들기 판단·진행 중 응답 중단은 별도 역할이다. 시장 전체의 채택 비율을 조사한 결론이 아니라, 아래 공식 문서에서 확인한 구성에 근거한 판단이다.
| 공식 자료 | 확인되는 구성 | 우리 설계에 주는 의미 |
|---|---|---|
| LiveKit — Noise & echo cancellation | 입력의 에코·소음 처리를 별도로 제공하며, 잡음이 턴 감지와 STT 품질에 영향을 준다고 설명 | AEC는 깨끗한 입력을 만드는 앞단 처리로 배치 |
| LiveKit — Turns overview | VAD/STT 기반 감지, 최소 발화 길이·단어 수 등의 끼어들기 정책, 오검출 후 재개, 중단 시 실제 들은 부분까지 대화 이력 조정 | “소리가 감지됨”과 “응답을 확정 중단함”을 구분하고 재생 상태·대화 이력을 함께 관리 |
| Pipecat — User Turn Strategies | 사용자 턴 시작·종료 전략으로 발화 타이밍과 끼어들기를 관리 | AEC 출력 이후에 사용자 턴을 결정하는 별도 계층이 필요 |
우리 제품에 권장하는 구성 — 설계 제안, 구현 완료 판정 아님
실제 재생 PCM → AEC reference와 MIC → Kardome 처리 → 사용자 발화 감지 → 끼어들기 정책 → 재생/생성 중단을 연결한다. 사용자 오디오는 별도로 계속 수집해 STT와 다음 LLM 요청으로 전달한다.
| 단계 | 책임과 권장 동작 | 놓치면 생기는 문제 |
|---|---|---|
| 1. AEC / 음향 전처리 | 실제 재생 PCM과 정렬된 reference를 사용. 동시 발화에서 사용자 음성을 보존하는지 확인 | 잔여 에코가 음성으로 검출되거나 사용자 목소리까지 손상 |
| 2. VAD와 발화 시작 보존 | 처리 후 음성의 시작을 빠르게 감지하고 짧은 선행 오디오 버퍼로 첫 음절을 보존. 사용자 입력은 재생 중에도 계속 수집 | TTS 중 마이크를 막으면 barge-in 자체가 불가능 |
| 3. 끼어들기 정책 | 발화 지속 시간·신뢰도·필요시 STT 또는 음향 모델로 후보를 확인. 짧은 “멈춰”도 허용하도록 튜닝 | 소음/잔여 에코에 자주 멈추거나 최소 단어 수 때문에 짧은 명령 누락 |
| 4. 로컬 재생 중단 | 확정 이벤트에서 플레이어 중단과 이미 쌓인 오디오 큐 정리. 중단 시점을 기록 | 서버 생성을 취소해도 버퍼에 남은 말이 계속 재생 |
| 5. 생성 취소와 오래된 응답 차단 | 진행 중 LLM/TTS 생성을 가능한 범위에서 취소하고 응답 ID로 늦게 도착한 청크를 차단 | 끊은 이전 답변이 다시 재생되거나 새 답변과 섞임 |
| 6. 턴·대화 이력 관리 | 실제 재생된 부분과 취소된 부분을 구분하고, 사용자 발화 종료를 판단해 새 요청을 전달. 오검출이면 정책에 따라 재개 | 듣지 못한 내용을 들었다고 가정하거나 사용자 문장 끝을 너무 일찍 자름 |
위 표의 선행 버퍼·응답 ID·로컬 중단 구성은 공식 프레임워크의 역할 분리를 우리 기기에 적용한 설계 제안이다. 라이브러리 기본값이나 우리 코드의 현재 동작을 확인했다는 뜻은 아니다. 초기 구성은 AEC + VAD + 단순한 끼어들기 정책 + 로컬 재생 중단/큐 정리 + 생성 취소/이력 동기화가 적절하다. 먼저 이 구성의 오검출과 누락을 측정하고, 필요할 때 의미 기반 판정이나 화자/방향 정보를 보조 신호로 추가한다. 긴 LLM 판단을 기다리느라 재생 중단이 늦어지지 않도록 한다.
턴 종료 감지는 “사용자가 말을 끝냈는가”, 끼어들기 감지는 “기기가 말하는 도중 사용자가 발화를 시작했는가”를 다룬다. 같은 모델로 처리할 수도 있지만 역할과 지연 예산은 구분해야 한다. Double-talk 구간에서는 총 출력 RMS 감소량을 최대화하지 말고 사용자 인식 성공·첫 음절 보존·오검출·실제 중단 지연으로 판정한다.
우선 확인할 세 가지 시험
- TTS만 재생: 여러 문장·음량에서 자기 목소리에 의해 중단되는 횟수와 STT 오인식을 기록한다.
- 사용자만 발화: 같은 거리·방향·문장으로 기본 명령 성공률과 첫 음절 보존 상태를 확보한다.
- TTS + 사용자 동시 발화: TTS 시작 직후·중간·끝부분에 “멈춰”와 일반 명령으로 끼어들고, 2번 대비 인식 저하 및 발화 시작→실제 출력 중단 지연을 측정한다. 재생 음량·거리·방향·팬 소음·화자를 기록하고 조건별로 반복한다.
현재 보고서의 약 43 dB는 이 중 음향 전처리의 긍정적인 출발점이다. 최종 barge-in 성공 여부는 위 전체 경로의 시험으로 확정한다.
OpenAI Realtime의 barge-in: AI 발화 중 사용자 감지부터 다음 응답까지
여기서 barge-in은 AI 음성이 스피커에서 재생되는 동안 사용자가 말을 시작하고, 시스템이 AI 발화를 중단해 사용자의 말을 받아들이는 동작이다. AI 발화가 끝난 뒤 다음 질문을 받는 일반적인 턴 전환과 구분한다. 이전 절은 이 중 취소·이력 보정에 집중했으므로, 아래에서 실제 발화가 겹치는 순간부터 전체 흐름을 연결한다.
AI와 사용자의 말이 겹치는 순간의 처리 흐름
다음은 OpenAI의 공개 interruption 동작과 우리 기기에 필요한 음향 전처리를 연결한 구성이다. AEC와 기기 재생 큐 제어는 제품 구성에 관한 제안이며, OpenAI 서버가 우리 기기의 에코 제거를 보장한다는 뜻은 아니다.
| 순서 | 실제 상황 | 담당 처리 | 프롬프트의 역할 |
|---|---|---|---|
| 1. AI 말하기 | 스피커가 답변 A를 재생하고 마이크도 계속 입력을 받음 | 재생 신호를 참조하는 AEC로 자기 목소리의 유입을 억제 | 감지 전에 프롬프트가 음향 에코를 제거하지 않음 |
| 2. 사용자 끼어들기 | AI가 아직 말하는 중에 사용자가 “잠깐, 습도 알려줘”라고 말을 시작 | 처리된 입력에서 VAD가 speech start 감지. 우리 제품은 잔류 에코에 의한 오검출도 검증해야 함 | 기본 VAD 경로에서는 LLM이 전체 문장의 의미를 해석할 때까지 중단을 기다리지 않음 |
| 3. 발언권 넘기기 | AI 소리를 멈추고 사용자 발화는 계속 수집 | 자동 interruption 설정에 따른 생성 취소와 재생 중단. WebSocket은 로컬 플레이어·큐를 직접 중단 | “말을 멈춰라”라는 프롬프트만 보내는 것으로 플레이어 제어를 대체할 수 없음 |
| 4. 이전 응답 정리 | 답변 A에서 아직 재생되지 않은 부분이 남음 | 실제 재생 지점에 맞춰 conversation을 truncate | 미전달 내용을 전달 완료로 모델 문맥에 남기지 않도록 상태를 보정 |
| 5. 사용자 말 듣기 | 사용자가 “습도 알려줘”까지 마침 | 턴 종료 감지 후 새 응답 생성. 자동 생성 설정을 끄면 앱이 생성 시점을 제어 | 발화 시작 감지와 발화 종료 판단은 구분 |
| 6. 새 요청에 답하기 | 답변 B로 습도 안내 | 새 사용자 입력 + 보정된 대화 문맥으로 응답 | 최신 요청 우선, 중단된 설명의 불필요한 반복 방지 같은 지침 적용 가능 |
OpenAI 공식 문서는 이를 Handling interruptions라는 이름으로 설명한다. VAD의 interrupt_response는 사용자 발화 시작에 따른 응답 중단을, create_response는 사용자 발화 종료 후 자동 응답 생성을 제어한다. OpenAI interruption 흐름, VAD 설정
따라서 프롬프트·이력 처리는 barge-in 전체 중 “중단된 응답을 정리하고 다음 대화를 이어가는 부분”이다. 사용자를 감지하고 스피커를 멈추는 기능까지 프롬프트만으로 구현하는 것은 아니다. 아래 내용은 2026-10-15에 확인한 공개 Realtime API 동작이며, ChatGPT 음성 모드의 비공개 내부 프롬프트를 확인한 것은 아니다.
공식 문서로 확인되는 처리
| 구분 | 확인 내용 | 설계상 의미 |
|---|---|---|
| 이전 대화 | 기본 응답은 세션의 conversation에 누적된다 | 매 턴 이전 대화 전체를 별도 프롬프트로 다시 만드는 방식은 필수가 아님 |
| 자동 끼어들기 | VAD의 interrupt_response로 진행 중 응답의 자동 취소를 제어 |
음성 감지와 응답 취소 정책은 설정으로 연결 |
| 생성 취소 | response.cancel은 진행 중 생성을 취소하며, 완료 이벤트는 response.done의 cancelled 상태 |
생성 취소와 기기의 재생 큐 정리는 별도로 다뤄야 함 |
| 이력 보정 | conversation.item.truncate의 audio_end_ms로 재생 지점에 맞춰 assistant 오디오를 자름. 관련 서버 텍스트 전사도 제거 |
듣지 않은 내용을 이미 전달했다고 가정하는 오류를 방지 |
근거: Realtime conversations — 기본 conversation과 interruption, VAD — 자동 응답·중단 설정, Client events — response.cancel / conversation.item.truncate.
연결 방식에 따라 누가 처리하는가?
| 연결 방식 | 재생·이력 동기화 책임 |
|---|---|
| OpenAI Realtime WebRTC / SIP | 서버가 출력 오디오 버퍼와 재생 진행을 관리하고, 문서의 자동 interruption 흐름에서 미재생 오디오를 자동 truncate |
| OpenAI Realtime WebSocket | 클라이언트가 input_audio_buffer.speech_started를 받으면 로컬 재생을 중단하고 실제 재생 시간을 계산하여 truncate 전송. 자동 취소를 사용하지 않으면 생성 취소도 직접 수행 |
| 자체 STT → LLM → TTS | 애플리케이션이 생성문·실제 재생분·중단 상태를 추적하고 다음 LLM 입력 이력을 구성하는 방식 제안. OpenAI Realtime의 자동 처리가 이 구조에 그대로 적용되는 것은 아님 |
근거: OpenAI — Handling interruptions. 오디오와 텍스트가 정확히 정렬되지는 않으므로, truncate가 들은 부분의 정확한 문장 전사까지 반환한다고 가정하면 안 된다.
Barge-in 예시: AI가 말하는 도중 사용자가 발언권을 가져오는 경우
아래 문장과 시간은 동작 설명용 가상 예시이며 실측값이 아니다.
| 시점 | 사용자에게 들린 내용 / 시스템 상태 | 필요한 처리 |
|---|---|---|
| AI 발화 중 | “현재 실내 온도는…”이 스피커에서 나오고 있음. 생성 버퍼에는 뒷문장도 있을 수 있음 | 마이크 수집을 유지하고, AI 발화의 에코를 억제 |
| 발화 겹침 → 중단 | AI 재생 중 사용자가 “잠깐…”을 시작. 감지 후 플레이어를 멈춘 시점의 재생 위치가 1.5초 | 재생 중단·큐 비우기, 진행 중 생성 취소. 사용자의 나머지 발화는 계속 수집 |
| 문맥 보정 | 뒤의 권장 온도·예약 안내는 아직 듣지 못함 | 미재생 내용을 전달 완료 이력으로 남기지 않음 |
| 다음 응답 | 새로운 사용자 요청은 습도 질문 | 필요한 이전 대화와 보정된 응답 이력을 사용해 답변 |
WebSocket에서 재생기가 실제 재생 위치를 1,500ms로 보고한 경우의 truncate 이벤트 예시는 다음과 같다. item_id는 실제 assistant 항목 ID로 바꿔야 하며, 시간은 수신량이나 생성량이 아닌 재생량을 기준으로 한다.
{
  "type": "conversation.item.truncate",
  "item_id": "item_assistant_example",
  "content_index": 0,
  "audio_end_ms": 1500
}
진행 중 생성이 있으면 설정에 따른 자동 취소 또는 response.cancel을 사용한다. 응답이 이미 모두 생성됐다면 로컬에 남은 오디오의 중단·이력 보정이 여전히 필요하다. truncate 성공은 conversation.item.truncated로 확인할 수 있다. 공식 이벤트 정의
프롬프트에는 무엇을 추가하는 것이 적절한가?
아래는 우리 제품에 적용할 수 있는 보조 지침 예시다. OpenAI의 숨겨진 프롬프트나 필수 표준 문구가 아니다.
사용자가 끼어들면 최신 요청을 우선해 답한다. 중단된 설명을 임의로 처음부터 반복하지 않는다. 전달 여부가 확인되지 않은 설명을 사용자가 이미 들었다고 가정하지 않는다. 실행 결과는 실제 도구 결과를 기준으로 설명한다.
이 지침은 답변 방식을 정할 뿐, 스피커 중단이나 이력 삭제를 실행하지 않는다. 자체 STT → LLM → TTS 구성에서는 다음 정보를 애플리케이션에서 관리하는 방식을 제안한다.
| 관리 대상 | 권장 처리 |
|---|---|
| 생성문과 전달분 | 전체 생성문은 진단용 기록과 구분. TTS 재생 완료 구간을 추적하고, 확실히 전달된 내용만 전달 완료로 취급 |
| 불확실한 경계 | 단어별 정렬이 없으면 정확히 어디까지 들었는지 단정하지 말고, 보수적인 완료 구간과 중단 상태를 사용 |
| 응답 식별자 | 중단된 응답 ID의 늦게 도착한 LLM/TTS 결과가 다시 재생되지 않도록 차단 |
| 이전 대화·도구 결과 | 관련 이전 사용자 요청과 실제 실행 결과를 유지. 음성 응답 취소를 기기 동작 취소나 롤백으로 해석하지 않음 |
현재 약 43 dB의 감소량은 음향 입력 품질에 대한 근거다. 자연스러운 barge-in에는 여기에 발화 감지, 재생·생성 중단, 실제 전달 상태에 맞는 대화 이력 관리가 함께 필요하다. 위 구성은 설계 제안이며, 현재 제품 코드에 구현됐거나 실기기에서 검증됐다는 의미는 아니다.
기존 버전 비교와 상세 측정
먼저 보는 결론: 사용자는 실제 사용 중 Ding 효과음 뒤에 들리던 echo가 v1.1.18에서 많이 줄었다고 보고했다. 같은 명령으로 분류된 버전별 녹음 한 쌍에서도 v1.1.18 처리 출력이 더 작고, 전체 구간을 합친 계산값은 4.45 dB 높았다. 체감과 측정 신호가 모두 v1.1.18에 유리한 방향이다. 따라서 현재 Ding 사용에서는 v1.1.18을 더 나은 선택으로 판단한다. 아래 수치는 Ding만 따로 고정해 반복 비교한 결과가 아니므로, 개선량을 “항상 4.45 dB”라고 읽지는 않는다.
한눈에 보는 결과
| 자료군 | 자료 수 | 주요 관측 | 해석 |
|---|---|---|---|
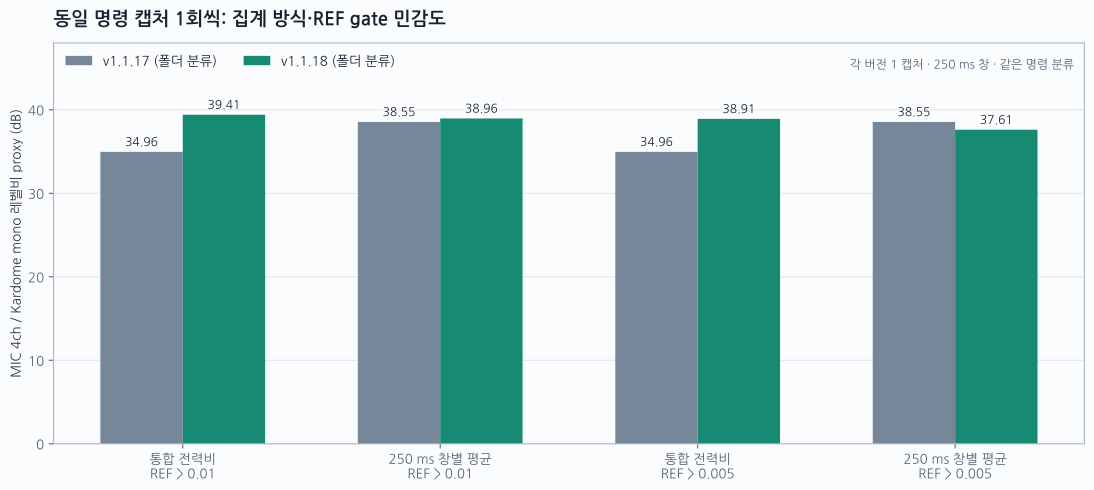
| 같은 명령의 버전별 녹음 | v1.1.17 1회, v1.1.18 1회 | 전체 활성 구간을 합쳐 비교: 34.96→39.41 dB (+4.45 dB) | v1.1.18 쪽 출력이 더 작게 관측됨. 짧은 구간을 똑같이 평균하면 차이는 +0.42 dB |
| v1.1.18 명령 다섯 건 | 서로 다른 명령 5개 | 명령별 평균 42.68 dB, 전체 구간을 합친 값 42.48 dB | 같은 문장을 다섯 번 반복한 시험은 아님 |
| 사용자가 지정한 실 녹음 | 46.144초 녹음의 구간 3개 | 4–9초 43.63 dB, 20–25초 43.51 dB | 두 구간의 출력 레벨 차이 평균 43.57 dB. 35–40초는 MIC가 바닥 수준이라 제외 |
| 앱 TTS 기기 진단 | v1.1.18 캡처 3회, 수치 상세는 Echo2 분석 | 분석 대상 구간 REF는 활성이나 MIC 상관 최대치 0.028–0.037 | 스피커가 들리지 않았다는 사용자 관찰과 일치하는 진단 상태. ERLE 계산 대상 아님 |
| 별도 7–8월 효과음/F2 시험 | 과거 효과음 시험과 실제 F2 캡처 | v1.1.14 약 34.0 dB, v1.1.17 약 33.1 dB; 실제 F2 구간 약 27.49 dB | 다른 수정·상황·계산 자료이므로 9월 비교와 합산하지 않음 |
1. 측정 숫자를 쉽게 읽는 법
재생 소리는 기준 신호(REF), 마이크에 들어온 소리는 MIC, Kardome가 처리해 내보낸 소리는 Kardome 출력으로 표시했다. 이 보고서의 dB 값은 같은 녹음 시점에서 MIC 소리 크기와 Kardome 출력 소리 크기를 비교한 값이다. 숫자가 크면 이 자료에서 Kardome 출력이 MIC 입력보다 작게 잡혔다는 뜻이다.
이 값은 표준 ERLE 그 자체가 아니다. 마이크 원본과 처리된 출력 사이에는 채널 수와 빔포밍·전처리·음량 차이도 있을 수 있기 때문이다. 아래에서는 계산에 사용한 정확한 이름을 “MIC 대비 Kardome 출력 레벨 차이”로 부른다. Ding 체감과 버전 비교를 이해하는 데 필요한 요약은 위 결론에 두고, 계산 세부사항은 이 절과 각 표에 남겼다.
2. 계산 방법
입력과 동기화
주요 버전 비교와 v1.1.18 명령 분석에는 통합 sndflow_allinout를 사용했다. 이 파일은 16 kHz, 8채널 float32이며 저장 경로 기준 채널 순서는 MIC 4채널, REF 2채널, outkardome 1채널, outuser 1채널이다. 같은 프레임 안의 채널을 비교해 별도 WAV 사이의 시작 시각 차이를 계산에 끌어들이지 않았다.
RMS와 REF 활성 프레임
각 250 ms 프레임(16 kHz에서 4,000 샘플)에 대해 다음 신호를 계산했다.
MIC power: MIC 채널 4개의 제곱전력 평균REF: REF 두 채널을 샘플별 평균한 모노 신호Kardome out:outkardome채널outuser: 보조 산출물이므로 MIC-to-Kardome proxy 계산에는 사용하지 않음
REF 모노 RMS가 0.01보다 큰 짧은 구간만 주 비교에 넣었다. 조용한 구간이 결과를 섞지 않게 하려는 이 분석의 선택 기준이다. 기준을 0.005로 낮춘 계산도 함께 제시해 선택에 따라 결과가 얼마나 달라지는지 확인했다.
RMS = sqrt(mean(x²))
MIC 대비 Kardome 출력 레벨 차이 (dB) = 20 log10(RMS_MIC4ch / RMS_Kardome)
주의: 이 dB는 Kardome 출력의 음량 자체가 아니라 MIC와 출력의 차이를 나타낸다. 그래서 이 비율은 숫자가 커질수록 분모인 Kardome 출력이 더 작다는 뜻이다. 출력 음량 자체를 비교할 때는 dBFS를 보며, 값이 더 낮고(더 음수이고) 작을수록 소리가 작다.
“전체 구간 합산”은 선택된 모든 샘플의 입력 전력과 출력 전력을 먼저 합쳐 비교한다. “짧은 구간 평균”은 각 250 ms 구간의 dB 값을 구한 다음 각 구간에 같은 비중을 줘 평균한다. 둘은 계산 순서가 달라 결과도 다를 수 있어 함께 표시했다.
재생 소리가 마이크에도 들어왔는지 확인
재생 신호와 마이크 파형이 얼마나 비슷하게 움직였는지 상관값으로 확인했다. 이 값은 재생음이 마이크에 들어왔는지를 살피는 참고 자료다. 상관값만으로 echo만 녹음됐거나 AEC 처리 전후의 동일 신호를 비교했다고 증명할 수는 없다.
3. v1.1.17과 v1.1.18: 같은 명령 녹음 비교
각각 공기 청정기 켜줘로 분류된 통합 WAV 한 개씩을 비교했다. v1.1.17은 2026-08-13, v1.1.18은 2026-09-02 녹음이며 REF RMS > 0.01 유효 시간은 각각 4.50초와 5.25초다.
두 번째 그래프는 50 ms 단위 REF/MIC/Kardome 출력 RMS envelope를 시간축으로 겹쳐 보여주며, 배경 음영은 REF 활성으로 선택한 구간이다. 특정 순간의 피크 한 개보다 발화 구간 전체의 레벨 변화가 보이도록 했다.
| 계산 | v1.1.17 폴더 분류 | v1.1.18 폴더 분류 | 차이 |
|---|---|---|---|
| 전체 활성 구간 합산, REF RMS > 0.01 | 34.964 dB | 39.411 dB | +4.447 dB |
| 250 ms 구간을 똑같이 평균, REF RMS > 0.01 | 38.548 dB | 38.964 dB | +0.416 dB |
| 전체 활성 구간 합산, REF RMS > 0.005 | 34.964 dB | 38.913 dB | +3.949 dB |
| 250 ms 구간을 똑같이 평균, REF RMS > 0.005 | 38.548 dB | 37.612 dB | −0.936 dB |
그래프 읽기: 전체 활성 구간을 합친 MIC 대비 출력 레벨 차이는 v1.1.18 쪽이 4.45 dB 더 크다. 이는 출력 음량이 커졌다는 뜻이 아니다. 바로 아래 RMS 표에서 Kardome 출력은 v1.1.18이 −86.51 dBFS, v1.1.17이 −83.54 dBFS로 v1.1.18 출력이 2.97 dB 더 작다. 짧은 250 ms 구간마다 같은 비중을 주면 레벨 차이의 차이는 0.42 dB로 작아지고, 조용한 구간을 더 포함하면 평균 방향이 달라질 수 있다. 즉 39.41 dB는 소리 크기 값이 아니라 이 두 녹음의 MIC 대비 출력 레벨 차이다.
활성 프레임 전체에서 REF RMS는 0.025305와 0.024997로 비슷했다. MIC 4ch RMS는 v1.1.18이 1.47 dB 높고, Kardome 출력 RMS는 2.97 dB 낮았다. REF–MIC 최대 지연 탐색 상관 중앙값은 각각 0.731, 0.740이며 중앙 지연은 두 자료 모두 약 2 ms였다. 각 파일 한 건이며 녹음 일자와 acoustic 조건도 고정됐다고 입증되지 않았다.
4. v1.1.18 명령 시나리오 다섯 건
2026-09-02 자료의 통합 WAV 5건을 REF RMS > 0.01 기준으로 각각 분석했다. 다섯 개는 서로 다른 발화이며 동일 음성의 반복 측정이 아니다.
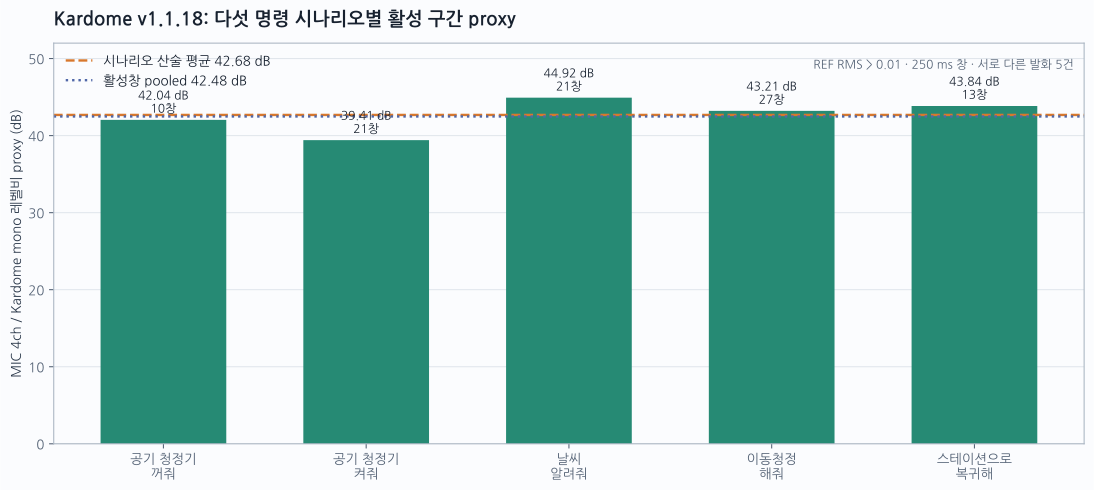
| 시나리오 | 선택된 구간 수 | 선택된 시간 | MIC 대비 출력 레벨 차이 |
|---|---|---|---|
| 공기 청정기 꺼줘 | 10 | 2.50초 | 42.04 dB |
| 공기 청정기 켜줘 | 21 | 5.25초 | 39.41 dB |
| 날씨 알려줘 | 21 | 5.25초 | 44.92 dB |
| 이동청정 해줘 | 27 | 6.75초 | 43.21 dB |
| 스테이션으로 복귀해 | 13 | 3.25초 | 43.84 dB |
| 시나리오별 산술 평균 | 92 | 23.00초 | 42.68 dB |
| 활성 프레임 통합 전력비 | 92 | 23.00초 | 42.48 dB |
구간 선택 기준을 REF RMS > 0.005로 낮추면 시나리오 평균은 42.34 dB, 전체 구간 합산값은 42.13 dB였다. 구간을 어디서부터 포함하는지에 따라 숫자가 달라질 수 있음을 보여준다. 다섯 로그 모두 녹음 파일 저장은 확인됐지만 Test KWS Count: 0이므로 음성 인식 성공을 측정한 자료는 아니다.
5. 사용자가 제공한 실제 녹음
입력은 2026-09-23의 46.144초 sndflow_allinout이고, 사용자가 지정한 4–9초·20–25초·35–40초를 그대로 비교했다.
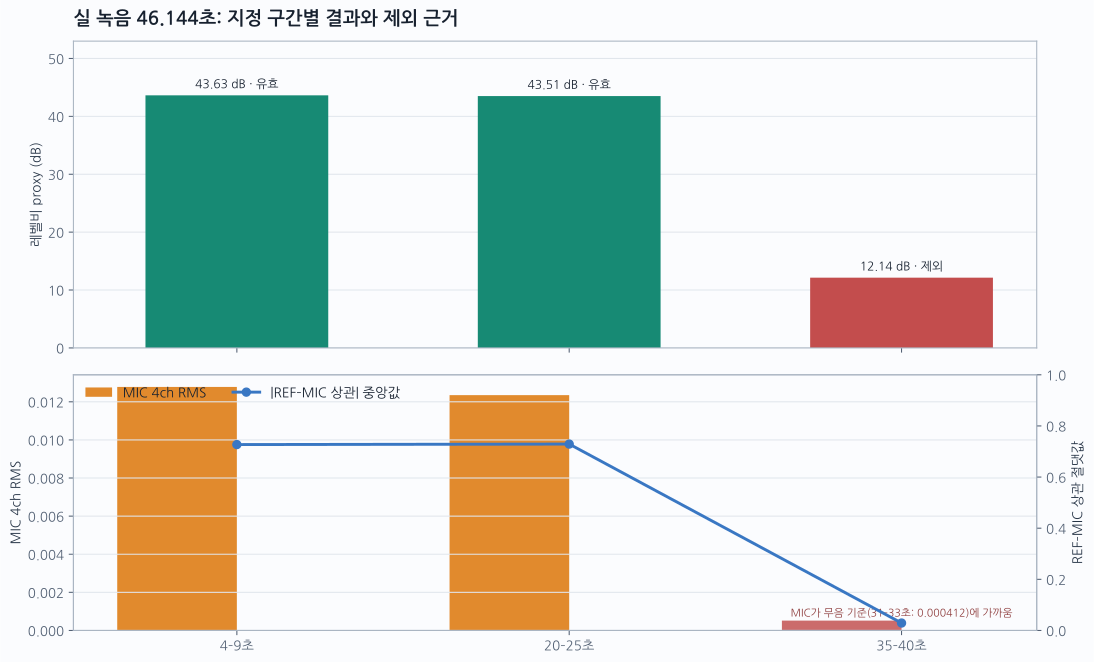
| 구간 | REF RMS | MIC 4ch RMS | Kardome RMS | Proxy | REF–MIC 상관 중앙값 | 판정 |
|---|---|---|---|---|---|---|
| 4–9초 | 0.04677 | 0.01278 | 0.00008418 | 43.63 dB | 0.727 | 유효한 proxy 구간 |
| 20–25초 | 0.04724 | 0.01235 | 0.00008248 | 43.51 dB | 0.729 | 유효한 proxy 구간 |
| 35–40초 | 0.04803 | 0.000515 | 0.00012721 | 12.14 dB* | 0.029 | 입력이 바닥 수준, 제외 |
두 유효 구간의 단순 평균은 43.57 dB다. 35–40초의 MIC RMS는 REF가 비활성인 기준 31–33초의 0.000412와 약 1.9 dB만 차이 난다. 초기 출력 과도 성분 이후 36–40초만 계산하면 30.55 dB이지만 MIC가 여전히 바닥에 있어 이를 유효 AEC 결과로 올리지 않았다. 여기서도 동일 녹음 내부 구간 두 개를 독립 반복 2회로 세지 않는다.
6. 앱 TTS 진단 녹음: 스피커 소리가 실제로 나왔는지
2026-09-23 TTS 진단은 기기 사용자가 스피커 소리를 듣지 못했다고 보고한 상태에서 이뤄졌다. AudioFlinger에는 speaker route와 디지털 출력 프레임이 있었지만, HAL underrun 및 speaker calibration 관련 경고도 남았다. 따라서 REF가 기록됐다는 사실만으로 실제 스피커에서 음향 출력이 났다고 보지 않았다.
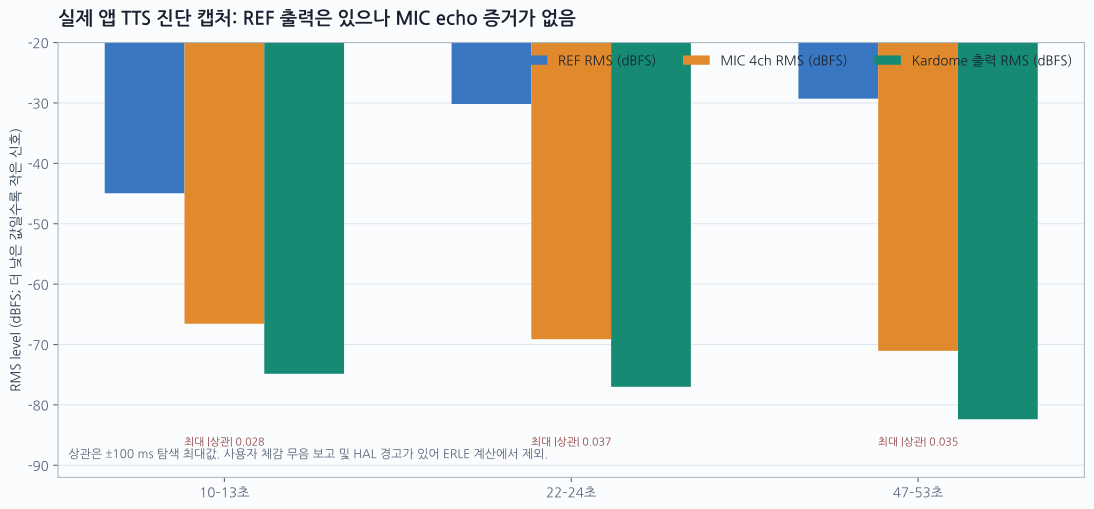
| 캡처 구간 | REF RMS | MIC 4ch RMS 범위 | Kardome 출력 RMS | ±100 ms 최대 상관 |
|---|---|---|---|---|
| 10–13초 | 0.00565 | 0.00047–0.00074 | 0.000181 | 0.0276 |
| 22–24초 | 0.03099 | 0.00035–0.00037 | 0.000141 | 0.0366 |
| 47–53초 | 0.03433 | 0.00026–0.00030 | 0.000076 | 0.0345 |
MIC가 REF와 강하게 맞물리는 echo 성분을 보이지 않고 무음/바닥 수준에 가까웠다. 그러므로 이 캡처는 “AEC가 이 정도 감쇠했다”는 성능 지표가 아니라 스피커·음향 경로의 검증이 필요한 진단 자료다. 세 진단 녹음 모두 v1.1.18로 기록됐지만 TTS 문장 단독·고정 음량·사용자 발화 분리 조건은 충족하지 않았다.
7. Ding/효과음 버전 흐름: v1.1.14 → v1.1.17 → v1.1.18
과거 효과음 시험은 v1.1.14에서 약 34.0 dB, 연속성 패치가 적용된 v1.1.17에서 약 33.1 dB로 기록됐다. 실제 F2 캡처도 v1.1.17 패치 자료이며, 기준 신호 최대 구간 −50.84 dBFS와 처리 출력 −78.33 dBFS 사이에 27.49 dB 차이가 보고됐다. raw MIC와 기준 신호는 약 30–37.5 ms 지연에서 상관을 보였고, 처리 출력과 기준 신호의 상관은 0.04였다.
가장 최근 버전인 v1.1.18에서는 사용자가 실제 Ding echo가 많이 줄었다고 보고했다. 별도의 같은 명령 비교에서는 MIC 대비 출력 레벨 차이가 v1.1.17의 34.96 dB에서 v1.1.18의 39.41 dB로 커졌다. 이 값은 출력 음량 자체가 아니다. 실제 Kardome 출력 RMS는 v1.1.17 −83.54 dBFS, v1.1.18 −86.51 dBFS로 v1.1.18에서 더 작게 기록됐다. 다만 이 한 쌍은 Ding만 따로 반복 측정한 결과는 아니다.
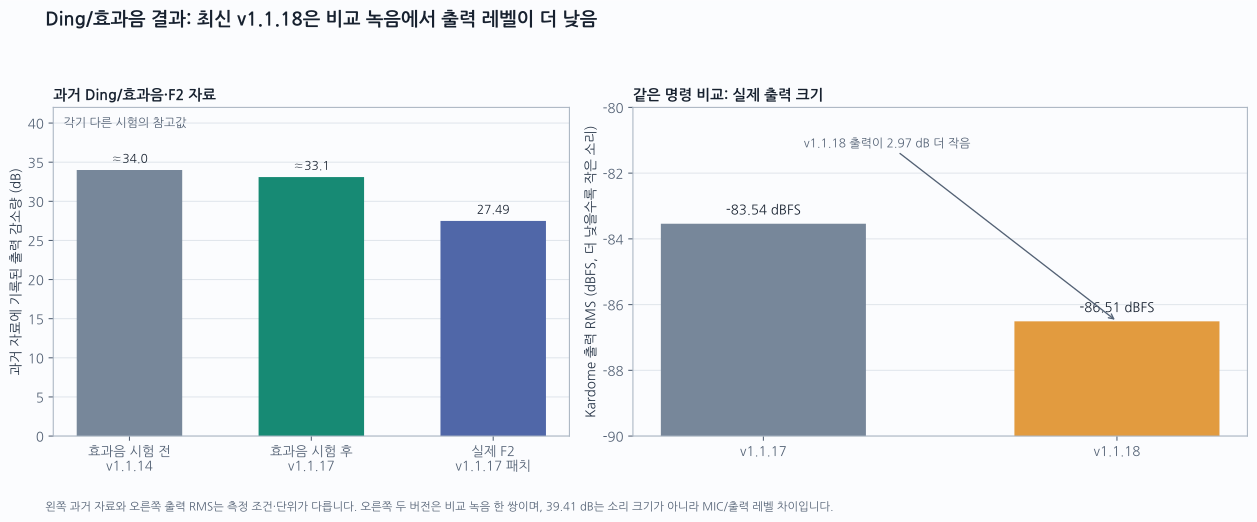
읽는 법: 오른쪽은 같은 명령 비교에서 기록된 Kardome 출력 자체의 크기다. dBFS가 더 낮은 v1.1.18 막대가 더 조용한 출력이다. 왼쪽의 과거 dB 값은 다른 시험에서 계산한 출력 감소량이므로 오른쪽 값과 높이를 직접 비교하면 안 된다. 실제 F2 수치가 확보된 마지막 캡처는 v1.1.17이고, v1.1.18의 Ding echo 감소는 사용자의 체감 보고와 별도 비교 녹음으로 구분해 기록했다.
8. 최종 판단과 숫자의 범위
현재 결론
사용자가 들은 Ding echo 감소와 같은 명령 녹음의 출력 감소 방향을 함께 보면, 이번 실제 사용 조건에서는 Kardome v1.1.18이 v1.1.17보다 더 나은 것으로 판단한다. v1.1.18의 다섯 명령과 실제 녹음에서도 MIC 대비 Kardome 출력이 낮게 관측됐다. 따라서 현장 적용 판단은 v1.1.18을 우선하는 쪽이다.
숫자를 정확히 해석하기
보고서의 dB 수치는 MIC 대비 Kardome 출력 레벨 차이다. 표준 ERLE는 echo 제거 전후의 같은 처리 경로 신호를 비교해야 한다. 이번 계산의 raw MIC 4채널과 Kardome mono 출력 사이에는 빔포밍·전처리·음량 차이가 포함될 수 있어 이 값을 표준 ERLE와 같다고 부르지는 않는다. ITU-T G.168, AEC Challenge
기존 비교 파일은 v1.1.17과 v1.1.18 각각 한 건이며 폴더 이름을 기준으로 분류했다. v1.1.16과 v1.1.18의 직접 비교는 아니다. 지금 자료로는 “이번 Ding 사용 및 보유 녹음에서 v1.1.18이 더 나은 방향을 보였다”고 판단할 수 있고, +4.45 dB를 모든 환경의 고정 개선량이나 표준 ERLE로 해석하지 않는다.
9. 데이터 묶음과 재현 방법
현재 발견된 원본 WAV·동반 로그·분석 문서를 출처별 디렉터리에 복사하고 파일별 SHA-256을 포함한 아카이브를 만들었다. 캡처 원본은 변경하지 않았다. 이 공유 묶음은 내부 작업공간에 보관하며, 공개 Wiki에는 오디오 원본·logcat을 넣지 않고 요약·분석 그래프만 게시한다.
- 묶음 디렉터리:
echo_test/share/kardome_echo_test_bundle_20261008/ - 압축 파일:
echo_test/share/kardome_echo_test_bundle_20261008.zip - 체크섬/파일 출처:
MANIFEST.csv,SHA256SUMS.txt - 1.1.17/1.1.18 분석 재실행:
analysis/compare_kardome_v117_v118.py - 전체 상세 분석 그래프 재생성:
analysis/build_detailed_dataset_charts.py - 이전 통합 결과: SoundFlow/Kardome 원본·Mesh Mini 분석
버전 폴더명은 캡처 파일의 분류 정보이지, 캡처 당시 라이브러리 버전의 런타임 readback은 아니다. 엄밀한 v1.1.16↔v1.1.18 비교에는 v1.1.16 녹음과 실행 당시 버전 증거를 추가해야 한다.