ONDEVICE LMKD 메모리 정밀 분석 — RSS 편차와 SWAP 3GB
먼저 볼 결론
10/19 정리 안내: 이 문서는 초기 조사 기록입니다. 결론·근거·대응을 정리한 통합 보고서와 후속 시험 상세 기록을 우선 확인하세요.
후속 업데이트: TTS ON/OFF와 LLM·NPU Swap 분석을 두 축으로 정리한 최신 페이지를 먼저 읽어주세요. 아래 TTS 세션 재생성·기기 상태는 각 시험 당시 기록입니다. 최신 ON은 매 발화 세션 재생성이 아닌 arena 회수 방식이며, 앱 전체 OFF/ON 비교와 현장 Swap 원인 규명은 미완료입니다.
메모리가 커지는 경로 하나는 찾았습니다: 긴 TTS 처리 뒤 앱이 수백 MiB를 계속 보유합니다. 다만 현장 SWAP 약 3GB와 LMKD 종료의 전체 원인은 아직 확정하지 못했습니다.
| 질문 | 지금 답할 수 있는 결론 | 근거 수준 |
|---|---|---|
| 왜 RSS가 800~1400MB로 달라지나? | 작업에 따른 할당·보유량, RAM에 남아 있는 페이지가 달라진다. TTS만으로도 수백 MiB 차이를 실측했다. | 실측 + 커널 동작 확인 |
| LLM은 NPU인데 왜 RAM이 큰가? | NPU도 시스템 RAM을 사용한다. 약 1.67GiB의 가속기 매핑과 앱의 호스트 메모리를 함께 봐야 한다. | 실기기 매핑 확인 |
| 종료해도 NPU 메모리가 남나? | 이번 1회 정지 시험에서는 큰 버퍼가 사라졌고 재로딩 때 다시 생겼다. | 1회 실측, 장기 보증 아님 |
| SWAP 3GB는 모델 구동에 필수인가? | 아니다. 현재 기기는 모델 로딩 후 SWAP 약 3MiB로 동작했다. 현장의 3GB 보유 객체는 미확인이다. | 현재 실측 / 현장 원인 미확정 |
| RSS를 800MB로 고정할 수 있나? | 현재 보장할 수 없다. 보유량과 동시 실행 peak를 줄여야 한다. 강제 swap으로 숫자만 낮추는 것은 해결 검증이 아니다. | 개선 방향 |
| kill 후 정상 복구된 것인가? | 시험 기기는 재로딩 완료. 현장 10대의 후속 추론 성공은 미확인이다. | 시험과 현장 구분 |
실제로 줄어든 메모리 — 숫자로 보는 핵심 증거
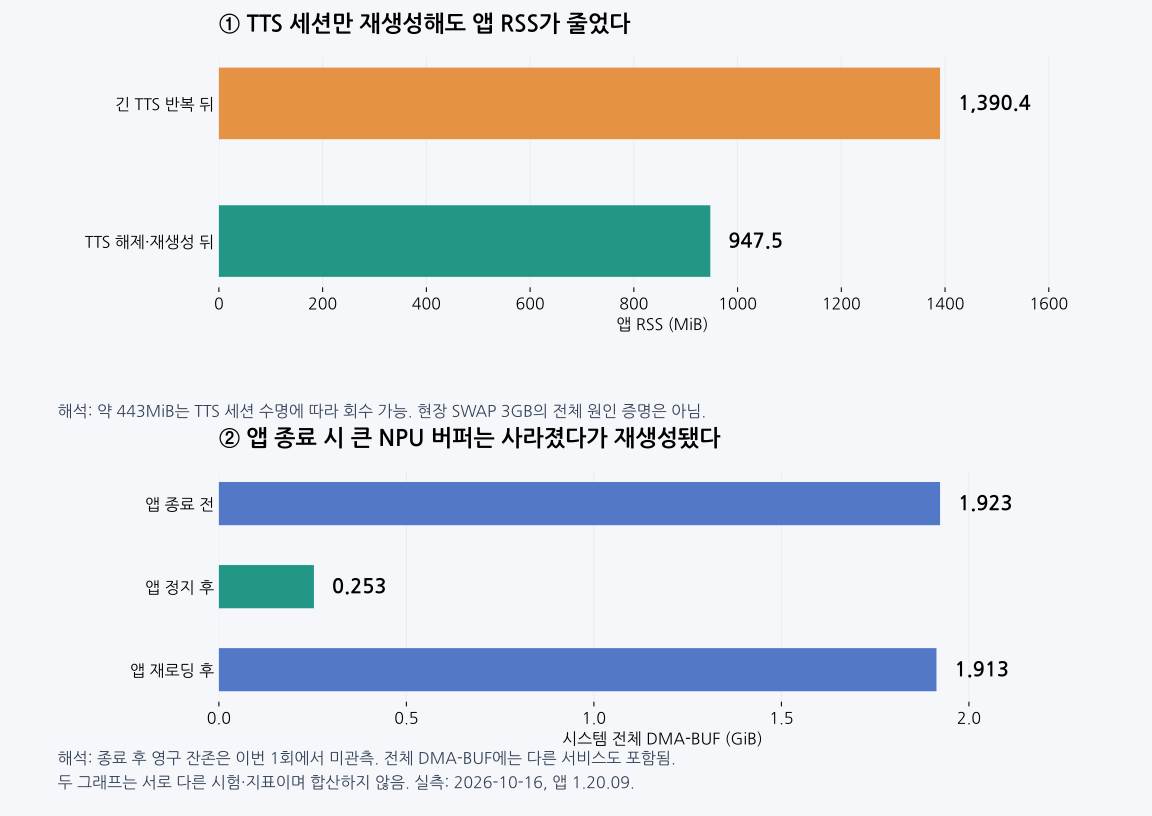
① TTS 결과의 의미: 같은 앱 프로세스에서 TTS만 해제·재생성했더니 RSS가 약 1,390 → 947MiB, 약 443MiB 감소했다. 후속 3회 시험에서도 매회 약 245~247MiB가 회수됐다. 앱의 큰 메모리 중 개선 가능한 부분을 실제로 찾은 것이다. 자동 재초기화 기능을 적용한 상태는 아니다.
② NPU 결과의 의미: 앱 종료 후 약 1.65GiB의 큰 버퍼가 사라지고, 전체 DMA-BUF가 약 1.923 → 0.253GiB로 줄었다. 재로딩 후 약 1.913GiB로 돌아왔다. 이번 조건에서 “종료 후 NPU 버퍼가 계속 남는다”는 설명은 지지되지 않는다. 시스템 전체 수치이므로 차이 전부를 앱 전용 메모리로 계산하지 않는다.
원인은 어디까지 좁혔나?
| 상태 | 원인 후보 / 확인 사항 | 현재 판단 |
|---|---|---|
| 확인됨 | 긴 TTS의 ONNX Runtime 할당·보유 | RSS 수백 MiB 증가를 설명하는 실제 경로를 찾음 |
| 확인됨 | NPU 모델의 큰 공유 RAM 부담 | 시스템 여유를 줄이는 기본 비용. 이것만으로 SWAP 3GB를 설명할 수는 없음 |
| 이번 시험에서 미관측 | 프로세스 종료 뒤 큰 NPU 버퍼가 계속 남음 | 정지 후 소멸 확인. 압박 중 자동 재시작은 별도 검증 필요 |
| 코드상 확인됨 | LLM 해제 반환값을 확인하지 않고 핸들을 지움 | 오류 감지 공백. 실제 해제 실패·누수 발생은 미확인 |
| 검증 중인 가설 | 모델 기본 비용 + 작업 공간 증가 + 다른 서비스 → 압박 → swap-out·LMKD | 현장 장애를 설명할 후보 경로. 아직 전체 연결을 입증하지 못함 |
| 미확정 | 현장 SWAP 약 3GB를 보유한 구체적인 객체·런타임 | TTS·STT·LLM별 장기 할당과 회수를 더 분리해야 함 |
해결 방향 — 무엇부터 검증할 것인가?
- TTS 메모리: 긴 입력 분할과 세션 수명 개선을 비교한다. 회수량뿐 아니라 음질·지연·MediaPlayer 해제를 함께 검증한다.
- LLM/NPU 수명: 같은 PID에서 추론·세션 교체를 반복하며 매핑과 호스트 메모리 증가를 확인한다. 해제 오류 전달과 추론·해제·초기화 직렬화를 점검한다.
- 복구 정책: 압박이 남은 동안 재로딩 peak가 겹치는지 확인한다. 자동 복구 안내음은 무음 정책을 권고한다.
측정 범위: 2026-10-16 시험 기기 앱 1.20.09, QNN 2.34.0 / Genie 1.8.0. 현장 A1_1.8.0과 APK·모델 동일성은 아직 미확인이다. 현장 표는 RSS 887.5~1,470.0MB / SWAP 3,153.6~3,406.1MB이며, 현장 MB와 실측 MiB는 환산 기준이 다를 수 있다. SWAP 표기 3GB는 압축 후 실제 RAM 3GB나 kill 후 반환 RAM 3GB를 뜻하지 않는다.
상세 근거 — 현장 보고와 시험 기록
아래는 위 결론을 검증할 때 읽는 상세 자료다. RSS는 앱 주소 공간의 상주 페이지, DMA-BUF는 공유 버퍼, SWAP은 밀려난 페이지의 논리 계수다. 세 숫자를 단순 합산하지 않는다.
현장 10대와 전체 발생 규모 — 담당자 답변 근거
사용자 최종 정정에 따라 수집 기간은 1주다. 약 2,000대에서 기기당 1~2회 발생했다는 전달 내용은 집계 원본으로 검증하지 않은 상태다. 앞서 언급된 한 달을 발생률 분모로 사용하지 않는다. 전체 최초 장애 건수와 초기화 중 연속 kill 건수는 분리 집계해야 하며, 아래 10대는 전체 기기를 대표하는 무작위 표본이라고 가정하지 않는다. 모든 기기 일련번호는 제외했다.
상세 10대는 A1_1.8.0, CLEANING 6대·READY 3대·MOVING 1대다. 시험 기기의 앱 1.20.09와 현장 APK·모델·런타임 동일성은 미확인이다. 특정 운전 상태만의 문제나 청정 기능이 원인이라고 판정할 수 없다.
| 사례 | 상태 | 첫 kill RSS (표기 MB) | 첫 kill Swap (표기 MB) |
|---|---|---|---|
| D01 | CLEANING | 887.5 | 3,153.6 |
| D02 | CLEANING | 1,227.0 | 3,227.2 |
| D03 | CLEANING | 1,422.7 | 3,256.8 |
| D04 | CLEANING | 1,304.0 | 3,289.8 |
| D05 | CLEANING | 1,403.6 | 3,289.8 |
| D06 | READY | 1,425.0 | 3,267.9 |
| D07 | MOVING | 1,058.6 | 3,406.1 |
| D08 | CLEANING | 1,357.8 | 3,216.8 |
| D09 | READY | 890.0 | 3,268.0 |
| D10 | READY | 1,470.0 | 3,216.5 |
2번 — 복구 성공과 초기화음: D03은 두 번째 kill RSS/Swap이 1,835.2/23.7MB, D09는 307.7/22.6MB다. 첫 kill의 약 3.2GB swap과 크게 달라 재생성 프로세스의 다른 단계일 가능성이 높다. 그러나 PID·개별 kill 시각·모델 생성 완료·실제 추론 성공 로그 없이 정상 복구를 확정할 수 없다. 시스템 압박이 남은 상태에서 초기화 부하가 겹쳤다는 가설을 우선 검증한다. 두 번째 RSS가 낮은 D09는 고정된 앱 RSS 임계값 설명과도 맞지 않는다.
현재 소스 ForegroundService.kt:875는 초기화 끝에 playListeningCompleteSound → 1.2초 대기 → playCreateAnswerCompleteSound를 호출한다. 각 함수는 FIRST_EFFECT/SECOND_EFFECT를 AudioPlayManager.playEffectRing에 넘기고, asset을 MediaPlayer에 설정해 준비 완료 시 재생한다. 이 호출 경로에 재시작 원인·시각 조건은 보이지 않는다. 현장 버전의 동일 동작·실제 가청 여부는 별도 검증해야 한다. 권고 사양은 LMKD 자동 복구 시 무음, 명시적 사용자 초기화 시 안내음 정책 분리이며 아직 구현 변경은 하지 않았다. 초기화 완료 로그와 효과음은 실제 후속 추론 성공의 대체 증거가 아니다.
4번 — 800MB 유지 가능 여부: 첫 kill RSS 범위는 정확히 887.5~1,470.0MB, 차이는 582.5MB다. RSS는 할당량·최근 접근·파일 페이지 회수·swap 이동이 함께 결정한다. 중요도는 kill 대상 선정과 일부 reclaim 정책에 영향을 주지만 RSS를 800MB 또는 1400MB로 직접 지정하지 않는다. 같은 총 메모리가 단지 RSS와 SWAP 사이에서 이동한 것으로만 설명하기도 어렵다. 첫 kill RSS+Swap 지표 합계도 4,041.1~4,693.4MB로 다르다. 이 합계는 실제 물리 RAM 비용이 아니다. 800MB 상한은 현재 보장할 근거가 없고, 강제 swap으로 RSS만 낮추면 지연·압박을 악화시킬 수 있다. native 보유량과 동시 모델 예산을 먼저 줄여야 한다.
5번 — 3GB SWAP: 10대 모두 비슷한 큰 값이므로 단일 기기의 이상치로 처리하면 안 된다. 장기 운전 중 공통으로 유지되는 익명 메모리, allocator/runtime 캐시, 반복 작업 증가와 reclaim을 함께 조사해야 한다. 현재 기기의 zram 4GiB는 시스템 전체 용량이며 앱에 3GB가 예약됐다는 의미가 아니다. 원본 로그와 kill 전 smaps/SwapPss/zram mm_stat 없이 소유 객체나 압축 후 RAM 비용을 확정할 수 없다.
2. 실제로 수행한 조치와 모델 로딩 검증
최초 앱 PID는 3298이고 ForegroundService가 약 2일 2시간 유지되고 있었다. 하지만 Genie 라이브러리만 매핑돼 있고 QNN backend·모델 매핑·FastRPC 연결은 보이지 않았다. 앱 실행 상태만으로 모델 로딩 완료를 판단할 수 없었다.
사용자 요청으로 앱을 재시작한 PID 21885에서도 DeviceController 연결 단계만 진행됐다. DeviceAgent 패키지는 설치돼 있으나 비활성 패키지 목록에 있었고 서비스 resolve가 실패했다. 사용자 승인 후 DeviceAgent를 활성화·시작하고 ONDEVICE를 다시 시작했다. 이 초기화 검증 단계의 PID는 22348이다. 이후 재시작 대조 시험과 TTS 재초기화 시험의 PID는 각 절에서 구분한다. 앱·펌웨어·모델 파일·메모리 정책은 변경하지 않았다. DeviceAgent 활성화로 다른 서비스도 다시 연결되므로 시스템 전체 메모리 변화는 ONDEVICE 단독 증가분으로 계산하지 않는다.
| KST 시각 | 확인한 이벤트 |
|---|---|
| 11:15:52.299 | LLM initialization started |
| 11:15:59.300 | GenieDialog_create 반환값 0 |
| 11:15:59.301 | LLM initialization completed |
| 11:15:59.312 | LLM 초기화·warm-up 로그 7,014ms |
| 11:16:08.938 | 한국어 STT 초기화 완료, 9,396ms |
| 11:16:15.190 | TTS 초기화 소요 6,042ms |
| 11:16:16.073 | Initialization complete. Ready to use! |
| 11:19:49~11:20:00 | 일반 지식 질문 입력 → LLM inference → 함수 분류 응답 → 입력 처리 완료 |
현재 소스의 경로는 ForegroundService.onCreate → DeviceCommunicator 연결 callback → initializeApp → initializeLLAMA → QaClient.Init → JNI → GenieDialog_create다. 로컬 체크아웃의 HEAD는 7b2f23f2이며 작업 중 변경이 있으므로 설치 APK와의 소스 완전 일치는 주장하지 않는다. 위 성공 판정은 설치 앱의 런타임 로그를 기준으로 했다.
3. 측정값 — 같은 이름처럼 보여도 서로 다른 지표
/proc의 kB는 이 보고서에서 KiB로 환산한다. 현장 표의 MB는 원래 표기를 유지한다. 1000/1024 환산 기준과 원본 LMKD 행은 미제공이므로 실측 MiB와 동일 단위로 단정하지 않는다. 각 명령은 순차 조회이므로 서로 수초 이내의 값도 완전히 동시인 스냅샷은 아니다.
| 구간 | VmRSS | RssAnon | RssFile | VmSwap | 의미 |
|---|---|---|---|---|---|
| 모델 미초기화, 11:12:46 | 239.2MiB | 109.0MiB | 128.8MiB | 0 | 모델 부하 비교 기준으로만 사용 |
| 로딩 시작, 11:15:52 | 281.3MiB | 176.8MiB | 103.5MiB | 0 | Genie 생성 시작 |
| 로딩 중, 11:15:57 | 1,155.6MiB | 264.8MiB | 890.0MiB | 3.11MiB | 파일 페이지의 큰 일시 유입 |
| 초기화 끝 무렵, 11:16:15 | 981.7MiB | 876.5MiB | 104.3MiB | 3.11MiB | 파일 RSS는 감소, 익명 메모리는 증가 |
| 초기화 후, 11:16:42 | 950.7MiB | 840.8MiB | 108.9MiB | 2.96MiB | 작업 버퍼·heap 안정화 구간 |
| 대기 표본, 11:17:49 | 889.8MiB | 779.2MiB | 109.5MiB | 2.96MiB | 짧은 대기 관측 시작 |
초기 관측 구간의 VmHWM=1,480,956KiB, 즉 그 시점까지 최고 RSS 1,446.2MiB였다. 후속 질문 시험에서는 이 범위를 넘었다. 로딩 중 RssFile이 약 890MiB였다가 약 104MiB로 줄고, RssAnon은 약 265MiB에서 약 877MiB로 커졌다. 따라서 RSS 변화 전체를 swap으로 이동했다고 설명할 수 없다. 파일 매핑의 회수·해제와 익명 할당 변화가 동시에 발생했다. 어떤 파일 VMA가 감소했는지 로딩 중 smaps를 연속 수집하지 않았으므로 그 786MiB 전부를 모델 파일이라고 단정하지 않는다.
800~1400MB는 큰가, 현재 구조에서 가능한가?
기기 MemTotal=7,464,768KiB로 OS가 보는 RAM은 약 7.12GiB다. 설명을 위해 800~1400을 MiB로 놓으면 전체의 약 11.0~19.2%다(사용자 원본 MB 단위와의 차이는 미확인). 앱 프로세스 하나의 RSS가 이 정도인 것은 분명 큰 비용이며, 다른 서비스와 동시에 사용해야 하므로 메모리 예산 관리 대상이다. 다만 일반 UI 앱과 달리 이 프로세스는 LLM·STT·TTS를 함께 초기화한다.
| 확인 대상 | 크기·비중 | 무엇을 뜻하나 |
|---|---|---|
| 한국어 STT 모델, 설치 APK asset | 241,227,951 bytes ≈ 230.1MiB | 파일 크기. 로딩 후 tensor·작업 공간을 포함한 RAM은 별도 |
| 한국어 여성 TTS 모델, 기기 파일 | 77,069,571 bytes ≈ 73.5MiB | 파일 크기. 생성 길이·런타임 버퍼에 따라 heap이 달라질 수 있음 |
| LLM context binary | 약 1.65GiB | 주된 DSP 매핑과 크기가 가깝지만 CPU heap 소유량과 동일하지 않음 |
| 초기화 직후 Native Heap RSS | 763.0MiB | 앱 주소 공간 상주량의 큰 부분을 실제 native 할당이 차지 |
| 질문 처리 후 Native Heap RSS | 1,074.4MiB | 첫 사용·작업 이후 추가 비용 확인, 소유 runtime은 아직 미분리 |
“수치가 가능한가”에는 예, “제품에서 적정한가”에는 아직 검증되지 않았다고 답한다. 적정성은 장기 반복 후의 안정값, 동시 서비스의 최소 여유 RAM, PSI·swap-in 지연, LMKD 발생 여부로 판단해야 한다. 파일 크기 합계와 RSS의 차이를 모두 낭비로 보지 않으며, 반대로 AI 모델이라는 이유만으로 1.4GB를 정상 승인하지 않는다. DSP·GPU·카메라 메모리도 시스템 예산에 포함하되 CPU RSS와 중복 매핑을 제거해야 하므로 단순 합산한 값을 앱 전용 RAM이라고 제시하지 않는다.
CPU native heap과 그래픽
초기화 직후 dumpsys meminfo의 Native Heap RSS는 781,276KiB(763.0MiB), Heap Alloc은 739,211KiB(721.9MiB)였다. 별도 smaps에서는 Scudo secondary RSS 642,052KiB, primary RSS 138,860KiB가 관측됐다. 주요 CPU 상주 메모리는 Java보다 native allocator 영역이다. Scudo 이름만으로 Genie·STT·TTS 중 어느 객체가 소유하는지 판별할 수 없다. 할당 stack profiling이나 초기화 단계별 비교가 필요하다.
최초 화면은 RiveEmotionActivity, 재시작 후는 MainActivity였다. EGL mtrack은 최초 약 228.8MiB, 재시작 후 약 26.9MiB로 달랐다. 이는 화면 상태도 비교 조건임을 뜻한다. dumpsys TOTAL RSS에는 그래픽 mtrack 등이 더해져 /proc/VmRSS와 다를 수 있으므로 LMKD RSS와 그대로 비교하지 않는다.
질문 처리 후의 native 증가와 대기 중 회수
추가 시험은 제품의 USE_TEXT_INPUT 진입점을 사용했다. 일반 지식 질문 3개에서 LLM inference started → <sk_19>() → cloud 경로 → TTS가 관측됐다. 이는 순수 로컬 LLM만의 부하 시험이 아니라 함수 분류·네트워크·TTS를 포함한 혼합 경로다. 후속 반복에서는 정상 지식 답변 대신 오류 안내 TTS가 출력됐으므로 정상 서비스 성공률을 검증한 시험으로 해석하지 않는다. LLM inference started 로그는 현 소스에서 rule matcher보다 앞에 있어 이 로그 하나만으로 모든 입력의 native GenieDialog_query 실행을 독립 증명할 수는 없다.
| 표본 | RSS 또는 Native Heap RSS | 해석 |
|---|---|---|
| 첫 질문 전 대기 VmRSS | 889.8MiB | 11:17:49 |
| 첫 두 질문 이후 VmRSS | 1,274.7MiB | 11:21:08, 같은 PID |
| 세 번째 질문 후 smaps RSS 합계 | 1,284.5MiB | 순차 측정, VmRSS와 계수 시점 다름 |
| 초기화 직후 Native Heap RSS | 763.0MiB | dumpsys 기준 |
| 세 번째 질문 후 Native Heap RSS | 1,074.4MiB | 약 311MiB 증가 |
| 추가 대기 후 VmRSS | 1,081.0MiB | 11:27:33, 재시작 없이 감소 |
smaps에서 Scudo primary RSS는 138,860 → 385,316KiB, secondary는 642,052 → 714,700KiB로 증가했다. 같은 시기 Java main heap의 RSS 증가는 약 8.7MiB여서 주요 증가 영역은 native다. Native Heap Alloc도 739,211 → 1,194,510KiB로 증가했다. 추론·TTS 첫 사용 이후 큰 heap 보유가 관측됐지만, 이후 일부 RSS가 회수되므로 단순 선형 누수로 단정할 수 없다. 현재 자료로는 TTS/ONNX 작업 공간, allocator 캐시, 다른 native 객체 중 정확한 소유자를 분리하지 못했다.
같은 일반 질문을 추가 5회 입력하고 각 입력 뒤 약 25초 간격으로 관측했다. 동일 PID의 VmRSS는 1,081.0 → 1,087.6 → 1,091.5 → 1,097.3 → 1,292.0 → 1,197.6MiB로 변했고 VmSwap은 2.92MiB로 유지됐다(11:27:33~11:29:49). 작은 증가와 큰 일시 증가·감소가 섞여 짧은 시험에서는 안정된 plateau도 선형 누수도 입증되지 않았다. 이 시험의 오류 안내 TTS는 정상적인 긴 답변 TTS 부하를 대표하지 않는다. 사용자 요청에 따라 후속 시험용 미디어 음량은 9/15에서 2/15로 낮췄다.
혼합 질문과 TTS 단독 반복의 분리 결과
같은 PID에서 11:42~11:46에 일반 질문 3회와 이후 약 60초 대기를 측정했다. 클라우드 정상 답변 대신 오류 안내 TTS가 발생했다. VmRSS는 약 1,187→1,523→1,518MiB, Native Heap RSS는 1,007,016→1,358,792KiB로 약 343.5MiB 증가했다. VmSwap은 약 2.92MiB였고, 모델 재초기화 로그는 관측되지 않았다. 따라서 1400MB는 관측 범위의 상한이나 보장 예산이 아니다.
이어 기존 SPEECH_KEY 경로로 같은 짧은 문장을 TTS만 6회 재생했다. 설치 DEX의 분기와 TTS 출력 완료 로그를 확인했다. 30초 무입력 대조에서 Native Heap RSS는 1,359,780KiB로 같았고, 6회 재생 및 약 60초 대기 후 1,363,240KiB로 3.38MiB 증가했다. Heap Alloc 증가는 약 3.33MiB다. 짧은 TTS 반복만으로 앞선 수백 MiB 증가를 재현하지 못했다. 이미 워밍업된 동일 프로세스의 순차 시험이므로 TTS 첫 사용·문장 길이별 캐시를 배제하는 결과는 아니다. LLM-only, STT-only, 길이별 TTS, 순서 교차 시험과 native allocation stack으로 다음 범위를 좁혀야 한다. 짧은 반복만으로 누수 부재나 1주 안정성을 인증하지 않는다.
NPU/HTP·DMA-BUF — 앱 RSS만으로 보이지 않는 공유 DDR 비용
PID 22348의 FastRPC debugfs는 CDSP cid=3, tgid=22348, context bank 4, smmu.faults=0을 보였다. 앱 FD의 FastRPC 장치 연결과 QNN HTP 라이브러리 매핑도 확인했다.
- 같은 세션에 1,769,996,288 bytes(약 1.648GiB)의 큰 매핑이 있다.
dma_buf/bufinfo에서도 동일 크기 ION DMA-BUF가compute_cb4에 연결되어 있어 크기를 교차 확인했다.- 해당 세션의 표시된 7개 매핑 크기 합계는 약 1.668GiB다. 공유 여부를 무시한 앱 전용 PSS는 아니다.
- 장비 전체 DMA-BUF 합계는 약 1.906GiB다. 카메라·오디오 등 다른 소유자도 포함하므로 앱 전용 값으로 쓰지 않는다.
- 현재 모델 파일은
1,772,657,024 bytes이며 설정은use-mmap=true,context.size=128,spill-fill-bufsize=0이다. 파일 크기·설정값은 실제 할당량 그 자체가 아니다.
드라이버의 debugfs size 포맷은 0x%-20zu로, 문자열 앞에는 0x가 붙지만 값은 십진수다. 이를 16진수로 파싱하면 크기가 크게 잘못된다. VA/IOVA 주소 공간 크기, DMA-BUF 할당 크기, CPU RSS, SWAP은 각각 구분한다. 일반적인 pinned DMA 메모리는 anonymous heap처럼 swap 대상이라고 간주할 수 없다.
NPU 관점 재검토 — 실행 위치와 메모리 계수는 별개다
LLM은 Genie → QNN HTP → FastRPC → CDSP/HTP(NPU) 경로를 사용한다. RSS가 크다는 사실을 CPU에서 LLM 전체를 실행한다는 뜻으로 해석하면 안 된다. 호스트 프로세스는 모델 로딩·토큰 처리·런타임 제어와 STT/TTS 등의 메모리를 보유하며, 가속기는 DMA-BUF 등의 공유 DDR 버퍼를 사용한다. NPU 연산을 사용해도 시스템 RAM 비용이 사라지지 않는다. 여기서 확인한 DDR 버퍼는 별도 전용 VRAM 1.67GiB라는 뜻도 아니다. 모든 연산의 CPU fallback 부재까지 검증한 것은 아니다.
| 구분 | 확인된 사실 | 원인 분석에서의 의미 |
|---|---|---|
| LLM 가속기 경로 | QNN HTP 라이브러리, FastRPC 앱 연결, CDSP cid=3·context bank 4 | CPU-only LLM이라는 전제로 분석하지 않음 |
| 가속기 공유 버퍼 | 최초 PID 22348과 재검토 PID 569 모두 7개 매핑, 합계 약 1.668GiB | 큰 기본 시스템 메모리 부담. 전체가 앱 전용 물리 사용량이라는 뜻은 아님 |
| 호스트 RSS | 재검토 PID 569에서 982,788KiB(약 959.8MiB) | NPU 버퍼 크기와 별개의 계수. 두 값을 그대로 더하면 중복 가능 |
| 호스트 SWAP | 같은 스냅샷에서 3,060KiB(약 3.0MiB) | 큰 NPU 매핑이 존재해도 앱 SWAP 3GB는 필수가 아님 |
| TTS 세션 | 같은 PID의 TTS 재생성에서 수백 MiB RSS 회수 | 호스트 증가분 중 회수 가능한 TTS 경로가 존재. NPU 원인 전체를 배제하지 않음 |
현재 가장 타당한 작업 가설은 “큰 모델·서비스 기본 상주 비용 위에 호스트 작업 공간의 증가가 겹치고, 시스템 압박이 익명 페이지의 swap-out과 LMKD를 유발한다”이다. NPU 버퍼 자체가 앱 VmSwap 3GB로 이동했다는 설명과는 구분한다. 실제 현장에서는 어느 구성 요소가 증가했는지, 무엇이 최종 압박을 만들었는지 아직 연결하지 못했다. 따라서 이 가설을 확정 원인으로 보고하지 않는다.
NPU 버퍼가 DDR 여유를 줄이면 다른 swap 가능한 익명 페이지가 밀려날 수 있다. 이 간접 경로 때문에 NPU와 SWAP을 별개 문제로 배제해서도 안 된다. 반대로 메모리 압박만으로 원래 없던 익명 데이터 3GB가 생성되는 것은 아니므로, 앱이 어떤 데이터를 보유했는지는 별도 조사해야 한다. RSS + FastRPC map 합계 + Swap을 실제 사용 RAM으로 계산하지 않는다.
이번 재검토의 직접 근거: npu-review-current.txt에서 PID 569, CDSP 연결, smmu.faults=0, 동일한 7개 매핑을 다시 확인했다. 최초 PID 22348과는 다른 프로세스이며, 두 시점의 크기 일치는 장기 누수 부재나 LLM 반복 시 안정성을 보증하지 않는다. 직전 TTS 시험 후에도 NPU 매핑이 존재한다는 확인이지, TTS 전후 NPU 메모리를 연속 측정한 대조 시험은 아니다. 플랫폼 kernel/msm-5.4/drivers/char/adsprpc.c:1446–1577은 DMA-BUF 참조·attach·map 경로, 1290–1353은 해당 분기의 unmap·detach·put 및 DMA 해제 경로를 보인다. 해제 코드가 존재한다는 것과 현장 kill 후 실제 회수가 완료됐다는 것은 별도 증거다.
해결 방향과 검증 기준: 호스트는 긴 TTS 입력 분할과 세션 수명 개선을 우선 대조 시험하고, NPU는 LLM-only 반복·해제/재로딩 전후의 매핑 개수·크기·DMA-BUF 참조·여유 RAM을 확인한다. 재초기화 중 이전 context와 신규 context가 겹치는지도 확인한다. 이를 다른 서비스 병행 시점의 PSI·reclaim·zram 변화와 맞춰야 한다. SDK 업그레이드나 모델 축소가 해결책이라고 미리 단정하지 않는다. RSS 800MB 고정 대신 전체 시스템의 최고 사용량·회수 가능량·응답 지연·재초기화 성공을 제품 예산으로 관리해야 한다.
문서 정정: 이전 본문은 CPU native를 최우선 조사 대상으로 표현해 NPU 공유 DDR 부담을 충분히 강조하지 못했다. TTS 실측 결과는 유지하되, 조사 범위를 호스트·NPU·시스템 전체로 명시적으로 바로잡았다.
추가 실기기 시험 — 프로세스 종료 시 NPU 버퍼가 남는가
1회 정지·재시작 대조에서 큰 NPU 버퍼는 실제로 사라졌다가 재생성됐다. 2026-10-16 13:54 KST에 앱 PID 569를 am force-stop하고 약 3초 뒤 관측한 다음, 기존 Activity·ForegroundService 진입점으로 재시작했다. 강제 메모리 압박이나 LMKD 발생을 유도한 시험은 아니다. STREAM_MUSIC은 2/15로 유지했다.
| 측정 단계 | 앱 PID | 1,769,996,288-byte 버퍼 | 시스템 전체 DMA-BUF | MemAvailable |
|---|---|---|---|---|
| 종료 전 | 569 | DMA-BUF와 FastRPC 목록에 존재 | 2,064,801,792 bytes | 1,629,728KiB |
| 정지 후 | 없음 | 두 목록에서 사라짐 | 272,162,816 bytes | 4,315,044KiB |
| 재로딩 후 | 8345 | 같은 크기의 버퍼 재등장 | 2,054,541,312 bytes | 1,762,544KiB |
종료 전후 시스템 DMA-BUF 차이는 1,792,638,976 bytes(약 1.670GiB)다. 이 차이와 개별 큰 버퍼 소멸은 NPU 관련 메모리가 회수됐다는 근거를 함께 제공한다. 다만 시스템 전체 차이는 동시 서비스의 영향도 포함하므로 모든 byte를 앱 전용 회수량으로 단정하지 않는다. MemAvailable은 약 2.56GiB 증가했으나, RSS와 DMA-BUF를 더한 정확한 회수량으로 해석하지 않는다.
재시작 PID 8345에서는 LLM 초기화 완료, STT 초기화 완료, TTS sample rate 22050 초기화 성공, 전체 준비 완료 로그를 확인했다. 별도의 사용자 요청에 대한 로컬 추론 성공까지 검증한 결과는 아니다. 로그 수집 중 UTF-8 디코딩 오류가 한 번 발생해 수집기를 보완하고 같은 PID의 버퍼 로그와 스냅샷을 재수집했다. 기기를 다시 재시작하거나 실패한 초기화로 계산하지 않았다.
좁혀진 판단: 이 시험 조건에서 “프로세스가 종료돼도 약 1.65GiB의 NPU 버퍼가 항상 남는다”는 가설은 지지되지 않는다. 반면 메모리 압박 상태의 즉시 자동 재시작, 장기 운전 후 종료, 같은 PID 안의 LLM 세션 교체는 아직 별도 시험 대상이다. 정지 상태를 둔 이번 시험으로 현장 초기화 중 재차 kill이나 일시적인 구·신 context 중첩을 배제할 수 없다.
근거 파일: npu-lifecycle-before.txt, npu-lifecycle-stopped.txt, npu-lifecycle-reloaded.txt, npu-lifecycle-reload-log.txt, npu-lifecycle-result.json. 원시 로그는 공개하지 않고 측정값만 기록한다.
종료 경로와 같은 PID 재초기화 경로는 다르다
플랫폼 소스의 종료 경로는 fastrpc_device_release → fastrpc_file_free → DSP 프로세스 종료 요청 → context/cache 정리 → fastrpc_mmap_free(map, 1) → session 해제다. adsprpc.c:1283 주석과 분기는 프로세스 종료 시 일반 매핑의 참조가 남아도 정리를 진행하도록 명시한다. remote heap/persistent 분기는 별도 규칙을 사용하므로 모든 버퍼가 무조건 즉시 사라진다고 일반화하지 않는다. 이번에는 실제 큰 버퍼 소멸을 별도로 확인했다.
새로 확인한 코드상 취약점은 같은 PID의 LLM 해제 실패 감지가 없다는 점이다. 설치된 libLlama2Genie.so의 DsDialog::UnInit 디스어셈블리 0x5e0c4는 GenieDialog_free를 호출하고, 반환값 분기 없이 0x5e0cc에서 핸들을 0으로 쓴다. 설치 DEX의 restartLLM은 QaClient.UnInit(): void 다음에 initializeLLAMA를 호출한다. 따라서 이 경로는 해제 성공 여부를 상위 계층에 전달하지 못한다. 현재 소스 main.cpp:254–276도 최종적으로 핸들을 비우며, QaClient.java의 해제 API는 void다.
이것은 확인된 오류 감지 공백이지, 현장에서 Genie 해제가 실제 실패했다거나 NPU 누수가 발생했다는 증거는 아니다. 해제 실패 시 핸들을 단순 재사용·재해제해도 안전하다는 의미도 아니다. 개선 후보는 런타임 계약에 맞는 오류 처리, 해제 결과 전달, 진행 중 추론과 초기화·해제의 직렬화, 실패 시 재생성 제어다. 정상/실패 경로를 검증한 뒤 적용해야 하며 이번에는 제품 코드를 변경하지 않았다.
다음 우선순위: 프로세스 종료 후 영구 잔존을 먼저 의심하기보다, (1) 같은 PID의 반복 LLM 추론·세션 교체에 따른 호스트 할당과 NPU 매핑 변화, (2) 긴 TTS 작업 공간의 유지, (3) 시스템 여유가 회복되기 전 재로딩 peak를 구분해서 검증한다. IOVA 주소 공간 크기를 물리 RAM 예약량이나 SWAP 원인으로 치환하지 않는다.
4. SWAP 3GB의 정확한 해석
실제 swap backend는 /dev/block/zram0이고 논리 용량은 4,194,300KiB(거의 4GiB), 압축 알고리즘은 lzo-rle, vm.swappiness=100이다. 100은 RAM의 100%를 swap한다는 뜻이 아니며, reclaim 때 익명 페이지와 파일 페이지 사이의 상대 비용 정책이다.
초기화 직후 zram은 다음 값을 보였다. 이 값은 시스템 전체이며 앱 전용이 아니다.
| 지표 | 값 | 뜻 |
|---|---|---|
/proc/swaps Used |
38,836KiB | 사용 중인 논리 swap 공간 |
orig_data_size |
38,256,640 bytes | zram에 저장된 압축 전 데이터 |
compr_data_size |
9,392,184 bytes | 압축 데이터 크기 |
mem_used_total |
10,215,424 bytes | allocator overhead 포함 실제 zram RAM 비용 |
이 스냅샷의 orig_data_size / mem_used_total은 약 3.75다. 이 비율로 과거 3GB의 실제 RAM 비용을 계산하면 안 된다. 데이터 패턴·압축 불가 페이지·단일값 페이지·단편화에 따라 변한다. 예를 들어 압축 전 3GiB가 실효 3:1로 저장되면 대략 1GiB RAM을 사용할 수 있지만 이는 설명용 가정이다.
LMKD의 to free ... kB rss, ... kB swap은 AOSP 구현상 kill 대상의 RSS와 swap 계수를 사용한 로그이며, kill 후 시스템 가용 RAM 증가를 실측한 값이 아니다. 공유 RSS, page cache, swap slot 공유, zram 회수 시점 때문에 RSS+SWAP을 실제 반환 RAM으로 더하면 안 된다. 장비 vendor LMKD와 AOSP의 완전 동일성은 별도 확인 대상이다.
VmSwap은 private anonymous swap 계수다. smaps SwapPss는 공유되는 swap 페이지를 비례 분담한다. 이번에도 VmSwap≈3.1MiB와 SwapPss≈0.09MiB가 크게 달랐으며, zygote/fork로 공유되는 페이지 등 계수 차이를 주의해야 한다. 3GB 원본도 어떤 지표인지 먼저 확인해야 한다. 단순 VmSize 예약이나 clean file mmap 크기를 swap 사용량으로 해석하지 않는다.
5. 왜 kill 시점의 RSS가 800~1400MB로 다른가
중요도가 RSS 계수식을 직접 바꾸지는 않는다. RSS는 실제 RAM에 상주하는 페이지의 합계다. 시스템 압박은 clean file page 회수·anonymous swap-out으로 RSS를 낮출 수 있고, 앱이 페이지에 다시 접근하거나 새 버퍼를 쓰면 RSS가 증가할 수 있다. 중요도는 주로 kill 대상 선정에 영향을 주며, 백그라운드 상태에 따른 compaction 같은 정책을 통해 간접적으로 상주량에 영향을 줄 수도 있다.
LMKD는 이 앱의 RSS가 특정 고정값을 넘었다는 이유만으로 종료시키는 장치가 아니다. 시스템 메모리 압박을 감지하고, 종료 가능한 중요도 범위에서 대상을 고른다. 따라서 800MB와 1400MB는 서로 다른 시점의 대상 프로세스 상태이며, 앱별 kill 임계값의 최저·최고를 뜻하지 않는다.
Android 13 QSSI 소스의 system/memory/lmkd/lmkd.cpp를 확인했다. kill_one_process는 2943~2961행에서 /proc/PID/status를 읽고 VmRSS, VmSwap을 파싱한 후 2996~3004행에서 to free ... kB rss, ... kB swap을 출력한다. find_and_kill_process 3041~3055행은 oom_score_adj가 큰 쪽부터 허용 범위를 순회하고, 조건에 따라 같은 중요도에서 큰 프로세스를 선택한다. 숫자는 종료 전 계수이며, 실제 RAM 반환량 측정치가 아니다. 로컬 소스와 설치 바이너리의 동일 해시는 아직 대조하지 않았다.
실기기는 Android 13/API 33이며 LMKD의 열린 FD에서 /proc/pressure/memory를 확인했다. 현재 앱 oom_score_adj=0도 확인했지만 이는 현 화면·서비스 상태의 값이고 과거 kill 때의 값은 아니다. sys.lmk.minfree_levels 속성 존재만으로 legacy minfree 모드가 활성화됐다고 판단하지 않는다. 현재 PSI avg10/60/300은 모두 0이었고, 확인 가능한 앱 종료 이력 두 건은 이번 시험의 force-stop이었다. 과거 LMKD kill 원문은 이 기기의 현재 로그·종료 이력에서 확보하지 못했다.
| 편차를 만드는 축 | RSS·SWAP에 미치는 영향 | 이번 증거 |
|---|---|---|
| 실행 단계·할당량 | 모델 로딩·질문·TTS 후 메모리 보유량이 달라짐 | 파일 RSS 급증, native 증가·일부 회수 실측 |
| 최근 접근한 페이지 | 대기 중 cold heap이 swap-out되면 RSS가 낮아질 수 있고, 재사용 시 swap-in | 일반 메커니즘. 현재 큰 swap-out은 재현 안 됨 |
| 다른 서비스의 부하 | 동일 앱 상태라도 시스템 압박 발생 시점이 달라짐 | Vision/QNN·카메라 등 병행 서비스 확인 |
| 프로세스 중요도·다른 후보 | 어느 수준의 압박에서 이 앱까지 종료 후보가 되는지 달라짐 | 현 소스의 adj 선택 경로 확인, 과거 adj 미확보 |
예를 들어 설명용 가정으로 RSS 1.4GB + swap 2.6GB와 RSS 0.8GB + swap 3.2GB는 둘 다 4GB로 보일 수 있다. 이는 같은 보유 메모리의 상주 위치가 바뀐 가능성을 설명할 뿐이다. 실제로는 file RSS·공유·SwapCached·할당/해제도 변하므로 RSS+VmSwap만으로 누수나 정확한 소유량을 판정하지 않는다. 동일 PID의 VMA별 Pss+SwapPss, Anonymous, native 할당량과 함께 판단한다.
현장 표의 약 3.2GB가 LMKD의 VmSwap 계수라면 당시 앱에 계상된 큰 익명 페이지 집합의 존재를 추적해야 한다. 빈 가상주소 예약, 모델 파일 크기, zram 4GiB 설정값만으로 이 숫자가 생기지는 않는다. 표의 숫자와 MB 표기는 확보했으나 원본 필드·환산 기준은 추가 확인 대상이다.
SWAP은 왜 커지고, 왜 다시 줄어드나?
- 증가: 이미 할당·접근한 익명 페이지가 cold 상태가 되어 reclaim되거나 앱 compaction의 page-out 대상이 되면 증가할 수 있다. 앱이 계속 새 native 메모리를 보유하면 내보낼 페이지 집합 자체도 커진다.
- 감소: 페이지 재접근에 따른 swap-in과 swap entry 해제, 영역 해제·unmap, 프로세스 종료 등으로 줄 수 있다. swap cache 때문에 swap-in과 slot 반환이 완전히 같은 시각에 일어나지는 않는다.
- 자동 초기화되지 않음: 시스템 RAM에 여유가 생겼다고 모든 cold page를 즉시 RAM으로 복귀시키지는 않는다. 장기 대기에서 큰 swap 계수가 남을 수 있다. 누적 I/O 바이트 통계가 아니라 그 시점의 페이지 계수다.
- 물리 RAM 비용은 별도: 3GiB 논리 swap의 압축률이 나쁘면 zram 자체가 RAM을 많이 사용한다.
mem_used_total과 압축 전 크기를 함께 봐야 한다. 앱별 VmSwap만으로 앱별 압축 RAM 비용을 정확히 배분할 수 없다.
실기기의 use_compaction=true, compact_action_2=anon, cached adj 범위 900~999를 확인했다. 시스템 전체 full compaction은 12회였지만, 현재 ONDEVICE PID는 lastCompactTime=0, lastCompactAction=0이다. QSSI CachedAppOptimizer JNI는 anonymous page-out에 MADV_PAGEOUT 경로를 사용한다. 따라서 background compaction은 과거 대기 중 swap 증가의 가능한 경로지만 현재 프로세스에 적용됐다는 증거는 없다.
원인 후보와 확인·반증 방법
| 원인 후보 | 왜 가능한가 | 확인할 증거 | 현재 판정 |
|---|---|---|---|
| 장기 대기 중 cold anonymous page 이동 | 여러 서비스가 RAM을 요구하면 최근 접근이 적은 앱 heap이 zram으로 이동 가능 | RssAnon 감소와 Swap 증가, 비슷한 Pss+SwapPss, 시스템 reclaim·PSI 동반 |
환경 설명과 부합하나 3GB 사례 미확인 |
| 실제 보유 익명 메모리 증가 | STT/LLM/TTS 버퍼·캐시·일시 복사본이 계속 남으면 swap 가능한 원본 자체가 커짐 | smaps VMA별 Anonymous, Private_Dirty, Swap, native heap 증가 |
질문 처리 후 native RSS 약 311MiB 증가와 이후 일부 회수 확인. 장기 증가 미확인 |
| 해제 후 allocator가 페이지 보유 | 객체는 free돼도 allocator가 arena·캐시를 즉시 OS에 반환하지 않을 수 있음 | Heap Alloc 감소에도 resident+swap 유지, allocator/profile 비교 | 누수와 구분 필요 |
| 모델 재초기화·세션·버퍼 누수 | 반복 초기화 후 이전 native 자원을 잃으면 사이클마다 잔류량 증가 | 반복 전후 plateau, 핸들·FD·DMA-BUF·FastRPC map 증가, allocation stack | 이번 1회 초기화만으로 판단 불가 |
| 시스템 전체 압박 | 카메라·Vision·LiveView·DeviceAgent 등 동시 상주가 회수를 유발 | 프로세스별 PSS, DMA-BUF, MemAvailable, PSI, pgscan·pswpout |
다른 서비스·DMA-BUF 존재 확인. kill 당시 원인은 미확정 |
| 계수·로그 해석 차이 | RSS, mtrack, VmSwap, SwapPss는 동일하지 않음 | 원본 kill 로그·동시 smaps·zram 전후 비교 | 반드시 적용할 해석 원칙 |
단순히 오래 대기했다고 새 메모리 3GB가 저절로 생기지는 않는다. 커널은 이미 내용이 있는 익명 페이지 등을 swap으로 옮긴다. 따라서 앱 VmSwap 약 3GB가 정확하다면 당시 상당량의 익명 페이지가 있었거나 공유 swap 계수 효과가 있었다는 뜻이다. 현재 앱이 swap할 수 있는 메모리가 장기 운전에서 어떻게 늘어나는지 확인해야 한다. 현재 0.9GiB CPU RSS와 1.67GiB DSP 버퍼만으로 과거 3GB를 설명했다고 결론내리지 않는다.
6. 해결방안 — 확인된 원인에 따라 적용
| 우선순위 | 조건 | 조치 | 통과 기준 |
|---|---|---|---|
| P0 | 현재 진단의 신뢰성 | kill 로그 원문, 앱 빌드·PID·시각, status/smaps_rollup, zram, PSI를 같은 시간축으로 보존 |
같은 지표·단위로 비교 가능 |
| P1 | native heap이 반복 동작 후 계속 증가 | Genie/STT/TTS init/free 소유권·중복 초기화·취소/실패 해제 경로 추적. allocator stack profiling으로 큰 할당 소유자 특정 | 동일 작업 반복 후 잔류 메모리 plateau, FD/맵 증가 없음 |
| P1 | 대형 cold buffer가 정상적으로 남음 | 재생성 가능한 버퍼 수명 단축, 모델 입력 복사·불필요한 캐시 축소, clean file mapping 유지 가능성 검토 | 메모리 감소와 함께 STT/추론/TTS 지연·정확도 유지 |
| P1 | DSP와 다른 서비스의 동시 상주가 압박 | 모델/카메라/Vision 수명과 동시 실행 예산 수립. 필요 시 비필수 모델 지연 로딩·유휴 해제 검토 | peak memory와 지연, 재초기화 성공, 오디오 연속성 함께 검증 |
| P2 | 정상 cold page 이동인데 swap-in 지연이 문제 | 실행 프로세스·cgroup별 정책을 검토하고 실제 latency로 평가 | PSI·major fault·음성 응답 지연 개선. 다른 프로세스 kill 증가 없음 |
| P2 | 정책 자체가 부적합하다는 증거 확보 | swappiness·zram 용량·LMKD 정책을 BSP 기준에서 조정 | 장기 혼합 부하에서 kill/지연/전력 모두 검증 |
SWAP을 0으로 만들기 위해 swapoff, swappiness 급감, LMKD 약화, oom_score_adj 보호만 먼저 적용하면 다른 프로세스 kill이나 지연을 악화시킬 수 있다. 현재 값이 100이라는 이유만으로 정책 오류라고 판단하지 않는다. 주기적 앱 재시작은 임시 완화일 수 있으나 누수 수정의 근거가 되지 않는다. 이번 작업에서는 이 정책을 변경하지 않았다.
7. 장기 검증 절차와 남은 범위
- 모델 초기화 완료 로그와 모델 backend 연결을 기준점으로 삼는다. 앱 실행 여부만으로 시작점을 잡지 않는다.
- 대기·로컬 추론·STT/TTS·기존 제품 서비스 병행을 구분해
VmRSS,RssAnon,RssFile,VmSwap,Pss,SwapPss, native heap, DSP map/FD, zram을 수집한다. - 동일 작업 종료 후 고정된 안정화 시간을 두고 최소 수십 사이클의 잔류량을 비교한다. 고주기 smaps는 부하가 있으므로 가벼운 status 샘플과 이벤트 시점 smaps를 나눈다.
- 실제 서비스 시간 규모에 맞춰 수시간~수일 대기를 관측한다.
MemAvailable, PSI,pswpin/out, page scan/refault, LMKD reason과oom_score_adj를 함께 본다. - kill 전후의 zram
mem_used_total, 다른 프로세스 메모리, shared mapping을 비교한다. SWAP 논리 반환량을 물리 RAM 회수량으로 바꾸지 않는다. - 문제가 있는 영역을 특정한 뒤 한 가지 수정만 적용하고 동일 빌드·동일 화면·동일 모델·동일 workload로 재시험한다.
이번 분석은 장기간 서비스 환경의 3GB 현상을 재현하거나 누수를 부정하는 시험이 아니다. 확정된 것은 초기 모델 미로딩 상태의 원인, 모델 로딩 성공, 큰 RSS 변동, CPU native heap과 DSP 메모리의 분리, zram의 실제 사용 방식이다. 3GB 발생 시점의 원본 로그와 영역별 메모리 없이는 원인을 확정할 수 없다.
8. 플랫폼·QNN 교차 분석 — 실행 버전을 기준으로 판단
실행 버전과 파일 일치 확인
| 대상 | 기기에서 확인한 값 | 로컬 대조 |
|---|---|---|
| QNN HTP | AISW_VERSION: 2.34.0, build v2.34.0.250424201103_119471 |
QSSI vendor/quber/thirdparty/maumai/LLM-SO/libQnnHtp.so와 SHA-256 일치 |
| Genie | 초기화 로그 Using libGenie.so version 1.8.0 |
같은 플랫폼 prebuilt libGenie.so와 SHA-256 일치 |
| 제공 SDK 2.44.0.260225 | Genie header API 1.16.0 |
기기의 두 라이브러리와 해시 불일치. 실행 버전으로 간주하지 않음 |
| Qualcomm post-boot 정책 스크립트 | 기기 /vendor/bin/init.qcom.post_boot.sh |
UM device/qcom/common/rootdir/etc/init.qcom.post_boot.sh와 SHA-256 일치 |
실행 QNN/Genie 라이브러리의 공개 SDK 내부 구현 전체는 제공된 source tree로 확인할 수 없으므로, 정확한 내부 할당 소유권은 native profiling 또는 vendor 진단이 필요하다. 2.44 문서는 공통 API·구조의 보조 자료이고 2.34의 기본값·버그·버퍼 수명을 그대로 증명하지 않는다.
zram 4GiB와 swappiness 100은 어디서 설정됐나?
해시가 일치하는 post-boot 스크립트의 818~865행은 2GB 초과 장비의 zram을 RAM 등급의 50%, 최대 4096MiB로 설정한다. 이 기기의 약 7.12GiB MemTotal은 스크립트에서 8GB 등급으로 계산되므로 4096MiB가 된다. 1059~1067행에서는 swappiness 100을 쓰고 zram 설정 함수를 호출한다. 기기 disksize=4,294,967,296 bytes, global/memcg swappiness 100과 일치한다. 앱의 memory cgroup은 root /다. 즉 현재는 앱 전용 swap 3GB 예약 정책이 확인된 것이 아니라 시스템 공통 zram 정책이다.
Genie/HTP 설정은 무엇을 설명하는가?
현재 설정 use-mmap=true, mmap-budget=0, spill-fill-bufsize=0, context 128을 확인했다. SDK 2.44 문서는 use-mmap을 context binary 파일 매핑, mmap-budget을 chunk 단위 매핑 예산, spill-fill을 HTP 작업 공간용 사전 할당으로 설명한다. 이 설명은 파일 로딩 peak와 DSP 작업 공간을 구분하는 데 유용하지만, 2.34에서 값 0의 구체적 의미·기본값을 2.44 설명으로 단정하지 않는다. mmap-budget을 임의 변경하거나 2.44 라이브러리만 교체하지 않았다.
현재 약 1.65GiB context와 약 1.65GiB 대형 DMA-BUF의 크기가 부합한다. 초기 RssFile peak도 context 로딩과 시간상 겹친다. 그러나 DMA-BUF 크기를 anonymous VmSwap으로 바꾸어 설명할 수 없다. file mmap을 했다는 사실만으로 파일 내용 전부가 app heap에 중복 보유됐다고 단정할 수도 없다.
2.44 release notes에는 여러 메모리 수정이 있으나 조건이 다르다. 예를 들어 profiling 활성화 시 HTP 반복 추론 누수 수정, LoRA 관련 수정, use-mmap=false 조건의 로딩 누수 수정은 각 조건의 일치 여부부터 확인해야 한다. 현재 use-mmap은 true이며 LoRA 사용 증거는 없다. 업그레이드가 이번 3GB 현상을 해결한다는 근거는 아직 없다.
모델 파일과 사용 방식 정밀 검사 — 새로 확인한 차이
실기기의 /system/etc/model과 QSSI vendor/quber/thirdparty/maumai/system_etc_model을 SHA-256 비교했다. context binary·tokenizer·LLM JSON은 불일치, HTP backend JSON은 일치했다. binary 크기는 소스 1,772,616,064 bytes, 기기 1,772,657,024 bytes다. SHA 불일치는 파일 손상 증거가 아니라 서로 다른 산출물이라는 증거다. 승인된 배포 manifest와 비교하기 전에는 어느 쪽이 올바른 릴리스인지 판정할 수 없다.
| 설정 | 소스 산출물 | 기기 산출물 |
|---|---|---|
| n-vocab | 128304 | 128313 |
| bos-token | 128302 | 128311 |
| max-num-tokens | 127 | 128 |
| tokenizer added_tokens 개수 | 304 | 313 |
EOS 목록도 다르고 tokenizer truncation은 소스의 설정 객체에서 기기의 null로 달라졌다. 기기 tokenizer의 고유 token ID 수는 128313, 최대 ID는 128312로 기기 n-vocab과 일치하며 설정 BOS/EOS ID도 존재한다. 이 정적 일관성 검사는 token 의미·학습 모델과 tokenizer의 정확한 쌍·binary 변환 정확성·장문 처리의 정상 여부를 보증하지 않는다. JSON 변경만으로 binary 내부 tensor shape나 변환 버전을 추정하지 않는다.
현재 native 소스는 전역 g_dialog 하나를 사용하고 DsDialog::Init에서 기존 handle을 확인하며, 후속 Query 전에 GenieDialog_reset을 호출한다. 따라서 소스만 보고 매 질문마다 모델이 무조건 추가 로딩된다고 말할 수 없다. 반면 reset 반환값 처리, 동시 Init/Query/UnInit 직렬화, 실패 시 handle 소유권과 오류 전파는 검사 대상이다. 설치 native binary와 이 소스의 완전 일치 및 실제 동시 호출은 아직 증명하지 않았다. GenieDialog_free 두 행은 전처리 분기이므로 중복 free로 오판하지 않는다.
다음 판정 순서는 (1) 현장 APK·Genie/QNN·LLM/STT/TTS·tokenizer hash manifest 확정, (2) 승인된 모델 조합과 token/shape/변환 도구 버전 대조, (3) 순수 LLM·STT·TTS별 반복 및 긴 입력 경계 시험, (4) native 할당 stack·해제·DSP 매핑 개수 추적, (5) 동일 릴리스로 최소 1주 운전과 병행 작업 재현이다. 모델 교체나 SDK 업그레이드는 이 결과에 따른 대조 시험으로 수행해야 한다. 현재 결과로 모델 자체 결함·누수·정상 중 어느 것도 최종 판정하지 않는다.
Native 할당 stack과 무입력 대기 추가 검증
같은 PID에 90초 heapprofd를 연결했다. sampling interval은 65,536 bytes, dump 간격은 10초이며 block_client=false다. 368개 allocation delta row의 합은 917,504 bytes(0.875MiB)였다. 이는 연결 이후의 샘플 기반 미해제 할당 추정치이며 전체 heap 또는 실제 RSS와 같지 않다. 연결 전 보유 메모리의 출처는 소급 추적하지 못한다. 도구 원리는 Perfetto native heap profiler 문서를 기준으로 했다.
호출 stack을 부모까지 추적하면 STT onAudioBufferReceived → saveStreamRecordAudio → OfflineStream.acceptWaveform → libsherpa-onnx-jni.so에 786,432 bytes, TTS AudioPlayManager/TtsPlaybackRunner → OfflineTts.generateImpl → espeak 경로에 131,072 bytes가 연결된다. 설치 DEX에서도 PRE_RECORDING/MAIN_RECORDING의 waveform 전달 및 resetBuffer의 stream release/create를 확인했다. 이 짧은 구간에서 남은 할당 경로를 찾았지만 앞선 343.5MiB 증가를 포착한 것은 아니다. STT나 TTS가 현장 3GB SWAP의 원인이라고 확대 해석하지 않는다.
이후 180초 무입력 대기에서 VmRSS는 1,558,644→1,558,948KiB(순변화 +304KiB), VmSwap은 2,984KiB로 유지됐다. 30초 간격 7개 표본이며 이번 구간에서 지속적인 큰 증가를 확인하지 못했다. 별도 idle trace에는 allocation row가 없어 유효한 할당 부재 증거로 사용하지 않았다. 주변 로그에는 PRE_RECORDING과 IDLE 전환이 있어 무입력을 녹음 파이프라인 정지와 동일시하지 않는다. 관측 종료 뒤 프로파일링 세션은 정상 종료됐고 앱 PID는 유지했다.
STT·TTS 모델 파일 무결성과 ONNX 구조 검사
기기 APK 내부 한국어 STT 및 실제 외부 저장소의 한국어 여성 TTS 파일 hash를 로컬 asset과 대조했다. 두 파일 모두 SHA-256이 일치했다. 일치하는 로컬 파일에 onnx.checker.check_model을 실행해 둘 다 오류 없이 통과했다.
| 항목 | STT | TTS |
|---|---|---|
| 모델 | SenseVoice CTC | VITS/Piper |
| 파일 크기 | 241,227,951 bytes | 77,069,571 bytes |
| ONNX IR / opset | 7 / 14 | 8 / 15 |
| 주요 가변 입력 | x: N×T×560 | input: batch_size×phonemes |
| 주요 출력 | logits: N×T×25055 | 가변 길이 waveform |
| 기기 파일 일치·구조 검사 | 통과 | 통과 |
판정 범위는 파일 동일성과 ONNX 구조 유효성이다. 추론 정확도, 승인된 모델 여부, 모든 입력 길이에서의 메모리 상한, Android ONNX Runtime의 캐시/해제 동작은 검증하지 않았다. STT 시간축 T와 TTS phoneme 길이가 가변이므로 파일 크기만으로 추론 작업 메모리 예산을 결정할 수 없다. 다음 시험은 같은 길이 반복과 입력 길이 증가를 분리해야 한다.
모델 가중치·상수의 비정상 수치 추가 검사
파일 hash를 다시 확인하고 ONNX initializer, sparse initializer의 값, node의 tensor 속성 및 하위 graph를 순회해 수치 이상을 검사했다. 검사한 파일은 앞서 기기와 동일함을 확인한 로컬 asset이다. 모델과 기기 설정은 변경하지 않았다.
| 검사 | STT | TTS |
|---|---|---|
| 읽은 tensor 수 | 4,461 | 3,154 |
| 부동소수점 원소 수 | 1,244,647 | 19,032,921 |
| NaN | 0 | 0 |
| 무한대 | 음의 무한대 70개 | 0 |
| tensor decode 오류 | 0 | 0 |
STT의 음의 무한대 70개는 모두 self-attention의 Constant이며, 각각 Where의 참 분기 값 → Softmax로 직접 연결됨을 전수 확인했다. 이는 attention masking에 사용하는 구조와 일치한다. 무한대가 있다는 이유만으로 손상된 가중치로 판정하면 안 된다. 반대로 모든 입력에서 mask가 유효하거나 실제 추론 출력이 유한하다는 사실까지 증명한 검사는 아니다. integer 양자화 가중치의 정확도, scale의 적합성 및 학습·변환 품질도 별도 검증 대상이다.
현재 모델 자체 검사에서 파일 손상·ONNX 구조 오류·NaN 상수는 발견되지 않았다. 그러나 승인된 모델 조합인지, 음성 인식·합성 품질이 적절한지, 입력 길이에 따른 작업 메모리가 제품 예산에 적합한지는 아직 합격 판정을 내리지 않았다. 특히 직접 재현된 TTS 메모리 확장·보유는 모델 파일 무결성 통과와 양립한다. 따라서 모델 교체 여부는 동일 입력의 정확도·음성 품질·peak RSS·호출 후 잔류량을 함께 비교해 결정해야 한다.
로컬 근거: onnx-weight-finiteness.json, stt-infinity-consumers.json. 기존 SHA-256 대조 결과와 함께 보관했다.
기기 LLM binary 내부 metadata 검증
기기 binary를 읽기 전용으로 추출하고 기기 SHA-256과 다시 일치함을 확인한 뒤, 호스트의 QNN 2.44 qnn-context-binary-utility로 metadata를 추출했다. 앱에 2.44 라이브러리를 주입하거나 모델을 교체하지 않았다. 도구의 metadata 읽기 성공은 runtime 2.34에서의 모든 동작 호환성을 보증하지 않는다.
기기와 소스 binary 모두 buildId는 v2.28.2.241116104011_103376, graph 1개, DSP arch 68이다. 모델 생성 build 2.28.2와 실제 실행 QNN 2.34는 서로 다른 버전 축이며 버전 차이만으로 오류라고 판정하지 않는다. 기기 logits shape는 [1,8,128313]으로 기기 tokenizer/n-vocab 128313과 일치한다. 소스 logits의 마지막 차원은 128304다. 따라서 binary·tokenizer·JSON 세 파일이 함께 달라진 정황이며, 단순히 JSON 하나만 잘못 복사됐다는 가설은 현재 증거와 맞지 않는다. 승인된 배포 이력과 의미적 정합성은 여전히 확인 대상이다.
기기 graph의 노출된 KV 입력은 16개 층의 key/value, 각각 uint8 [32,1,64,120] 또는 [32,1,120,64]이며 합계 7.5MiB다. KV 출력 합계는 0.5MiB로 노출 KV 입출력 총 8MiB다. 이는 context 128 설정과 맞는 규모이며, 이 tensor 크기 자체를 3GB SWAP의 설명으로 사용할 수 없다. 단, runtime 복제·다중 session·중간 tensor·weight·spill/fill은 이 계산에 포함되지 않으므로 전체 LLM 메모리가 8MiB라는 뜻도 아니다.
긴 문장 TTS에서 큰 ONNX Runtime 할당 직접 포착
후속 시험은 동일 PID에서 기존 SPEECH_KEY 진입점을 사용했고 정상 LLM 질문 경로를 호출하지 않았다. 24자 짧은 문장과 마침표·쉼표 없는 172자 단일 문장을 비교했다. 로컬 AudioPlayManager는 . , ! ? 기준으로 문장을 나누어 generate하므로 단일 chunk 길이를 통제했다. 시험 로그에서 측정 순서의 4회 TTS OUTPUT_WRITTEN을 확인했고 LLM inference/Genie 생성 로그는 0회였다.
시험 한계: 첫 준비 시도의 드라이버를 중단·수정하면서 긴 문장이 이미 한 번 실행됐다. 이 준비 구간은 재현 표에서 제외하고, 아래 수치는 긴 문장 사전 노출 후 다시 시작한 측정이다. 따라서 첫 사용 비용이나 깨끗한 프로세스 기준이라고 해석하지 않는다. 240초 heap trace에는 이 준비 구간도 포함되어 아래 표의 차이와 trace 총합을 직접 동일시하지 않는다. 수정은 측정 스크립트의 UTF-8 로그 offset 처리에만 적용했고 제품 코드는 변경하지 않았다.
| 단계 | VmRSS (KiB) | Native Heap RSS (KiB) | Native Heap Alloc (KiB) |
|---|---|---|---|
| 재측정 시작 | 1,779,896 | 1,586,596 | 1,972,032 |
| 짧은 문장 24자 | 1,778,884 | 1,586,628 | 1,972,030 |
| 긴 문장 172자, 측정 1회 | 1,974,960 | 1,780,556 | 2,512,644 |
| 동일 긴 문장, 측정 2회 | 1,978,792 | 1,783,388 | 2,512,717 |
| 다시 짧은 문장 | 1,978,032 | 1,783,352 | 2,512,715 |
| 이후 약 35초 대기 | 1,977,912 | 1,783,356 | 2,512,592 |
첫 측정 긴 문장으로 Native Heap RSS는 189.4MiB, Heap Alloc은 527.9MiB 증가했다. 두 번째 동일 문장은 RSS 약 2.8MiB, Alloc 약 0.07MiB 증가에 그쳤고, 짧은 문장·대기 후 큰 보유량이 남았다. VmSwap은 2,984KiB로 유지됐다. 현재 구조에서 긴 TTS만으로도 RSS가 약 1.9GiB에 이를 수 있으며 800~1400MB를 고정 상한으로 볼 수 없다. Alloc은 실제 상주 RAM이 아니므로 증가분을 RSS에 더하지 않는다.
240초 heapprofd의 448개 allocation delta row 순합은 831,135,788 bytes(약 792.6MiB)다. 큰 미해제 할당은 OfflineTts.generateImpl → libsherpa-onnx-jni.so → libonnxruntime.so → posix_memalign stack에 268,435,486 bytes와 536,870,942 bytes로 기록됐다. 별도 TTS stack에 8MiB·16MiB 할당도 관측됐다. malloc/free 수준에서 trace 끝까지 미해제라는 뜻이며, runtime이 내부적으로 재사용 가능한 영역을 보유한 경우도 포함한다. 이 결과는 TTS에서 큰 할당이 발생했다는 직접 근거지만 내부 함수 symbol이 없어 BFCArena 자체라고 최종 식별하지는 못했다.
ONNX Runtime 공식 문서는 CPU session의 기본 arena와 큰 동적 입력 이후 영역을 유지하는 정책, 선택적인 shrinkage를 설명한다. 본 시험의 길이 의존 증가·후속 재사용 패턴은 arena 보유와 일치한다는 추론이다. 매 반복마다 일정량 증가하는 누수나 현장 3GB 전체의 원인으로 확정하지 않는다. 설치 libonnxruntime의 버전 문자열은 1.17.1이다. AAR와 APK 파일 hash는 다르지만 Build ID는 같고 ELF LOAD 영역 차이는 header의 section-table offset 1 byte뿐이며 나머지 code/data는 일치했다. 파일 hash 차이만으로 서로 다른 실행 코드를 사용한다고 판단하지 않는다.
해결 검증 우선순위: (1) 긴 무구두점 TTS를 길이 제한으로 분할하는 방안의 최대 heap·음질·첫 소리 지연 대조, (2) 설치 ORT/Sherpa 조합에서 arena 확장/회수 설정 노출 가능성과 지원 버전 확인, (3) idle 시 session 회수·재생성의 지연/재초기화 peak 대조, (4) STT 입력 길이별 동일 시험이다. 모두 검증 후보이며 설정 변경·APK 교체는 하지 않았다. 특히 shrinkage를 현 설치 JNI에 즉시 적용 가능한 옵션이라고 단정하지 않는다. 최종 제품 판정은 현장 동일 버전에서의 장기 RSS+SwapPss·zram·응답 지연·LMKD 재발률로 해야 한다.
재시작 대조 시험: 같은 내용을 분할하면 보유 메모리가 줄어드는가
동일 기기에서 두 번의 새 프로세스를 사용했다. 초기화 완료 후 약 20초 대기하고 A는 5개 분할 → 172자 단일 chunk, B는 172자 단일 chunk → 5개 분할 순서로 실행했다. 단어 내용은 같으며 분할 입력에 마침표를 삽입했다. 따라서 phoneme·운율·오디오 길이까지 완전히 동일한 입력은 아니다. 각 단계의 generate 로그는 분할 5회, 단일 1회였고 OUTPUT_WRITTEN을 확인한 뒤 약 15초 후 측정했다. 마지막에는 추가 30초 대기했다. 앱·모델·ORT 설정은 변경하지 않았고 볼륨은 2/15를 유지했다. 각 조건 1회씩의 탐색 시험이다.
| 시험 | 단계 | VmRSS (MiB) | Native Heap RSS (MiB) | Native Heap Alloc (MiB) |
|---|---|---|---|---|
| A | 초기화 후 기준 | 951.9 | 762.3 | 722.1 |
| A | 5개로 분할 | 973.2 | 787.4 | 855.0 |
| A | 172자 단일 chunk | 1197.6 | 1012.0 | 1119.1 |
| A | 마지막 대기 | 1194.1 | 1010.2 | 1119.0 |
| B | 초기화 후 기준 | 948.3 | 762.6 | 721.8 |
| B | 172자 단일 chunk | 1189.8 | 1010.1 | 1118.3 |
| B | 5개로 분할 | 1193.0 | 1011.5 | 1119.1 |
| B | 마지막 대기 | 1190.9 | 1011.5 | 1119.0 |
결과: 깨끗한 초기 상태에서 분할 입력(A)의 Native Heap RSS 증가는 25.1MiB, 단일 입력(B)은 247.4MiB였다. 각 기준점 대비 차이는 약 222.3MiB다. A도 이후 단일 입력을 실행하자 약 1,198MiB RSS로 증가했고, B는 이후 분할 입력으로 바꿔도 약 1,193MiB RSS가 남았다. 마지막 대기에서도 두 시험 모두 높은 수준을 유지했다. VmSwap은 약 3MiB였으므로 이 시험의 차이를 swap 이동으로 설명할 수 없다. 1초 간격 표본의 단일 입력 RSS 최대는 A 1,217.7MiB, B 1,205.2MiB였으며 실제 순간 최대를 보장하지 않는다.
원인 범위가 더 좁혀졌다. 현재 설치 조합에서 긴 TTS chunk가 native 작업 공간 확장과 이후 보유를 유발하는 재현 가능한 경로다. 긴 입력 이후 짧은 입력으로 바꾸는 것만으로 이미 확보한 메모리를 즉시 반환하지 않았다. 앞선 ONNX Runtime 할당 stack과 함께 보면 모델 사용 시 입력 길이 관리 및 runtime 메모리 수명이 우선 개선 대상이다. 파일 손상이나 LLM KV 크기만을 먼저 원인으로 보는 것은 현재 근거와 맞지 않는다.
다만 이것은 현재 시험 버전의 TTS 메모리 경로 확인이다. 현장 3GB SWAP 전체의 원인·주당 LMKD 발생률 개선·장기 누수 부재·음성 품질은 증명하지 못했다. 문장 분할은 우선 검증할 완화 후보이며, 문자 수와 phoneme 수 관계 및 구두점 없는 입력의 상한, 첫 소리 지연, 의미·운율을 평가해야 제품 사양을 결정할 수 있다. 모델 자체는 승인 manifest 대조와 정확도 검증이 남아 있고, STT 가변 시간축과 LLM 오류/재초기화 수명도 별도 검사 대상이다.
설치 LLM wrapper의 오류 처리와 STT 입력 수명 감사
기기의 /system/lib64/libLlama2Genie.so를 읽기 전용으로 추출해 ARM64 명령을 확인했다. DsDialog::Query에서 GenieDialog_reset 반환값은 저장만 하고, 성공 여부에 따른 분기 없이 GenieDialog_query로 진행한다. query 반환값도 이후 응답 반환을 차단하지 않는다. 로컬 소스와 설치 binary 모두 이 동작이 확인된다. 이는 오류 감지·복구 경로의 결함 후보이며, 실제 reset 실패나 이로 인한 메모리 증가가 관측됐다는 뜻은 아니다. reset 실패 주입 또는 오류 코드 계측으로 별도 검증해야 한다. g_strAnswer는 callback BEGIN에서 비워지므로 BEGIN 없이 실패한 경우 이전 응답이 남을 가능성도 검사 대상이다.
반대로 소스의 DsLog::UnInit 현재 빌드에서 제외된 logging 분기에서 보이는 잘못된 free 함수는 현재 기기의 원인으로 채택하지 않았다. CMake는 NO_LOGGING을 정의하며, 설치 binary도 실제로 GenieLog_free를 호출한다. 전처리의 실행되지 않는 분기를 현장 누수로 오판하지 않는다. JNI/래퍼에 자체 직렬화는 보이지 않지만 상위 호출 경로의 직렬화와 실제 중첩 호출을 검증하기 전에는 동시성 장애를 확정할 수 없다.
STT 로컬 소스의 SttPreprocessPipeline에는 12초 용량의 FloatRingBuffer 3개가 있지만, 이는 raw/ID 전처리 보조 버퍼다. 기본 경로는 saveStreamRecordAudio → processChunk → recognizerStream.acceptWaveform이며 보조 버퍼 용량을 실제 OfflineStream 입력의 12초 상한으로 해석할 수 없다. 정상 decode 뒤 resetBuffer가 stream을 release/create하지만 decode 이후 취소 검사에서 빠지는 경로와 예외 경로가 있어, 모든 종료 조건에서 즉시 해제되는지는 추가 검증 대상이다. 현재 ForegroundService 작업트리는 수정 상태이므로 이 정적 관찰을 현장 배포본의 확정 동작으로 확대하지 않는다. STT 길이 시험은 실제 start/stop 제어와 엔진에 전달된 sample 수를 함께 기록해야 한다.
설치 APK에서 확인한 STT 종료 타이머와 TTS 중복 생성 방어
추가 DEX 검사에서 설치 APK의 MyAccessibilityService.acceptRecording은 CancelableTimer.startTimer(10000, callback)을 호출한다. callback은 stopRecordingWithTime(10000, false)로 이어지고, 이 함수는 녹음 종료를 ForegroundService에 직접 호출하거나 STOP_RECORDING action으로 전달한다. 정상 F2 수락 경로에는 10초 종료 타이머가 있다. 보조 링 버퍼가 엔진 입력 상한이 아니라는 앞선 관찰과 모순되지 않는다. 다만 타이머 예약은 모든 상황에서 정확히 10초에 중지됐다는 실행 증거가 아니며, PRE_RECORDING·타이머 취소/재시작·스레드 지연·서비스 상태 불일치는 별도 확인해야 한다. 정상 경로에서도 STT가 무제한 녹음된다고 단정하지 않는다.
TTS 초기화 코드에는 OfflineTts(...) 생성 후 allocate() 호출이 연속으로 있어 중복 모델 생성 가능성을 검사했다. 설치 DEX에서 생성자는 native newFromFile/newFromAsset 반환 포인터를 저장하고, allocate는 ptr가 0일 때만 다시 native 생성 함수를 호출한다. 따라서 정상 생성 성공 뒤 allocate를 호출하는 이 순서 자체는 두 번째 모델 생성 근거가 아니다. 다른 OfflineTts 객체 생성·동시 호출·실패 후 재시도의 누락까지 배제한 것은 아니다.
이 두 검사는 원인 후보를 줄이는 결과다. 현재 우선순위는 (1) 직접 재현된 긴 TTS의 작업 메모리 확장/보유, (2) 정상 종료 조건을 벗어난 STT 입력 수명, (3) LLM reset/query 오류 처리다. 2·3번의 실제 발생과 현장 SWAP 3GB 연결은 미확인이다. 현장 동일 APK·모델 manifest 및 kill 전후 원본 로그 없이 현재 시험 결과를 전체 약 2,000대의 확정 원인으로 확대할 수 없다.
동일 긴 TTS 10회 반복: 추가 확장과 이후 보유를 분리
앞선 B 시험의 동일 프로세스를 유지하고, 이미 처리했던 172자 무구두점 문장을 10회 더 실행했다. 매회 generate 1회와 OUTPUT_WRITTEN을 확인한 뒤 약 5초 후 메모리를 측정했고 마지막에는 추가 30초 대기했다. 새 프로세스나 새로운 입력 길이 시험이 아니다. heapprofd를 붙이지 않은 관측이며 다른 모델 재초기화를 수행하지 않았다.
| 단계 | VmRSS (MiB) | Native Heap RSS (MiB) | Native Heap Alloc (MiB) |
|---|---|---|---|
| 반복 전 | 1191.5 | 1011.9 | 1119.1 |
| 1회 | 1384.1 | 1205.2 | 1647.3 |
| 2회 | 1389.0 | 1208.3 | 1647.5 |
| 3회 | 1388.7 | 1208.3 | 1647.5 |
| 4회 | 1388.9 | 1208.3 | 1647.5 |
| 5회 | 1391.5 | 1210.4 | 1647.7 |
| 6회 | 1391.3 | 1210.5 | 1647.8 |
| 7회 | 1391.5 | 1210.4 | 1647.7 |
| 8회 | 1391.4 | 1210.5 | 1647.7 |
| 9회 | 1391.2 | 1210.4 | 1647.7 |
| 10회 | 1391.3 | 1210.2 | 1647.7 |
| 마지막 30초 대기 | 1389.3 | 1210.2 | 1647.6 |
첫 추가 반복에서도 다시 확장됐다. Native Heap Alloc은 528.2MiB, Native Heap RSS는 193.3MiB 증가했다. 이어 1회 종료부터 10회 종료까지 Alloc 순변화는 0.39MiB, Native Heap RSS는 5.01MiB였다. VmSwap은 모든 측정에서 약 3MiB였다. 따라서 짧은 두 번의 반복만 보고 최초 호출 이후 할당량이 항상 고정된다고 결론 내릴 수 없다. 이번 10회 구간은 매회 수백 MiB가 계속 누적되는 패턴보다 큰 추가 확장 뒤 보유·재사용에 가까웠다. 장기 누수 부재나 최대 상한을 증명하는 시험은 아니다.
동일 hash의 TTS ONNX에는 /dp/RandomNormalLike와 /RandomNormalLike 두 난수 연산이 있다. 같은 문자열이라도 내부 동적 tensor가 항상 동일하다고 가정할 수 없는 이유다. 그러나 출력 sample 수·tensor별 할당을 이번 시험에서 계측하지 않았으므로 난수 때문에 이번 추가 확장이 발생했다고 확정하지 않는다. 입력 길이 외에 생성 길이·메모리 배치·기존 영역 재사용 조건을 분리해야 한다.
회수 옵션 적용 범위: 설치 DEX의 OfflineTtsConfig/OfflineTtsModelConfig에는 arena shrink나 일반 ORT RunOptions 전달 필드가 없다. Sherpa-ONNX v1.11.3 session 구현은 CPU 경로에서 기본 SessionOptions를 사용하고, 같은 태그의 VITS 구현은 빈 RunOptions로 추론한다. 이는 설치 JNI 전체가 upstream과 동일하다는 증거는 아니지만, 현 Kotlin 설정에 shrink 문자열 하나를 추가하면 해결된다는 주장은 뒷받침하지 않는다. native wrapper 수정 또는 옵션을 노출하는 버전의 별도 검증이 필요하다. 우선 변경 범위가 작은 길이 제한 분할을 평가하고, 회수 정책은 native 설정·session 수명·재초기화 peak와 함께 대조해야 한다.
반복 시험 후 전체 RAM 여유와 실제 native VMA
동일 프로세스의 후속 smaps에서 [anon:scudo:secondary] RSS는 1,098,244KiB(약 1,072.5MiB), Private_Dirty는 1,098,036KiB였고 Swap은 0이었다. scudo primary RSS는 141,084KiB(약 137.8MiB), Java main space RSS는 34,192KiB(약 33.4MiB)였다. secondary의 가상 Size 1,700,676KiB는 RSS와 다르다. 이 시점의 큰 CPU 메모리가 단순 모델 파일 mmap이나 Java heap보다 익명 native heap에 상주한다는 직접 근거다. 다만 VMA 이름만으로 모든 보유량을 TTS에 귀속할 수는 없다. 앞선 할당 stack은 TTS 증가분의 경로 근거다.
같은 후속 점검의 시스템 계수는 아래와 같다. 각 도구의 수집 시점·계수 범위가 달라 서로 더해 정확한 RAM 회계표를 만들지 않는다.
| 관측 항목 | 값 | 해석 경계 |
|---|---|---|
| /proc MemTotal | 7,464,768KiB | OS가 보고한 전체 RAM |
| /proc MemAvailable | 1,209,892KiB, 약 1.15GiB | reclaim 가능량 등을 반영한 가용 추정치 |
| dumpsys ION | 2,117,164KiB, 약 2.02GiB | 시스템 전역 계수. 전부 이 앱이나 LLM의 몫으로 보지 않음 |
| dumpsys 앱 PSS | 1,318,149KiB, 약 1.26GiB | 공유 페이지를 비례 배분한 앱 계수 |
| dumpsys 전역 swap 사용 | 63,868KiB | 해당 시점 전역 값이며 현장 앱 3GB와 다름 |
| dumpsys zram physical used | 15,972KiB | 압축 저장 RAM 비용. swap 논리 크기와 다름 |
| PSI some/full avg10·60·300 | 모두 0.00 | 측정 시점에 최근 평균 메모리 stall을 관측하지 못함 |
카메라 provider·런처·SystemUI·음성 서비스 등도 함께 메모리를 사용한다. ION 값은 Used RAM이나 앱 계수에 무조건 가산하지 않는다. 앱 RSS가 같아도 다른 서비스와 커널·공유 버퍼의 사용량에 따라 LMKD가 개입할 여유는 달라진다. 현재 dumpsys 상태는 normal이므로 위 여유량만으로 이미 LMKD 압박 상태라고 단정하지 않는다.
더 긴 문장으로 확장을 유도하는 다음 시험은 여유 메모리 사전 조건을 충족하지 않아 실행하지 않았다. 258/344자 시험 결과는 없다. 실제 서비스 부하를 임의의 강제 메모리 압박으로 대체하지 않았으며, 메모리 정책·APK·모델 파일은 변경하지 않았다. 현장과 동일한 배포본 및 병행 작업 조건으로 이어갈 때는 이 native heap 증가와 전역 여유·swap/zram·PSI를 동시에 기록해야 한다.
동일 프로세스에서 TTS 해제·재생성 후 회수 검증
10회 반복 시험 후 커진 메모리가 남은 동일 프로세스에서, 앱 전체를 종료하지 않고 TTS만 해제·재생성했다. 설치 DEX의 switchGender와 initTts를 확인한 뒤 CHANGE_VOICE_GUIDE의 type 누락 시 null → FEMALE 기본값 경로를 시험용으로 사용했다. 다시 로딩된 파일 경로가 기존 한국어 여성 모델임을 로그로 확인했다. 정식 unload API가 아니며, type 누락을 제품의 메모리 회수 방법으로 사용하라는 권고가 아니다. APK·모델·지속 설정은 변경하지 않았다.
| 시점 | VmRSS (KiB) | Native Heap RSS (KiB) | Native Heap Alloc (KiB) | VmSwap (KiB) |
|---|---|---|---|---|
| TTS 재초기화 전 | 1,423,736 | 1,239,740 | 1,687,747 | 3,060 |
| 같은 모델 초기화·IDLE 확인 직후 | 971,844 | 786,348 | 740,547 | 3,060 |
| 추가 10초 대기 | 970,196 | 786,256 | 740,491 | 3,060 |
| 짧은 TTS 출력 후 5초 | 1,017,232 | 833,072 | 740,960 | 3,060 |
동일 PID가 유지됐고 TTS engine released 1회, 여성 모델 경로, sample rate 22050 초기화 성공 1회 및 IDLE 복귀를 확인했다. 시험 구간에서 전체 앱·LLM·STT 초기화 로그는 없었다. 전후 RSS는 442.9MiB, Native Heap RSS는 442.9MiB, Native Heap Alloc은 925.1MiB 감소했다. Alloc 감소량과 RSS 감소량은 서로 다른 지표이므로 더하거나 같은 실제 RAM 회수량으로 해석하지 않는다.
이후 짧은 문장으로 generate 1회와 OUTPUT_WRITTEN을 확인했고 같은 PID를 유지했다. 이때 RSS는 약 993.4MiB로 다시 일부 증가했다. 재초기화 후 수치를 이후 모든 작업의 고정 상한으로 해석하지 않는다. OUTPUT_WRITTEN은 AudioTrack 전달 결과이며 실제 스피커 음질·청취 성공을 인증한 결과는 아니다. 미디어 음량 2/15도 유지됐다.
해석: 긴 TTS 작업 후 보유된 큰 native 메모리의 상당 부분이 TTS 세션 종료·재생성으로 회수된다. 이 관측은 무조건 프로세스 종료만이 회수 수단이라는 가설을 배제하고, 세션 수명과 runtime 작업 공간 보유를 우선 조사할 근거를 강화한다. 다만 일부 메모리 누수 가능성, 내부 arena의 정확한 정책 및 장기 반복 초기화 안정성을 배제하지 않는다. 이번에는 swap이 약 3MiB여서 현장 3GB swap의 회수 시험으로 볼 수 없다.
제품 개선 후보는 입력 길이·chunk 관리와, 유휴 상태에서 진행 중인 native 작업의 종료를 보장한 뒤 TTS 세션을 회수하는 정책이다. 어느 쪽도 아직 제품에 적용하지 않았다. 재초기화는 이번 1회에서 약 7초 후 IDLE이 확인됐으므로 매 발화마다 수행하도록 바로 적용하면 응답 지연이 생길 수 있다. 재생 중 경합, 실패 복구, 다음 발화 지연, 반복 후 잔류량을 함께 검증해야 한다.
로컬 근거: tts-reinit-before.txt, tts-reinit-ready.txt, tts-reinit-settled.txt, tts-reinit-log.txt, tts-reinit-result.json, tts-reinit-summary.json, tts-reinit-smoke-result.json, tts-reinit-smoke-snapshot.txt.
긴 TTS → 재초기화 3회 반복: 회수 재현과 오디오 정리 결함 후보
앞선 회수 시험과 동일 PID에서 같은 172자 단일 chunk 합성 → OUTPUT_WRITTEN → 5초 대기 → 같은 여성 TTS 재초기화 → 10초 대기를 3회 반복했다. 새 프로세스·다른 모델·강제 메모리 압박은 사용하지 않았다. 각 시작 전 MemAvailable 1,400,000KiB 이상을 시험용 중단 기준으로 확인했으며, 이는 제품의 안전 메모리 임계값을 검증한 수치는 아니다.
| 회차 | 긴 TTS 후 RSS (MiB) | 재초기화 후 RSS (MiB) | RSS 감소 (MiB) | 재초기화 후 Native Heap Alloc (MiB) | 재초기화 관측 시간 (초) |
|---|---|---|---|---|---|
| 1 | 1203.3 | 958.1 | 245.2 | 729.71 | 7.6 |
| 2 | 1206.0 | 960.1 | 245.9 | 729.66 | 7.1 |
| 3 | 1207.4 | 960.0 | 247.4 | 729.55 | 7.2 |
매회 generate 1회, TTS release 1회, TTS 초기화 성공·IDLE 복귀 1회를 확인했다. 전체 앱 재초기화는 없었고 VmSwap은 3,060KiB로 유지됐다. 재초기화 후 1회차→3회차의 Native Heap Alloc 순변화는 −162KiB, Native Heap RSS 순변화는 +1,776KiB였다. 따라서 이 3회에서는 수백 MiB가 매회 미회수 상태로 누적되는 패턴을 관측하지 않았다. 짧은 시험이므로 장기 누수 부재 또는 반복 초기화의 제품 안정성을 인증하지 않는다. 이전 443MiB 회수는 더 큰 메모리를 보유한 상태에서 시작했으므로 이번 약 245~247MiB와 같은 고정 회수량으로 취급하지 않는다.
새로 발견한 문제: 시험 로그에 MediaPlayer finalized without being released 경고가 6회 나타났다. 설치 DEX의 initializeAudioManager()는 새 AudioPlayManager를 생성해 기존 필드에 대입하며, 이 메서드 안에는 기존 객체의 release 호출이 없다. 현 소스의 일반 switchGender → initTts → initializeAudioManager 경로도 기존 오디오 관리자 해제를 명시하지 않는다. AudioPlayManager는 MediaPlayer 3개를 소유하고 별도의 release 메서드를 제공한다. 경고와 이 교체 경로는 명시적 오디오 자원 정리 누락을 우선 점검해야 한다는 근거다. 개별 경고 객체를 allocation stack으로 식별하거나 6개 모두의 소유자를 증명한 것은 아니다.
이 경고는 finalizer가 정리를 수행한 상황을 뜻하므로, 영구 누수 또는 현장 3GB swap의 원인으로 곧바로 해석하지 않는다. TTS 세션 재초기화를 자동 회수 정책으로 도입하기 전에 기존 AudioPlayManager의 작업 종료·release·교체 순서를 함께 보장해야 한다. 현 소스의 별도 Framework standalone 경로에는 release 호출이 있으나, 이를 설치 앱의 일반 경로에서도 해결됐다는 증거로 사용하지 않는다. 이번 작업에서는 제품 코드를 변경하지 않았다.
로컬 근거: tts-reinit-cycles.py, tts-reinit-cycles-result.json, tts-reinit-cycles-log.txt, tts-cycle-*-generated.txt, tts-cycle-*-reinit.txt, installed-audio-manager-replacement.smali. 종료 후 PID 유지와 음량 2/15를 확인했다.
9. 근거 자료와 소스
- 실기기 증거: 2026-10-16 재시작 로그,
/proc/PID/status,smaps,smaps_rollup,dumpsys meminfo,/proc/swaps, zrammm_stat, FastRPC debugfs, DMA-BUF debugfs. 원본은 내부 진단 산출물로 보관하고 이 페이지에는 필요한 비식별 수치만 반영했다. - 앱 소스:
app/src/main/java/com/skmagic/ondeviceai/agent/service/ForegroundService.kt의 모델 초기화·추론·해제 경로,app/src/main/cpp/native-lib.cpp,app/src/main/cpp/main.cpp. - BSP 소스:
kernel/msm-5.4/drivers/char/adsprpc.c의 debugfsLIST OF MAPSsize 출력 포맷. - Android 공식 LMKD 정책 설명
- AOSP lmkd: RSS·SWAP 로그와 kill 경로
- Linux /proc: VmRSS·VmSwap·smaps 계수
- Linux vm.swappiness: reclaim 상대 비용
- Linux zram: orig_data_size·compr_data_size·mem_used_total
Connections
- E03 환경별 날짜별 발생 빈도 분석 — 빈도 통계와 이번 메모리 원인 분석의 범위를 구분한다.
- SK-Intellix 기술 자료