ONDEVICE 메모리 시험 근거 — 10월 16~18일 상세 기록
이 페이지는 과거 시험 기록 보관본입니다. 당시의 “현재”, “다음 시험”, 가설은 그 시점의 판단입니다. 최종 판단과 의사결정은 통합 보고서를 먼저 읽으세요. 10월 19일 추가 IOVA 시험 결과는 문서 끝의 보충 기록에 수록했습니다.
TTS 회수 ON은 단독 시험에서 합성 후 RSS를 약 457MiB 줄였다. 현장 Swap 약 3GB의 원인은 별개로 미확정이며, LLM/NPU의 호스트 메모리와 공유 RAM을 우선 조사한다. 10/17 후속: 최종 DMA
-12를 재현했다. 관리 구조체 할당은 두 번 모두 성공했지만 IOVA 주소 확보는 캐시 반환 후에도 실패했다.화자인식은 분석 범위에서 제외했다. 초기 읽기 전용 조사 이후, 승인된 새 보드에서 LLM 로드·해제 반복 시험을 추가했다. 아래 최신 결과와 이전 TTS/Swap 조사의 시험 조건을 구분한다.
10/18 팩토리 리셋 후 전체 음성·NPU·카메라 동시 사용 실측
보고서용 결론: 현재 보드는 LLM을 NPU에서 구동하면서 STT/TTS와 카메라가 함께 실행된다. ONDEVICE의 CPU 주소 공간 RSS 약 0.84~0.93GiB와 별도로, 앱이 보유한 DMA-BUF 객체 약 1.67GiB가 확인됐다. 카메라·Vision도 공유 RAM을 사용한다. 따라서 앱 RSS 하나만으로 시스템 부담을 판단하면 부족하다. 다만 아래 수치는 현장 Swap 3GB의 소유자나 LMKD 원인을 확정한 결과는 아니다.
시험 조건과 완료 범위
- 팩토리 리셋 후 시스템 APK
1.19.36에서 기존 DeviceAgent가 실행되고, LLM·STT·TTS 초기화 성공을 실제 로그로 확인했다. 앞선 DeviceAgent 연결 대기 상태는 이 시험에 해당하지 않는다. - 설치 APK SHA-256은
57c73428837fa627f61fd73b06ff7e6c471a9ce4587d017d7d2dc33da49bdb55. Genie·QnnHtp·Sherpa JNI·ORT 라이브러리 해시는 10/16 수집본과 일치한다. 현장 A1_1.8.0 배포본과의 동일성 및 TTS 회수 ON/OFF 빌드 옵션은 이번에 확정하지 않았다. - 앱 프로세스 재시작 3회 완료. 모델만 같은 PID에서 재로드한 시험과 구분한다. 약 2초 대기 간격에 수집 시간이 더해지므로 순간 RSS 최고값은 놓칠 수 있다.
- 카메라를 유지한 1시간 기준선(121개 표본)과 별도 64·256·512·1,024MiB 추가 할당 시험을 완료했다. 기준선에는 의도적인 압박 할당을 넣지 않았으며 후속 부하 구간과 분리했다. 음성 감지
STATE_PRE_RECORDING이 반복돼 완전 무동작 대기는 아니다. 초반 진단 조회와 Explicit GC가 겹친 한계도 아래에 명시했다.
| 앱 재시작 회차 | 표본 중 최대 RSS | 마지막 RSS | 표본 중 최대 VmSwap |
|---|---|---|---|
| 1 | 1,763.69MiB | 857.48MiB | 1.57MiB |
| 2 | 928.84MiB | 852.56MiB | 1.79MiB |
| 3 | 1,629.80MiB | 881.80MiB | 2.50MiB |
1회차 큰 RSS 표본은 RssFile 1,531,484kB, RssAnon 273,636kB였다. 초기화 단계의 파일 상주량이 큰 피크에 기여했다는 증거다. 2회차의 낮은 관측 피크를 최적화 효과로 해석하지 않는다. 캐시 상태·표본 시점이 다르고 순간 최대를 연속 계측한 것이 아니다. 이번 3회에서 Swap 3GB는 재현하지 못했다.
10/18 추가 추적 — 1.9GiB 변동의 소유자와 압박 시 Swap 분리
이번에 좁혀진 결론은 세 가지다.
- 약 1.9GiB는 LLM 하나의 NPU 매핑이 아니라 시스템 전체 DMA-BUF 합계였다. LLM FastRPC 매핑은 약 1,708.27MiB였다. 전체 값의 작은 증가와 큰 감소에서 카메라 버퍼의 생성·소멸을 실제 inode 단위로 확인했다.
- 별도 진단 프로세스에 최대 2,752MiB를 할당해 실제 reclaim·Swap-out·LMKD가 발생했지만, 관측한 LLM 프로세스의 Swap은 0kB였다. LLM 대형 NPU 매핑이 Swap으로 이동했다는 증거는 확보되지 않았다.
- 강한 압박 시험은 복구 단계의 수집기 오류와 재초기화 중 LMKD가 겹쳤다. 압박 비교의 유효 구간과 복구 장애 구간을 분리한다. 현장 Swap 3GB의 원인을 재현했다고 주장하지 않는다.
1. “NPU 1.9GiB가 달라진다”를 객체로 확인
| 관측 구간 | 시스템 전체 DMA-BUF | LLM FastRPC 매핑 | 실제 확인한 변화 |
|---|---|---|---|
| 첫 시험, 압박 전 → 추가 할당 후 | 1,917.91 → 1,919.23MiB | 1,708.27MiB 유지 | inode 1322009, 1.3203125MiB 객체 한 개 추가. 연결 장치가 카메라 cam_smmu_ife |
| 강한 압박, 카메라 종료 전후 | 1,918.44 → 1,832.14MiB | 1,708.27MiB 유지 | 기존 객체 86.61MiB 소멸, 새 객체 0.31MiB 생성. 소멸 객체 중 74.64MiB가 카메라 SMMU에 연결돼 있었음 |
| 첫 시험, native 종료 후 | 209.63MiB | 해당 LLM PID 매핑 없음 | LLM의 약 1,708MiB 매핑이 사라진 뒤 다른 장치 버퍼는 남음 |
따라서 전체 DMA-BUF 값이 변했다고 LLM weights가 커지거나 줄었다고 해석하면 안 된다. 이번 LLM 최대 단일 매핑은 1,688MiB로 유지됐다. 첫 시험의 LLM 매핑 개수 7↔8 변화도 4KiB 한 개 수준이었다. 시스템 DMA-BUF 합계와 FastRPC 매핑 합계는 서로 다른 지표이며 독립 RAM처럼 더하지 않는다.
2. 실제 메모리 압박을 더했을 때
기존 제품의 음성 서비스를 중지한 뒤 설치된 Genie/QNN·모델을 사용하는 별도 native 프로세스에서 추론했다. 첫 5회는 기준선, 이후에는 별도 프로세스의 익명 메모리를 할당한 상태로 추론을 이어갔다. 제품 앱 프로세스는 시스템 방송으로 다시 생성될 수 있었지만, 시험 LLM PID와 제품 서비스 초기화 구간은 로그로 구분했다.
| 측정 지점 | 압박 도구 할당 요청 합계 | 시스템 MemAvailable | LLM smaps RSS | LLM smaps Swap |
|---|---|---|---|---|
| 첫 시험, 기준선 | 0 | 2,658.73MiB | 102.19MiB | 0 |
| 첫 시험, 2개 할당 후 | 1,984MiB | 640.88MiB | 101.28MiB | 0 |
| 강한 시험, 기준선 | 0 | 2,680.79MiB | 103.08MiB | 0 |
| 강한 시험, 3개 할당 후 | 2,752MiB | 371.60MiB | 97.27MiB | 0 |
표는 순차 스냅샷이며 순간 최저 가용 메모리가 아니다. 강한 시험에서는 이미 다른 앱의 종료와 메모리 회수가 진행돼, 할당량 증가가 MemAvailable의 동일한 감소량으로 나타나지 않는다.
- 첫 시험: query 50/50 반환값 0, 모델 해제 반환값 0. 마지막 query 후 VmRSS
104,008kB, 해제 후29,200kB, 둘 다 VmSwap 0이었다. 기준선에서 2개 할당 후까지 Cached는2,044,836→740,264kB로 감소했다. 단순히 '압박을 받으면 LLM 익명 페이지부터 Swap으로 이동한다'는 설명과 맞지 않는다. - 강한 시험의 유효 비교 구간: 기준선→3개 할당 후 전역
pswpout은 39,171페이지 증가했다. 페이지 4KiB 기준 153.01MiB의 누적 Swap-out 활동이다. 이는 현재 Swap 점유량이나 특정 프로세스의 순증가량이 아니다. 같은 구간pgsteal_direct도 1,260페이지 증가해 실제 direct reclaim을 확인했다. - 그 시점 LLM smaps Swap과 3개 압박 도구의 VmSwap/Swap 모두 0이었다. 따라서 이 시점까지 확보한 전역 Swap-out 활동을 LLM 또는 압박 도구의 현재 Swap 사용량으로 귀속할 수 없다. 다른 프로세스의 Swap 및 종료 로그를 함께 봐야 한다. 모든 프로세스의 매핑을 동시에 수집하지 않아 153MiB 전체 소유자를 확정하지는 못했다.
- LLM RSS 감소 구간에서도 Anonymous는
94,080kB로 같았다. 적어도 해당 표본의 RSS 하락을 'LLM 익명 메모리가 Swap으로 이동했다'고 설명할 수 없다.
중요한 시험 한계: native LLM 실행 파일은 root 셸에서 상속된 oom_score_adj=-1000이었다. 실제 제품 앱과 LMKD 선택 조건이 다르므로, native 프로세스가 살아남았다는 사실을 제품 앱의 압박 내성으로 일반화하지 않는다. 메모리 위치와 query 동작 관측에 한정한다. 압박 도구는 oom_score_adj=1000을 설정했지만, 이것만으로 Android 관리 앱과 동일한 LMKD 등록·선택 조건이라고 볼 수 없다.
3. LMKD 원문과 카메라 변동의 연결
강한 압박 할당 중 다음 로그가 확인됐다.
10-18 21:38:40.423 lowmemorykiller: Kill 'com.sk.camerabroker' (3845), uid 1000,
oom_score_adj 100 to free 146624kB rss, 25488kB swap;
reason: critical pressure and device is low on memory
카메라 브로커의 종료 당시 계수는 RSS 143.19MiB, Swap 24.89MiB였다. 해당 시각 이후 전체 DMA-BUF와 카메라 연결 객체가 줄었으며 LLM 매핑은 유지됐다. 로그의 to free는 종료 시 계수이지, 그 양만큼 즉시 물리 RAM이 늘었다는 사후 측정은 아니다.
4. 강한 시험의 종료 오류 — 유효 결과와 분리
강한 시험에서도 query 50회 반환값은 모두 0이었지만 정상 해제·시험 완료로 판정하지 않는다. 압박 도구 하나가 보호 조건에 따라 먼저 종료됐고, 수집기가 이미 사라진 PID에 kill을 보내다 실패했다. 그 결과 앱 복구가 native 시험의 종료와 겹쳤다. FREE_RC=0/RUN_COMPLETE는 확보되지 않았으며, 수집기의 종료 순서는 보완했지만 동일 강도로 재시험하지 않았다.
복구 중에는 ONDEVICE가 두 번 LMKD로 종료됐다.
| 시각 | 앱 PID | 종료 시 RSS | 종료 시 Swap | 로그 사유 |
|---|---|---|---|---|
| 21:39:46.131 | 21247 | 297.82MiB | 22.27MiB | device is in direct reclaim and low on memory |
| 21:40:06.629 | 22780 | 272.11MiB | 22.20MiB | device is in direct reclaim and low on memory |
이 구간은 시험 복구 시 재초기화가 겹친 교란 구간이다. 현장의 재초기화 중 재종료와 형태가 유사하지만 동일 원인으로 확정하지 않는다. DMA -12 또는 현장 3GB Swap 재현으로도 분류하지 않는다.
최종적으로 압박 도구와 native 시험 프로세스가 종료됐고, ONDEVICE PID 23326에서 LLM·STT·TTS 초기화 성공과 STATE_PRE_RECORDING을 확인했다. 카메라 브로커 PID 21267과 카메라 ACTIVE 상태를 확인했으며 Vision 두 프로세스는 기존 PID를 유지했다.
5. 복구된 제품 앱의 Swap 약 21MiB는 어디에 있었나
PID 23326의 실제 제품 앱도 추가로 분해했다. status의 VmSwap은 21,968kB, smaps_rollup의 Swap은 22,104kB, SwapPss는 658kB였다. status와 smaps는 순차 수집이며 값이 약간 다르다. 아래는 개별 VMA를 이름별로 합산한 값이다.
| VMA 그룹 | Swap | SwapPss 합계 | 해석 |
|---|---|---|---|
| dalvik-zygote space | 5,696kB | 169kB | 공유 런타임 영역의 기여 |
| boot-framework.art 관련 익명 영역 | 4,264kB | 133kB | 모델 weights라고 분류할 수 없는 Android 런타임 영역 |
| scudo:primary | 2,164kB | 52kB | 이름이 native allocator여도 이 Swap 전부가 앱 단독 보유라는 뜻은 아님 |
| dalvik large object space | 1,680kB | 49kB | 공유를 고려한 비례 부담은 원시 Swap 계수보다 작음 |
SwapPss는 공유된 Swap 페이지를 비례 배분한 계수다. 개별 VMA의 kB 반올림/절삭 때문에 합산값과 rollup이 정확히 일치하지 않을 수 있다. 이번 제품 앱의 약 21MiB Swap을 모두 LLM의 새 할당 또는 앱 종료 시 단독 반환되는 물리 RAM으로 보는 것은 맞지 않는다. 런타임 공유 영역의 비중이 실제로 확인됐다. 다만 이것을 현장의 3GB 전체에 일반화하지 않는다. 현장 값도 같은 방식으로 Swap·SwapPss·VMA 소유 영역을 함께 확보해야 한다.
근거: npu-pressure-strong/restored-app.txt, restored-app-smaps.txt, restored-app-swap-groups.json.
다음 조사 방향: 현장 3GB를 좁히려면 장시간 유지되는 제품 앱 자체의 익명 매핑을 추적해야 한다. 현재 증거는 NPU DMA 버퍼 약 1.7GiB가 그대로 Swap 3GB가 됐다는 설명을 지지하지 않는다. 추가 압박 시험은 먼저 종료·복구 순서를 보장하고 제품과 진단 프로세스의 LMKD 조건을 구분한 뒤 진행한다. 이번 데이터에서 아직 얻지 못한 것은 3GB Swap을 차지한 실제 VMA/할당자다.
근거: 로컬 npu-pressure/ 및 npu-pressure-strong/의 회차별 smaps·status·FastRPC·DMA-BUF·vmstat, dma-change-attribution.json, result-audit.json, live-all-logcat.txt, after-logcat.txt, restored-health.txt. 원시 자료는 로컬 보관한다.
10/18 STT 없는 NPU 직접 추론 — 33회 성공, 3GB Swap 미재현
결론부터: 보드에 설치된 Genie/QNN과 모델을 그대로 사용해 텍스트를 직접 전달했다. 예비 3회와 본 시험 30회 모두 GenieDialog_query 반환값이 0이었다. 본 시험에서는 NPU FastRPC 매핑 약 1,708.27MiB가 유지되는 동안 시험 프로세스 RSS는 약 93~101MiB, 추론 직후 Swap은 0이었다. 따라서 이 모델의 짧은 순차 추론만으로 곧바로 3GB Swap이 누적되는 현상은 이번 조건에서 관측하지 못했다.
무엇을 실행했나
- ONDEVICE 앱을 잠시 정지하고 별도 native 실행 파일에서
GenieDialog_create → query → reset → query → free를 호출했다. 카메라·Vision은 유지했다. STT/TTS, Android 앱 힙과 제품 명령 실행기는 이 시험 프로세스에 포함되지 않는다. - 설치된
/system/lib64/libGenie.so, QNN 라이브러리와/system/etc/model/llama32-1b-htp.json을 사용했다. 실행 라이브러리를 교체하지 않았다. 빌드 시 2.44 헤더를 함수 선언에 사용했지만 실행 SDK를 2.44로 업그레이드한 시험은 아니다. 기존 런타임 식별 결과는 QNN 2.34 / Genie 1.8이다. - 상태·배터리·공기 상태 조회 텍스트 3종을 순환 입력했다. 생성된 함수 문자열은 기록만 했고 실제 기기 명령으로 실행하지 않았다. 강제 메모리 압박·GC·프로세스 주입 도구는 사용하지 않았다.
- 본 시험 PID
15845에서 30회 query와 후속 reset이 성공했다. query 호출 시간은 925~1,319ms, 평균 1,155ms였다. 이는 STT/TTS를 제외한 API 호출 시간이며 사용자 체감 응답 지연이나 첫 음성 생성 시간이 아니다. 응답 문자열의 의미 정확도는 별도 평가하지 않았다.
메모리가 어디에 남았나
단위 MiB, /proc/PID/status의 순차 스냅샷. FastRPC 매핑은 별도 표본이므로 RSS와 합산해 정확한 총 RAM으로 표시하지 않는다.
| 본 시험 시점 | 시험 프로세스 RSS | VmSwap | 의미 |
|---|---|---|---|
| 모델 로드 전 | 2.68 | 0 | 작은 native 실행 파일만 실행 |
| 모델 로드 완료 | 100.59 | 0 | CPU 측 런타임 메모리 + 별도 NPU 매핑 |
| 첫 추론 직후 | 100.88 | 0 | 실제 query 성공 |
| 30번째 추론 직후 | 96.18 | 0 | 반복에 따른 큰 RSS·Swap 증가 없음 |
| 추론 종료 후 5초 대기 | 93.07 | 0.707 | 소량 Swap 발생 |
| 모델 해제 반환 후 | 24.91 | 0.680 | GenieDialog_free=0, RSS 감소; Swap 전부 해제는 아님 |
- FastRPC 표본은 7~8개, 1,708.2695~1,708.2734MiB였다. 차이는 4KiB 매핑 하나 수준이며, 최대 단일 매핑 1,688MiB가 반복마다 새로 누적되는 패턴은 없었다.
- 30회 추론 직후 표본 모두 VmSwap
0kB였지만, 5초 대기 후에는724kB였다. 시험 내내 Swap이 0이었다고 표현하면 틀린다. 해당 smaps에서libGenie.so경로의 VMA에 376kB,libQnnSystem.so에 64kB 등이 잡혔다. 파일 경로가 있다는 이유만으로 원본 라이브러리 파일 페이지 자체가 Swap된 것으로 단정하지 않는다. private 페이지의 정확한 생성 원인은 미추적이다. - 해제 후 VmSwap
696kB가 남았다. 모델 해제 API가 성공했다고 프로세스의 모든 라이브러리·힙·Swap이 자동으로 0이 되는 것은 아니라는 작은 사례다. 이 잔여량을 모델 누수나 현장 3GB의 축소 재현이라고 해석하지 않는다.
이번 결과로 좁혀진 것과 남은 것
좁혀진 것: 현재 설치 모델의 NPU 매핑과 짧은 순차 추론이 정상 동작했고, 그 자체에서 3GB Swap 누적은 관측하지 못했다. NPU 공유 버퍼 약 1.7GiB와 CPU 주소 공간의 Swap은 실제 수치에서도 서로 다른 항목이었다.
남은 것: 제품 앱의 STT/TTS 동시 실행, 긴 입력·출력/대화 이력, 장시간 지속 압박, 초기화 실패·재시도, 현장 배포본 차이는 이 격리 시험으로 배제할 수 없다. 다음에는 이 직접 query 경로를 이용해 지속 압박 전후의 익명 메모리·Swap과 NPU 매핑을 함께 비교하는 것이 동일한 무압박 반복 횟수만 늘리는 것보다 판별력이 높다. 제품 전체 RSS가 약 100MiB라는 의미도 아니다.
복구 확인: 시험 종료 후 ONDEVICE PID 16659에서 LLM 초기화 완료, STT 모델 초기화 완료, TTS 초기화 성공 및 STATE_PRE_RECORDING 복귀를 로그로 확인했다. 카메라·Vision 프로세스도 유지됐다.
도구 실패 분리: 앞선 Java app_process 방식은 classloader namespace에서 libdl_android.so 접근이 거부돼 모델 로드 전에 실패했다. 이후 위 native 실행 방식으로 성공했다. 그 Java 진단 프로세스의 종료를 LMKD나 weights DMA -12 재현으로 세지 않았다.
근거: 로컬 direct-llm/direct.cpp, native/smoke-stdout.txt, native/repeat-stdout.txt, native/summary.json, native/swap-attribution.json, 회차별 status·smaps·FastRPC 및 restore-logcat.txt. 원시 자료는 로컬 보관한다.
10/18 원격 제품 TTS 반복 — 초기 증가와 반복 누적을 분리
이번에 실제로 실행한 시험: 기존 설치 APK·라이브러리를 유지하고, NPU 모델과 카메라·Vision이 올라간 동일 앱 PID 25176에서 SPEECH_KEY로 TTS를 실행했다. 문장 부호가 있는 입력 1회는 내부 4구간으로 합성됐고, 문장 부호가 없는 긴 입력은 1구간 합성으로 3회, 이어서 동일 입력 10회를 실행했다. 총 14회 모두 재생 완료 로그를 확인했다. 각 요청은 이전 재생 완료 후 순차 전송했다. 미디어 볼륨은 시험 전에 9에서 3으로 낮췄다.
단위 MiB. RSS와 smaps는 순차 수집이므로 합계가 정확히 일치하지 않을 수 있다. 표의 '후'는 각 시험 종료 후 대기·최종 수집값이다.
| 시점 | 앱 RSS | Scudo RSS | Dalvik RSS | 앱 VmSwap |
|---|---|---|---|---|
| 첫 TTS 이전 | 899.88 | 697.17 | 119.13 | 2.72 |
| 4구간 TTS 1회 후 | 1020.35 | 778.46 | 158.00 | 2.72 |
| 긴 1구간 TTS 3회 + 대기 후 | 1119.81 | 958.29 | 83.31 | 2.72 |
| 동일 긴 TTS 추가 10회 + 대기 후 | 1180.79 | 959.58 | 144.14 | 2.72 |
무엇을 좁혔나:
- 첫 1회 이후 Scudo RSS는 약 81MiB, 다음 긴 입력 3회 이후에는 약 180MiB 추가 증가했다. 합성이 끝난 뒤에도 native 할당 영역의 상주량이 남는 현상을 제품 경로에서 확인했다. 다만 Scudo 이름만으로 살아 있는 ORT 텐서·arena와 allocator 캐시를 구별할 수는 없다.
- 이어진 동일 입력 10회에서는 Scudo RSS의 전후 차이가 1.29MiB였다. 각 회차 직후에는 958.22~962.57MiB 범위였다. 이번 조건은 '매번 같은 큰 메모리가 끝없이 누적'되기보다는, 앞선 사용으로 커진 native 영역이 유지·재사용되는 해석과 더 잘 맞는다. 짧은 시험으로 누수를 배제하지는 않는다.
- 전체 RSS는 위 native 영역과 별도로 Dalvik 변동의 영향을 받았다. 추가 반복 4→5회 직후 Dalvik RSS가
142,704→71,460kB로 줄면서 앱 RSS도 내려갔다. 이 구간에 GC 로그가 확보되지 않아 특정 GC 동작으로 단정하지 않는다. - 모든 표본의 앱 VmSwap은 2,784kB로 동일했다. 앞선 긴 3회와 추가 10회 모두 전후 FastRPC 매핑은 7개·1,708.27MiB였다. 이번 관측에서는 TTS RSS 증가가 NPU 매핑 증가나 Swap 3GB로 이어지지 않았다.
- CameraBroker·vision_data·VisionAgent를 종료하지 않았다. 앞선 3회 시험 전후 PID와 각 VmSwap은 동일했고, 카메라 ACTIVE도 확인했다. 동시 실행 중 전체 시스템 변화를 TTS 하나의 사용량으로 귀속하지 않는다.
해석 범위: 실제 음성 인식 후 NPU query를 반복한 시험이 아니라, NPU 모델이 로드된 제품에서 TTS를 반복한 시험이다. 주입 도구·강제 GC·압박 할당은 사용하지 않았다. 시스템 Sherpa JNI 해시는 0b761f50c30a93fed5e8324adcea0ec7427d25a395633d8a13ef9a685054f5bf로, 전달 묶음의 ON/OFF 두 바이너리와 모두 다르다. 따라서 이번 수치를 ON/OFF 절감량으로 해석하지 않는다. 입력 길이·순서가 다르고 native 할당 호출자를 추적하지 않았으므로 '긴 입력만의 순수 효과'도 아니다.
다음 검증: 동일 입력·동일 초기 조건의 제품 ON/OFF 비교로 남는 native 상주량이 실제 회수되는지 확인한다. 별도 native 프로세스의 NPU 직접 추론은 위 33회 시험으로 확인했다. 제품 앱 안에서 STT/TTS와 함께 실행되는 query 반복은 추가 검증 대상이다. 현장 Swap 3GB의 소유자는 여전히 미확정이다.
근거: product-tts/summary.json, product-tts-repeat/summary.json, product-tts-repeat/mapping-deltas.json, product-tts-repeat10/summary.json, product-tts-repeat10/per-trial-summary.json, 각 회차 smaps·logcat·FastRPC 원본. 원시 시험 자료는 로컬 보관한다.
실제 NPU 추론 시험의 판정 기준 — 설치 APK 경로 확인
설치된 1.19.36 APK를 직접 추출해 DEX를 확인했다. 텍스트 입력이나 TTS 재생 횟수를 NPU 추론 횟수로 세면 안 된다. 현재 작업 소스와 설치본의 입력 처리 구현에 차이가 있으므로, 현재 소스만 보고 시험 진입점을 판단하지 않는다.
| 설치본에서 확인한 경로 | 실제 동작 | NPU 반복 시험으로 인정 가능한가 |
|---|---|---|
USE_TEXT_INPUT + SPEECH_KEY |
processInputText → processSpeech → playTTS |
아니오. 이 경로 자체는 TTS 재생 |
USE_TEXT_INPUT + TEXT_INPUT_KEY |
processTextWithTimeout → generateTtsAndCommands |
이 호출만으로 추론 증명 불가 |
| 음성 명령 처리의 로컬 분기 | processVoiceCmd → processLLAMA |
아직 불충분. 아래 규칙 매칭을 통과해야 함 |
processLLAMA 내부 |
3개 규칙 매처가 모두 실패할 때 QaClient.Infer |
네이티브 query 시작·완료 로그까지 확인해 계수 |
| 클라우드 대화 지속 분기 | processCloudLLM |
로컬 NPU 추론으로 세지 않음 |
따라서 앞의 초기화·압박·카메라 측정은 해당 범위의 증거이며, 전체 제품 경로의 NPU 추론 반복 시험 완료를 의미하지 않는다. 앞서 수행한 LLM 단독 100회 시험도 STT/TTS 전체 서비스가 준비된 제품 시험과 구분한다. 이 경로 감사 당시에는 호출 주입이나 추가 추론 시험을 수행하지 않았다. 이후 별도 native 직접 추론 결과는 위 33회 시험 절에 추가했다.
초기화 압박 시험 이후 추가 읽기 전용 표본은 앱 RSS 946,716kB(924.53MiB), VmSwap 2,784kB(2.72MiB), 시스템 MemAvailable 1,997,848kB(1,951.02MiB)였다. 앱 VmSwap은 앞선 시험 마지막 값과 같다. 이 한 표본으로 장기간 안정성이나 현장 3GB의 부재를 보장하지 않는다.
다음 원인 판별에 필요한 조건: 현장 A1_1.8.0의 실제 APK·모델·QNN 배포본과 현재 설치본의 동일성을 먼저 확인하고, 실제 네이티브 query가 확인되는 제품 경로에서 시간에 따른 익명 메모리·Swap·DMA를 비교한다. 현재 보드에서 3GB가 재현되지 않았다는 사실을 현장 문제 부정이나 모델 무결성 검증 완료로 해석하지 않는다.
근거: 로컬 수집물 inference-path-audit.json, installed-processSpeech.smali, installed-processVoiceCmd-inner.smali, installed-ForegroundService$processLLAMA$2.smali, post-init-route-audit.txt. 설치 APK 해시는 위 시험 조건과 같다.
NPU와 카메라 메모리를 어떻게 읽어야 하나
| 계층 | 이번 관측 | 해석 |
|---|---|---|
| ONDEVICE CPU 주소 공간 | 카메라 동시 측정 시 RSS 861.46MiB, PSS 776.45MiB, VmSwap 2.48MiB | 모델 로더, Java/Kotlin, 네이티브 힙, STT/TTS 등이 포함된다. NPU 구동이어도 CPU 메모리는 필요하다. |
| ONDEVICE 보유 DMA-BUF | 8개 FD의 고유 inode에 대응하는 객체 합계 1,708.27MiB, 최대 1개 1,688MiB | NPU 공유 메모리 경로와 연관된 실물 버퍼. 앞선 FastRPC 추적과 함께 해석한다. RSS 밖에 존재할 수 있으며 모든 지표를 독립 RAM처럼 단순 합산하지 않는다. |
| 카메라 IFE/ICP 연결 DMA-BUF | 고유 객체 110개, 79.65MiB | 현재 드라이버 연결 기준 부분집합이다. 카메라 스택 전체 메모리가 아니며 프로세스별 FD 합계와 겹칠 수 있다. |
| 시스템 전체 DMA-BUF | 고유 객체 합계 1,919.50MiB | LLM·카메라·Vision 및 기타 장치 버퍼를 포함한다. 위 항목에 추가로 더하는 값이 아니다. |
| Swap | 앱 VmSwap 약 2.5MiB | DMA 버퍼 1.7GiB가 그대로 앱 Swap으로 이동했다는 증거는 없다. DMA의 RAM 점유가 다른 회수 가능한 메모리에 압박을 주는 간접 경로와 구분한다. |
Vision·카메라 프로세스별 분리
단위는 MiB. 메모리와 FD·전역 DMA-BUF는 순차 수집했으므로 완전 동시 스냅샷이 아니다. PSS는 공유 페이지를 비례 배분하며 RSS와 의미가 다르다. 행별 DMA-BUF 합계를 합산하지 않는다.
| 프로세스 | RSS | PSS | VmSwap | 보유 FD와 일치한 DMA-BUF |
|---|---|---|---|---|
| camera provider HAL | 200.32 | 196.31 | 0.01 | 83.00* |
| cameraserver | 18.82 | 9.98 | 0 | 17.70 |
| com.sk.camerabroker | 147.52 | 61.73 | 2.50 | 17.70 |
| com.sk.airbot.visionagent | 81.42 | 12.19 | 2.51 | 0 |
| com.sk.vision_data | 123.61 | 44.11 | 2.51 | 41.89 |
| com.sk.liveview.client | 81.00 | 7.99 | 2.50 | 0 |
| com.skmagic.ondeviceai.agent | 861.46 | 776.45 | 2.48 | 1,708.27 |
* HAL의 FD에서 본 inode 2개는 나중 전역 목록에 없었다. 83MiB는 일치한 객체만 합한 값으로 전체 보유량의 확정값이 아니다. FD가 0이라는 것은 해당 시점 열린 DMA-BUF FD를 못 찾았다는 뜻이며, 매핑·다른 프로세스 소유 버퍼 이용까지 없다는 뜻은 아니다. ONDEVICE와 vision_data의 수집된 FD inode 교집합은 없었다.
카메라 서비스는 ACTIVE, 실제 클라이언트는 com.sk.camerabroker로 확인됐다. 출력은 176×144 SurfaceTexture와 1280×960 ImageReader 두 개이며 각각 누적 9,917프레임이 기록됐다. 버퍼 수는 각각 11개·12개였다. VisionAgent 패키지가 존재한다는 것만으로 이 버퍼를 모두 VisionAgent RSS에 귀속하지 않는다. LiveView 프로세스 실행만으로 원격 스트리밍 활성화까지 확인한 것은 아니다.
ONDEVICE 1시간 기준선 완료
실제 3,601.38초 동안 30초 간격 121개 표본을 수집했고 PID 10232가 유지됐다. /proc/status RSS는 844.72~940.80MiB, VmSwap은 전 표본 2,544kB(2.484MiB)였다. 시스템 MemAvailable은 1,916.00~2,067.45MiB였다.
시스템 전체 누적 카운터 차이는 swap-in 0페이지, swap-out 83페이지(332KiB, 실측 페이지 크기 4,096바이트), 직접 회수 pgscan_direct·pgsteal_direct와 allocstall 증가는 0이었다. PSI 누적 대기는 some 736,476µs, full 438,875µs 증가했다. 따라서 지속적인 Swap 왕복·대량 누적은 관측되지 않았지만, 압박이 전혀 없었다는 뜻은 아니다. oom_kill=0은 커널 OOM 카운터이며 이것만으로 LMKD 부재를 증명하지 않는다.
측정 한계: 초반 진단 dumpsys meminfo와 Explicit GC가 겹친 구간이 포함돼 전체 1시간을 무개입 자연 회수 시험으로 부르지 않는다. 카메라·음성 서비스가 실행 중인 현재 보드 조건이며, 현장 장기 운용 또는 초기화 중 압박 조건과 동일하지 않다. 시스템 카운터는 앱 단독 사용량이 아니다. 근거: idle-1h/samples.jsonl, sample-000.txt~sample-120.txt, baseline-summary.json.
64~1,024MiB 추가 할당 시험 완료
카메라·Vision·모델 로드 상태를 유지한 채 별도 진단 프로세스가 임의 데이터로 채운 익명 메모리를 단계별 60초 유지하고 해제했다. 각 단계 뒤 120초 회복을 관측했다. 4단계 모두 정상 해제됐으며 앱·카메라·Vision PID는 유지됐다. 시험 프로세스의 Swap은 표본에서 0이었다.
| 추가 할당 | 유지 중 최소 MemAvailable(MiB) | 앱 VmSwap(kB) | 시스템 swap-out 증가(KiB) | 직접 회수 증가 |
|---|---|---|---|---|
| 64MiB | 1850.35 | 2,544 유지 | 0 | 0 |
| 256MiB | 1667.17 | 2,544 유지 | 448 | 0 |
| 512MiB | 1385.34 | 2,544 유지 | 728 | 0 |
| 1024MiB | 857.57 | 2,544 유지 | 1740 | 0 |
시스템 카운터 차이는 각 단계 직전부터 해제 후 120초까지다. 네 단계 모두 swap-in·직접 회수·allocstall 증가는 0이었다. PSI 누적 some/full 증가는 64MiB에서 0/0µs, 256MiB에서 97,053/60,105µs, 512MiB에서 54,353/35,729µs, 1,024MiB에서 69,940/31,349µs였다.
별도 68개 프로세스 표본에서 ONDEVICE·VisionAgent·vision_data·CameraBroker·LiveView의 VmSwap은 일정했고, 카메라 HAL만 8→244kB로 증가했다. 시스템 전체 swap-out을 ONDEVICE 사용량으로 귀속하지 않는다. 시험 종료 후 카메라는 ACTIVE이며 두 스트림 모두 누적 18,163프레임이 확인됐고 PSI avg10/60/300은 0이었다.
결론과 한계: 현재 로드 완료·카메라 동시 사용 상태에서 최대 1GiB의 추가 할당만으로 앱 Swap 대량 증가를 재현하지 못했다. 직접 회수·할당 지연이 발생하지 않아 현장의 심한 압박을 재현했다고 볼 수 없다. 초기화 중 압박·반복 추론·장시간 운용은 별도 조건이다. 시험 도구의 oom_score_adj는 1000으로 먼저 종료될 수 있도록 했고, 남은 가용량을 확인하는 중단 조건을 사용했다. LMKD 정책이나 앱 우선순위는 변경하지 않았다.
근거: pressure/*-tool.txt, 단계별 before/during/release/recovery 원본, pressure-stage-summary.json, pressure-process-timeline-summary.json, post-pressure-health.txt.
초기화 중 1GiB 추가 할당: 실제 회수 발생, LLM 초기화 성공
앞의 로드 완료 상태 시험과 분리해, 진단 프로세스가 1,024MiB를 120초 유지하는 동안 ONDEVICE 앱 프로세스를 재시작했다. 같은 PID에서 모델만 재시도한 시험은 아니다. 카메라·Vision 서비스는 유지했고, 앱 새 PID는 25176이었다. LLM은 GenieDialog_create = 0 및 초기화 완료 로그, STT는 초기화 완료 로그, TTS는 TTS initialized successfully 로그를 확인했다. 종료 후 LLM FastRPC 매핑은 7개 1,708.270MiB였다.
| 지표 | 이번 초기화 시험 |
|---|---|
| 유효 앱 표본 | 70개; 시작 직후 PID 미생성으로 1회 수집 실패 |
| 표본 최대 RSS | 1,191.02MiB |
| 앱 VmSwap 최대 / 종료 후 | 2,804 / 2,784kB |
| 시스템 Swap 사용량 순증가 | 42,496kB = 41.50MiB |
| 시스템 swap-out / swap-in | 10,522 / 5페이지 |
직접 회수 검사 pgscan_direct |
12,986페이지 |
직접 회수 성공 pgsteal_direct |
2,109페이지 = 8.24MiB |
allocstall_normal 증가 |
17 |
| PSI 누적 some / full 대기 증가 | 658,991 / 367,903µs |
이 시험에서는 실제 직접 회수와 할당 지연이 발생했다. 그러나 LLM 초기화는 성공했고 앱 Swap은 약 2.7MiB에 머물렀다. “초기화 중 압박을 받으면 반드시 앱 Swap이 3GB가 된다”는 설명은 이번 결과로 뒷받침되지 않는다. 시스템 전체 Swap 증가를 LLM 가중치가 Swap으로 이동한 양으로 해석해서도 안 된다. 12,986은 회수한 페이지 수가 아니라 검사한 페이지 수다.
부하 도구는 정상 해제·종료(return code 0)됐고, 종료 후 MemAvailable은 약 2GiB였다. 계측은 약 2초 대기와 수집 시간이 더해지는 간격이므로 순간 최고 RSS·최저 가용량을 놓칠 수 있다. 시스템 카운터 구간에는 앱 종료·초기화와 다른 프로세스 동작이 함께 포함된다. 1회 시험이며 현장 배포본·장시간 압박·반복 추론과 동일하지 않다. 원인 확정이나 재발 방지 효과 검증으로 일반화하지 않는다.
근거: init-pressure-1024/summary.json, counter-deltas.json, samples.json, after-logcat.txt, after-fastrpc.txt, npu-map-summary.json, tool-result.json.
카메라·Vision 30분 동시 관측 완료
30초 간격 61개 표본에서 7개 프로세스 모두 PID가 유지됐고 표본 누락은 없었다. 아래는 /proc/status 계측이며, 순차 조회라 완전 동시 스냅샷은 아니다. 각 프로세스 Swap은 전체 구간에서 일정했다.
| 프로세스 | RSS 최저~최고(MiB) | VmSwap(kB), 전 구간 일정 |
|---|---|---|
| android.hardware.camera.provider@2.4-service_64 | 200.12~200.38 | 8 |
| cameraserver | 18.53~19.08 | 0 |
| com.sk.airbot.visionagent | 81.39~84.16 | 2,572 |
| com.sk.camerabroker | 131.52~187.73 | 2,556 |
| com.sk.liveview.client | 81.00~81.00 | 2,564 |
| com.sk.vision_data | 105.50~139.93 | 2,568 |
| com.skmagic.ondeviceai.agent | 851.29~940.80 | 2,544 |
현재 동시 사용 조건에서 30분 만으로 Swap이 지속 누적되는 현상은 관측하지 못했다. 이는 고부하·장기 운용·현장 3GB 재현의 부정 증거로 일반화하지 않는다. CameraBroker 및 Vision의 RSS 변동 위치는 아래 별도 smaps 비교를 참고한다. 근거: camera-timeline/000.txt~060.txt, camera-timeline-summary.json.
Vision·CameraBroker RSS 변동의 위치: 두 표본 비교
같은 PID에서 /proc/smaps만 다시 읽어 비교했다. CameraBroker의 Dalvik 영역 RSS는 12,000kB 감소, Scudo는 2,248kB 증가, 경로명이 있는 나머지 매핑은 760kB 증가했다. vision_data는 Dalvik 9,136kB 증가, 경로명 매핑 64kB 증가, Scudo 변화 0kB였다. 두 프로세스 모두 smaps Swap 합계 변화는 0kB였다.
이번 두 표본에서 Vision RSS 증가 위치는 주로 Java 영역이며, CameraBroker는 Java 영역 감소와 네이티브 영역 증가가 동시에 있었다. RSS 변동을 NPU 버퍼 증가와 동일시하지 않는다. 두 표본만으로 장기 누수·회수 주기나 모든 변동 원인을 판정하지 않는다. 경로명 매핑에는 ashmem 등도 포함되므로 일반 파일 캐시로 해석하지 않는다. 근거: camera-mapping-followup.json, camera-mapping-comparison.json, 각 프로세스의 followup-smaps.txt·followup2-smaps.txt.
Vision도 FastRPC 사용: 공유 RAM과 DMA 주소 공간을 구분
10/18 후속 읽기 전용 조회에서 com.sk.vision_data(PID 2897)는 FastRPC cid=3, smmu.cb=4, ONDEVICE(PID 10232)는 cid=3, smmu.cb=2로 확인됐다. 두 프로세스 모두 조회 시 smmu.faults=0이다. 현재 FastRPC MAPS 합계는 Vision 18개 41.875MiB, ONDEVICE 7개 1,708.270MiB다. 이 목록은 앞의 열린 DMA-BUF FD 목록과 범위가 다르므로 객체 개수·합계가 완전히 같아야 하는 것은 아니다.
해석: Vision도 DSP/FastRPC 경로를 사용하고 물리 RAM 부담에 기여하지만, 관측한 context bank는 LLM과 다르다. “Vision의 버퍼가 LLM의 같은 IOVA 공간을 직접 채워서 1,688MiB 매핑이 실패했다”는 설명은 현재 증거로 뒷받침되지 않는다. 공유 RAM의 간접 압박과 각 context의 주소 할당 문제를 분리해서 추적한다. 서로 다른 context bank 표기만으로 모든 드라이버 자원이 완전히 격리됐다고 보장하는 것도 아니다. fault 카운터 0은 성공적인 주소 예약이나 과거 DMA -12 부재를 증명하지 않는다.
디버그 출력의 size는 0x 접두사가 있어도 로컬 adsprpc.c의 출력 형식이 %zu여서 십진 바이트로 해석했다. 주소 필드는 %lX/%llX로 별개다. 근거는 fastrpc-followup.txt, fastrpc-context-summary.json 및 플랫폼 소스 drivers/char/adsprpc.c:5617이다.
대기 중 RSS 증가: 현재 좁혀진 범위
동일 PID의 초반 약 8분 동안 VmRSS는 907,712→953,476kB로 약 44.69MiB 증가했다. 같은 구간 전체 smaps 비교에서 Dalvik main 영역 RSS가 43,980kB 증가했고 Scudo secondary는 548kB, primary는 12kB 증가했다. 따라서 이 구간 증가분의 주된 위치는 Java 힙이며, NPU 가중치 버퍼가 커졌다고 해석할 근거는 없다. 어떤 객체가 증가했는지는 아직 확인하지 않았다.
후속 RSS는 865,316kB로 내려갔다. 그러나 14:47:54에 Explicit concurrent copying GC freed ... 87MB ... 로그가 있고 진단 dumpsys meminfo 조회 시각과 겹친다. 이 하락을 개입 없는 자연 회수로 증명하지 않는다. 별도 무개입 구간과 비교해야 하며, 현재 자료만으로 Java 누수 확정도 배제도 할 수 없다.
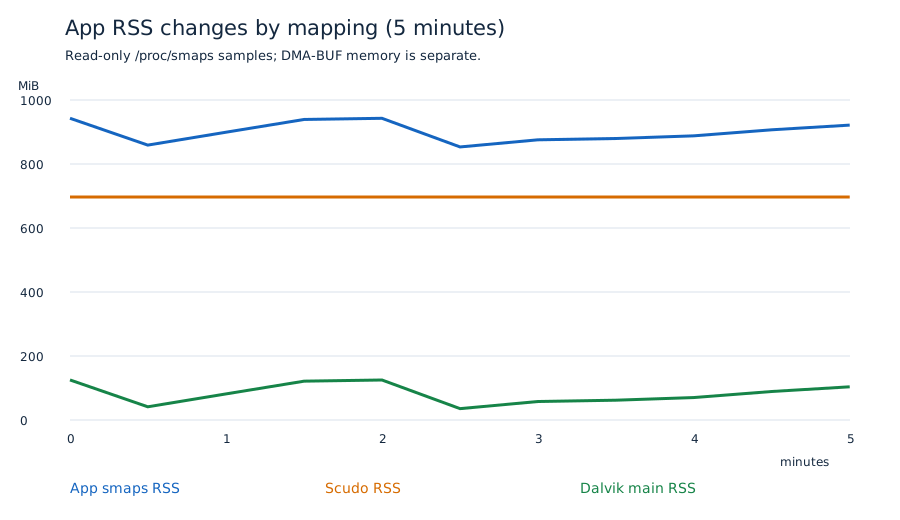
추가 무주입 매핑 관측: 동일 PID의 후속 /proc/smaps 표본에서 전체 RSS는 965,520→879,672→920,876kB, Dalvik main RSS는 128,144→42,288→83,456kB였다. 표본 간격은 약 30초다. 첫 하락의 전체 RSS 차이 85,848kB와 Dalvik main 차이 85,856kB가 거의 일치하며, Scudo 합계는 713,580→713,576→713,576kB, smaps Swap 합계는 2,636kB로 유지됐다. 이번 약 84MiB RSS 변동의 위치는 Java 힙으로 좁혀졌다. 이 구간 수집기는 /proc만 읽었으며 GC를 요청하지 않았다. 다만 회수의 정확한 런타임 경로나 객체 종류는 확인하지 않았고, 이 약 84MiB 변동만으로 현장 약 583MB 범위 전체를 설명할 수는 없다. smaps 합계와 별도 시점 /proc/status 수치는 혼용하지 않는다. 근거: mapping-timeline/samples.jsonl, mapping-interim-summary.json.
5분 수집 완료(11개 표본, 동일 PID): smaps RSS 범위는 853.30~942.89MiB, Dalvik main은 35.49~125.14MiB, Scudo 합계는 696.852~696.855MiB였다. smaps Swap 합계는 11개 표본 모두 2.574MiB였다. 이 짧은 구간에서는 RSS 변동 폭과 Java 영역 변동 폭이 약 89.6MiB로 거의 일치했고 네이티브 힙은 일정했다. 이는 위치별 변동 증거이며, 장기 누수 배제나 현장 전체 RSS 범위의 원인 확정은 아니다.
현재 작은 Swap의 구성: 독점 점유와 공유분 구분
후속 /proc/<pid>/smaps_rollup 직접 조회에서 ONDEVICE는 Swap 2,636kB / SwapPss 65kB, CameraBroker는 2,648 / 65kB, vision_data는 2,660 / 66kB였다. 매핑별 상위 Swap에는 세 프로세스 모두 fontMap ashmem과 시스템 라이브러리 이름의 매핑이 나타났다. 따라서 현재의 약 2.5MiB를 각 앱이 독점 점유한 Swap으로 단순 합산하지 않는다. 공유분 배분 결과가 훨씬 작다는 관측이며, 라이브러리 이름만으로 페이지의 생성·공유 경로를 모두 확정하지 않는다.
SwapPss는 개별 smaps 행을 정수 kB로 읽고 합하면 반올림·절삭 오차가 누적되므로 위 값은 smaps_rollup 직접 출력을 사용했다. 현재 정상 상태의 작은 Swap 구성과 현장 약 3GB의 구성은 별도다. 현장 Swap 대부분이 공유 페이지라고 주장할 근거는 없다. 근거: swap-mapping-attribution.json, swap-rollup-comparison.json 및 프로세스별 swap-rollup.txt.
시스템 전체 예산: 가용량·빈 RAM·Swap 압축량 구분
같은 카메라·음성 서비스 실행 상태의 후속 스냅샷이다. 각 행은 중첩되는 계측값이므로 합산표가 아니다.
| 지표 | 실측 | 의미·주의 |
|---|---|---|
| MemTotal | 7,289.81MiB | 커널이 보고하는 전체 RAM |
| MemFree | 353.77MiB | 현재 빈 페이지 |
| MemAvailable | 2,005.34MiB | 회수 가능량 등을 고려한 추정 가용량. 즉시 빈 RAM이나 DMA 할당 성공 보장이 아님 |
| Cached | 1,793.55MiB | 시스템 캐시 계측. 모두 같은 조건으로 즉시 회수되는 것은 아님 |
| AnonPages | 1,943.00MiB | 시스템 전체 익명 상주 페이지. ONDEVICE 단독 수치가 아님 |
| ION total_heaps_kb | 1,917.64MiB | ION heap 할당 계측. 앞의 DMA-BUF 합계와 중복 가능 |
| ION total_pools_kb | 24.63MiB | ION 풀 계측. 사용 중 DMA 버퍼와 구분 |
| CmaTotal / CmaFree | 432.00 / 1.51MiB | CMA 예약·현재 free. 이 값만으로 LLM의 IOVA 실패 원인을 CMA 부족으로 확정하지 않음 |
| SwapTotal − SwapFree | 21.58MiB | 시스템 swap 슬롯 사용량 |
| zram 저장 원본 데이터 | 20.43MiB | mm_stat 첫 필드, 페이지 수 기반 원본 크기 |
| zram 압축 데이터 / 물리 할당 | 5.13 / 5.71MiB | 압축 데이터 크기와 할당기의 실제 점유량. 프로세스 VmSwap과 같은 값이 아님 |
PSI some/full의 avg10·avg60·avg300은 모두 0이었다. 따라서 이 스냅샷은 현재 높은 압박의 증거가 아니다. 현재 약 2GiB의 MemAvailable을 “아무 용도에나 즉시 쓸 수 있는 2GiB의 빈 RAM”으로 해석하거나, 현장의 Swap 3GB를 곧바로 zram 물리 RAM 3GB 점유로 해석하지 않는다. 원본·압축·할당 크기는 로컬 zram_drv.c:1052의 mm_stat 출력 순서를 확인해 읽었다. 근거: system-budget.txt.
실제 대응 및 다음 검증
- 현장 계측은 ONDEVICE뿐 아니라 VisionAgent·vision_data·CameraBroker·camera provider, 전역 DMA-BUF와 zram·zone 상태를 함께 수집한다. RSS만 합산하거나 DMA-BUF를 중복 합산하지 않는다.
- 1시간 기준선 및 최대 1GiB 추가 할당 시험은 완료했다. 앱 Swap 증가·직접 회수가 없었으므로 현장 고압박을 재현했다고 판정하지 않는다. 초기화 중 1GiB 추가 할당도 1회 수행해 직접 회수와 초기화 성공을 확인했으나 앱 Swap 3GB는 재현하지 못했다. 장시간 반복 추론 및 현장 원본 smaps·LMKD 사유와 배포본 동일성 확보가 여전히 필요하다.
- 카메라 중지/재시작 비교는 실제 소비자와 재시작 경로를 확인한 뒤 별도 시험으로 수행한다. 아직 카메라 ON/OFF의 절감량이나 LMKD 개선 효과는 측정하지 않았다.
- 재초기화 피크 억제, 중복 초기화 방지·백오프, TTS 회수 선택은 현실적인 검토 대상이다. 현재 결과만으로 모델 교체나 카메라 버퍼 축소를 해결책으로 확정하지 않는다.
근거 묶음: 로컬 a1-reset-20261018/의 samples.json, round-2/, round-3/, idle-1h/samples.jsonl, idle-growth-check-smaps.txt, camera/summary.json, camera-service.txt, runtime-identity.txt. 원본 로그는 기기 정보가 포함될 수 있어 공개 페이지에 전체 게시하지 않았다.
의사결정 요약 — 무엇을 알았고 무엇을 아직 모르는가
현재 결론은 “메모리 문제가 하나 있다”가 아니라 아래 세 현상을 분리해 대응해야 한다는 것이다.
| 구분 | 확인된 사실 | 아직 확정하지 못한 것 | 지금 가능한 판단 |
|---|---|---|---|
| TTS 회수 ON/OFF | 미사용 ORT CPU arena 회수 ON에서 합성 후 RSS 약 457MiB 감소, 긴 생성 평균 약 0.26초 증가 | 제품 전체 경로의 지연·최대 메모리·LMKD 개선 효과 | 기본 OFF 전달 유지. ON 채택은 체감 지연과 동시 부하 시험 후 결정 |
| 현장 LMKD·RSS·Swap | 첫 종료 10건 RSS 887.5~1,470.0MB, Swap 3,153.6~3,406.1MB. 시험 보드에서는 zone 집계 여유가 작아 전체 free가 남아도 LMKD가 동작한 사례 확보 | 현장 10대의 동일 종료 원인, 3GB Swap의 기능별 소유자, 최종 LLM 복구 성공 | 현장과 같은 배포본·동시 서비스 조건의 종료 전 계측 필요. 800MB 고정이나 TTS ON으로 해결된다고 약속할 수 없음 |
| NPU DMA 매핑 실패 | 1,688MiB IOVA 할당 실패 후 DMA -12 재현. 작은 예약 구간·FastRPC 캐시 주소 일치, 별도 회차에서 설정 경계 아래 할당까지 관측 | 최종 실패 순간의 방해 버퍼 소유권, 배포 커널의 정확한 경계 처리, 수정 효과 | SoC에 FastRPC 캐시 수명·주소 배치·IOVA 경계 처리 검토 요청. RAM 총량만으로 판단하지 않음 |
독자별 빠른 근거: TTS가 실제 회수하는 대상과 지연 측정, DMA -12 실패 원문과 호출 경로, 전체 free와 LMKD zone 집계의 차이. 상세 기록의 과거 “미확보” 설명은 그 시점의 상태이며, 최신 확인 결과는 이 요약과 해당 후속 절을 우선한다.
팀 문의 2·4·5번에 대한 답변
2) kill 후 정상 초기화됐나? 초기화음은 유지하나? 현장 로그에서 엔진별 성공과 정상 추론 응답을 확인해야 하므로 현재 자료로 10대 모두 정상 복구했다고 확정할 수 없다. 현재 브랜치 소스에는 LLM이 실패해도 STT/TTS 성공 시 Ready로 진행 가능한 조건이 있다. 초기화 완료 경로에서 효과음 두 개를 재생하므로, 자동 복구 시 무음·야간 정책은 별도로 결정해야 한다. 아래 소스 재검토 절에 실제 경로를 기재했다.
4) RSS가 왜 다르고 800MB로 유지할 수 있나? RSS는 현재 RAM에 올라온 페이지의 합이다. 사용·초기화 단계, 파일 페이지 재읽기·회수, 익명 메모리의 Swap 이동에 따라 달라진다. 프로세스 중요도는 종료 우선순위 및 시스템 정책에 영향을 주지만, RSS를 직접 800MB로 설정하는 값은 아니다. 현장 표의 RSS+Swap 합도 일정하지 않아 “같은 메모리가 Swap으로 옮겨졌기 때문” 하나로 설명되지 않는다. 현재 자료로 800MB 상한 보장은 불가능하며, 상주량과 초기화 피크를 따로 줄여야 한다.
5) Swap 3GB는 무엇이고 왜 남나? 프로세스에 계정된 swap-backed 페이지를 의미하지만, 원문 계측 종류에 따라 VmSwap·SwapPss·LMKD 보고값의 의미가 다르다. 압축 전 논리량을 zram의 실제 물리 사용량과 혼동하면 안 된다. 프로세스가 해당 메모리를 계속 보유하면 초기화·추론이 끝나거나 시스템 압박이 풀려도 자동으로 모두 해제되는 것은 아니다. 반면 프로세스 종료 후 새 프로세스에 이전 PID의 Swap이 그대로 합산되는 방식은 아니다. 현재 격리 모델 반복에서는 약 4MB 수준이라 현장 3GB 소유자를 아직 입증하지 못했다.
원인 확정에 필요한 남은 증거
| 미해결 질문 | 확정에 필요한 자료 |
|---|---|
| 현장 3GB가 어느 기능의 메모리인가 | 현장과 동일한 APK·QNN/Genie·모델·설정의 식별값, 기능별 동작 시각, 종료 전 smaps/SwapPss 및 DMA-BUF·zram 계측 |
| 현장 LMKD도 시험 보드와 같은 이유인가 | 종료 이유 원문, 당시 oom_score_adj, zone별 free/CMA/pgskip·watermark/PSI 입력 |
| 재초기화 후 LLM이 실제 복구됐나 | 동일 새 PID의 Genie create 성공·모델 준비 완료·정상 추론 응답. Ready/초기화음만으로 대체하지 않음 |
| DMA -12의 정확한 방해 객체는 무엇인가 | 실패 순간 IOVA 검색 노드와 버퍼 객체 수명 연결, 배포 커널의 해당 경계 코드 확인 |
실험 보드와 현장 배포본의 동일성은 미확인이다. QNN 2.24/Genie 1.8 기준을 요청받았지만 현재 보드의 확인값은 QNN 2.34/Genie 1.8이므로 같은 조건의 결과로 취급하지 않는다. 원인 확정 전에는 현재 결과를 보드에서 확인된 경로와 현장 원인 후보로 구분해 사용한다.
현재 결론과 대응 판단 — 먼저 읽는 요약
| 질문 | 현재 답 | 근거·한계 | 현실적인 대응 방향 |
|---|---|---|---|
| RAM이 남는데 왜 종료되나? | 전체 MemFree와 LMKD가 합산하는 zone 여유가 다르다. | 실행 LMKD 분기 및 zone 합산 uprobe 확인. 현장 10대의 동일 원인까지 입증한 것은 아님. | SoC 쪽에서 종료 순간 zone별 free/CMA/pgskip·watermark 입력을 함께 수집. 전체 MemAvailable만으로 재시작 허용 판단하지 않기. |
| 초기화 때 RSS가 왜 크게 뛰나? | 모델 파일 clean 매핑이 큰 일시적 RSS를 만들 수 있다. | 관측 RSS 2,078MiB 중 파일 매핑 1,690.5MiB, 해당 매핑 Swap 0. 완료 후 RSS 379MiB. | 재초기화 동시 실행 방지·백오프 검토. SDK 로더의 파일 매핑 수명 및 버퍼 중복 유지 구간을 공급사와 확인. 수치만 보고 모델 누수로 판정하지 않기. |
| NPU인데 앱 메모리가 왜 문제인가? | 호스트 파일 매핑·CPU 보조 버퍼와 NPU 공유 RAM이 함께 필요하다. | 약 1,708MiB DMA-BUF 객체 귀속·해제 확인. PFNMAP 버퍼는 일반 smaps RSS와 별도. | RSS·익명 메모리·DMA-BUF·ION 풀을 분리 계측. 서로 겹칠 수 있는 지표를 단순 합산하지 않기. |
| ION 풀 1.7GiB가 방치된 누수인가? | 그 증거는 없다. 초기화 마지막 구간의 풀 조회는 64KiB였다. | 수집 중 회수 반환 합계 63MiB. 종료 후 1.7GiB로 복귀. 페이지별 alloc/free 대응은 미확보. | 풀 전체 강제 제거를 해결책으로 적용하지 않기. 사용 중 버퍼와 풀 사이 이동을 추적. |
| DMA 매핑 -12는 RAM 부족인가? | 실패 요청은 관리 구조체 할당 성공 후 IOVA 주소 확보에서 실패했다. | 작은 예약 구간과 경계 아래 반환도 별도 회차에서 관측. 최종 실패 객체 소유권·배포 커널 수정 효과는 미확정. | FastRPC 캐시 수명과 주소 배치, IOVA 경계 처리를 함께 검토. 전체 RAM이나 pool 크기만으로 원인을 확정하지 않기. |
| 현장 Swap 3GB는 누구 것인가? | 아직 직접 소유 기능을 확정하지 못했다. | 현재 격리 LLM 시험에서 3GB 미재현. clean 모델 파일·직접 DMA 버퍼를 그대로 3GB Swap으로 볼 증거 없음. | 현장과 같은 APK/SDK/설정·전체 음성 서비스에서 smaps 익명 영역과 Swap의 장기 증가를 수집. LLM 단독 음성 기능 미실행 시험의 한계를 유지. |
| TTS 회수 ON은 채택할까? | 메모리와 긴 생성 시간의 절충이다. | 단독 시험 약 457MiB 감소, 긴 생성 약 256ms 증가. 제품 전체 경로의 보장 수치 아님. | 기본 OFF 유지, ON 바이너리로 실제 발화 길이·동시 부하를 비교한 뒤 결정. |
위 대응은 검토 방향이며 LMKD 설정·SDK·앱 동작을 수정해 해결이 검증됐다는 뜻이 아니다. 아래 상세 내용은 여러 시점의 조사 기록이다. 과거의 “미확보” 문장은 해당 시험 당시 한계이며 최신 후속 계측 결과와 구분한다.
현장 10대 수치가 말해 주는 것
사용자가 제공한 표에서 각 기기의 첫 종료 10건만 계산했다. 재초기화 중 두 번째 종료 2건은 실행 단계가 다르므로 제외했다. 단위는 원문의 MB를 그대로 유지했으며 MiB로 임의 변환하지 않았다.
| 항목 | 최솟값 | 최댓값 | 차이 |
|---|---|---|---|
| RSS | 887.5MB | 1,470.0MB | 582.5MB |
| Swap | 3,153.6MB | 3,406.1MB | 252.5MB |
| 각 행의 RSS+Swap | 4,041.1MB | 4,693.4MB | 652.3MB |
RSS가 작을수록 동일한 양만큼 Swap이 커진다는 단순 교환만으로 이 표 전체를 설명할 수 없다. 예를 들어 RSS가 가장 작은 행은 Swap도 가장 작다. RSS에는 파일·공유 페이지도 포함되므로 실제 할당량, 매핑 상태와 기능 실행 단계 차이를 함께 확인해야 한다. 다만 서로 다른 기기의 종료 시점 10개이므로 시간에 따른 누수·증가 속도나 인과관계를 증명하는 자료는 아니다.
RSS+Swap은 압축 후 zram의 물리 사용량도, 프로세스가 독점한 전체 물리 RAM도 아니다. DMA-BUF 일부는 RSS에 잡히지 않고 공유 페이지의 중복 계정도 있을 수 있다. 이 계산은 “편차가 전부 RSS↔Swap 이동이다”라는 단순 설명을 점검하기 위한 보조 지표다. 2,000대 전체의 발생률은 전체 종료 건수·관측 대상·수집 기간에 대한 집계 원본 없이는 확정하지 않는다.
근거: 사용자가 제공한 10대 첫 종료 표, 내부 field-first-kill-summary.json; 위 보드 계측의 원본 경로는 아래 각 절에 기재했다.
복구 성공 판정과 초기화음 — 현재 브랜치 소스 재검토
10/17 현재 feature/feature_mr9, HEAD 3887fb7f7c79e13308c0bc2c1689bc24e52e2e6d의 작업 트리를 읽었다. 소스 수정·음성 재생 시험은 하지 않았다. 현장 A1_1.8.0 바이너리와 같은 코드라는 증거는 아직 없다.
DeviceCommunicator 연결 callback
 → ForegroundService.initializeApp()
 → LLM / STT / TTS 초기화
 → 세 결과가 모두 false일 때만 중단
 → STATE_IDLE / Ready 표시
 → playListeningCompleteSound()
 → 1,200ms 대기
 → playCreateAnswerCompleteSound()
 → AudioPlayManager.playEffectRing()
 → asset 설정 → MediaPlayer.prepareAsync() → onPrepared에서 start()
ForegroundService.kt:487~491의 중단 조건은 세 엔진 결과의 AND이며, :505~509에서 Idle/Ready를 알린다. :627~630은 완료 효과음 두 개를 요청한다. :1966~1973에서 FIRST_EFFECT/SECOND_EFFECT로 전달하고, utils/AudioPlayManager.kt:445~468은 파일을 열어 MediaPlayer 준비 후 재생한다. 효과음은 EffectRingType.kt:4~5의 듣는중 음성인식음 및 답변 생성 완료음 WAV다. 이 호출 경로에는 시간대 또는 자동 복구 원인에 따른 분기 조건이 없다. 실제 소리 발생은 호출 경로 도달·asset 준비·볼륨 등 런타임 조건을 따로 확인해야 한다.
현실적인 제품 검토안: 엔진별 준비 결과로 전체 Ready를 판단하고, 전원 켜기·사용자 요청 초기화·LMKD 자동 복구 등 시작 원인을 구분한다. 자동 복구는 완료 로그/상태를 남기되 초기화음은 무음으로 할지, 야간 정책을 적용할지 제품 사양으로 결정한다. 이는 아직 적용된 변경이 아니며, 현장 기기에서 실제로 소리가 났다는 증명도 아니다. 정상 복구 판정에는 최소한 LLM create 성공과 복구 후 추론 응답을 함께 사용한다.
RSS 증가분 분해와 진단 중단 기록
20회 후 증가한 메모리는 주로 Scudo primary 영역이었다. 60초 대기만으로는 줄지 않았다. 다만 이것으로 SDK 누수라고 확정하지 않는다.
| 비교 | 실측 |
|---|---|
20회 전후 /proc/status VmRSS |
+5,924kB (+5.79MiB) |
별도로 읽은 smaps 합계 변화 |
+5,452kB. status와 동시·동일 방식 측정이 아니므로 숫자를 섞지 않음 |
smaps Scudo primary RSS |
55,108 → 60,916kB, +5,808kB |
| Java main region RSS | 변화 없음 |
libGenie.so 파일 매핑 RSS |
3,076 → 3,004kB. 별도 익명 heap 할당의 소유권까지 뜻하지 않음 |
| 진단 도구 분리 후 Scudo primary | 60,872kB: 증가분 대부분 유지 |
| 이후 0/15/30/45/60초 읽기 관찰 | VmRSS 246,224kB, Scudo primary 60,872kB, VmSwap 3,996kB로 각 시점 동일 |
진단 도구 분리 전후에는 /memfd:frida-agent-64.so 매핑 RSS 8,168kB 등이 사라져 전체 RSS가 줄었다. 하지만 Scudo primary는 44kB만 줄었다. 따라서 전체 RSS 감소를 “반복 초기화 증가분이 모두 회수됐다”로 해석하면 안 된다. 반대로 Scudo 영역에는 앱·SDK·진단 실행 과정의 native 할당이 함께 들어갈 수 있으므로, 남은 증가분을 QNN 단독 누수로 귀속할 수도 없다.
이 관찰에서 smaps Swap 합계는 4,164kB, /proc/status VmSwap은 3,996kB였다. 서로 다른 계측을 동일한 값이라고 취급하지 않는다. 어느 쪽도 현장 3GB를 재현한 결과는 아니다.
allocator purge는 실행되지 않음 — 진단 연결 중 system_server 장애
해제 가능한 allocator 페이지와 사용 중인 할당을 구분하기 위해 로컬 bionic의 mallopt(M_PURGE=-101)를 한 번 호출하는 진단을 준비했다. 실제 호출 전에 Frida 연결이 실패했으며, purge 반환값 또는 실행 결과는 없다. 이후 로그에서 다음을 확인했다.
10-17 00:41:39.288 ... Fatal signal 11 (SIGSEGV) ... pid 12010 (system_server)
10-17 00:41:39.416 ... failed to attach to thread 12010, already traced by 23059 (/data/local/tmp/a1-memory-frida-server)
일시적으로 ADB가 offline이 됐다가 복구됐고, uptime은 이어진 채 system_server PID가 23209, 앱 PID가 24690으로 바뀌었다. 이는 Android 서비스 재시작을 동반한 진단 중 장애다. 기존 앱 LMKD나 DMA -12 재현 횟수에 넣지 않는다. 로그는 진단 도구 관여를 보여주지만, 정확한 충돌 원인은 별도 조사 대상이다. M_PURGE 때문에 발생했다고 말할 수 없다.
복구 후 ForegroundService 프로세스 존재를 확인했고, 진단 서버 없음·kprobe 없음·tracing/FastRPC 이벤트 0을 확인했다. 추가 Frida 주입은 중단하고 기존 증거 및 읽기 관찰 중심으로 분석한다. 복구된 앱의 LLM 모델 초기화 성공이나 전체 제품 기능까지 검증한 상태는 아니다. 이 사건은 앞서 확보한 로그를 무효로 만들지는 않지만, 이후 개입 실험의 안정성과 관측 영향 평가에 반드시 포함해야 한다.
증거: domain-owner-failure/rss-delta-by-mapping.json, post-diagnostic-idle/summary.json, allocator-purge/attach-failure-logcat-full.txt, allocator-purge/post-incident-status.txt, allocator-purge/post-incident-services.txt. 전체 로그에는 다른 제품 정보가 포함돼 있어 공개 문서에는 필요한 오류 조각만 기재한다.
동일 배치 비교 — 추가 20회에서는 실패가 재현되지 않음
실패 시 소유자 추적을 위해 최대 20회 반복했으나, 20회 모두 생성·해제에 성공했다. 성공한 결과를 누락하지 않고 실패 사례와 함께 기록한다. 이 실험만으로 문제가 해결됐다고 볼 수 없다.
| 항목 | domain-owner-failure 추가 실험 |
|---|---|
| 앱 프로세스 | PID 2923 유지 |
| 큰 IOVA 요청 | 20회 모두 1,688MiB, 첫 alloc_iova 호출에서 성공 |
| 반환 주소 배치 | 20회 모두 PFN 0x89000..0xf27ff, 시작 IOVA 0x89000000 |
| IOVA 캐시 flush | 이번 추적의 CPU/magazine flush 이벤트 0회 |
| 최종 DMA -12 / LMKD | 모두 로그 미관측 |
| 앱 Swap | baseline 4,024kB → 마지막 해제 후 3,996kB |
| 앱 RSS | baseline 255,048kB → 마지막 해제 후 260,972kB: +5.79MiB |
| RssAnon | 156,452kB → 162,544kB: +5.95MiB |
해석: 큰 버퍼가 같은 주소 구간을 확보하는 조건에서는 20회 재시도가 누적돼도 DMA 실패나 Swap 3GB가 발생하지 않았다. “초기화를 여러 번 하면 반드시 3GB가 쌓인다”는 설명은 이 결과와 맞지 않는다. 반대로 앞서 확인한 DMA 실패와 경계 아래 반환을 없었던 일로 취급할 수 없다. 작은 버퍼의 주소 배치, 캐시 상태, 검색 시작점이 달랐던 회차를 비교해야 한다.
RSS/Anon의 수 MiB 증가는 별도 관찰값이다. 진단 도구가 주입된 동일 프로세스에서 수행한 짧은 실험이므로 앱 누수, SDK 누수 또는 정상 allocator 보관 중 하나로 아직 분류할 수 없다. 수 GiB Swap 누적의 증거도 아니다. 완전한 메모리 불변 또는 누수 없음으로 표현하지 않는다.
증거: /mnt/c/Temp/a1-newboard-20261016/domain-owner-failure/summary.json, 1~20회 trace·result·logcat 및 baseline/해제 후 스냅샷. 큰 요청 20건의 반환 주소를 자동 대조했다. alloc_enter/alloc_ret/walk_enter missed는 0이며 erase_enter 누적 missed 1이다. 임시 추적을 제거했고 모델 해제를 완료했다. 다음 재현은 같은 성공 배치에서 횟수만 늘리기보다, 실패·성공 간 주소 배치 차이와 최종 실패 순간 버퍼 소유권을 확보하는 데 집중한다.
예약 구간 소유자 후속 — 앱 FastRPC 세션의 작은 재사용 버퍼와 주소 일치
4KiB 예약 구간과 같은 주소가 우리 앱 FastRPC 세션의 724바이트 캐시 버퍼에서 확인됐다. 큰 weights 버퍼 자체가 아니라, 같은 NPU 통신 경로에서 함께 쓰는 작은 버퍼가 큰 연속 주소 확보에 영향을 줄 수 있다는 단서다.
| 증거 | 확인한 내용 |
|---|---|
앞선 검색 추적 domain-walk/8/trace.txt |
캐시 반환 후에도 PFN 0x8b5fe가 검색 노드로 남음 |
| 같은 회차 로드 후 FastRPC 목록 | Thread-11_11974, tgid=2923, cid=3, smmu.cb=2의 LIST OF BUFS에 phys=0x28B5FE000, size=724 |
| 주소 대조 | 드라이버는 cb << 32를 더해 표시함. cb=2를 제거하면 0x8B5FE000, PFN은 0x8b5fe로 일치 |
| 목록의 의미 | 로컬 adsprpc.c의 LIST OF BUFS는 fl->cached_bufs를 출력함. 현재 실행 중인 weights 목록과 구분됨 |
| 해제 후 | 같은 회차 모델 해제 후 스냅샷에서는 앱 FastRPC debugfs 항목 자체가 사라짐. 이를 누적 누수라고 단정할 근거는 없음 |
시간상 한계: 소유자 목록은 큰 요청 직후가 아니라 모델 로드 완료 후 읽었다. 검색 순간의 버퍼 객체 포인터를 직접 연결한 것은 아니므로 주소 일치만으로 그 순간의 소유권을 완전히 확정하지 않는다. 아래 추가 실험은 작은 버퍼가 weights 매핑 전에 생성되는 순서를 확인했지만, 앞선 경계 아래 반환 사건과 동일 사건은 아니다.
왜 캐시를 비웠는데도 남을 수 있나
| 층 | 보관하는 것 | 이번 조사에서의 차이 |
|---|---|---|
| IOVA 할당기 캐시 | 반환 후 재사용을 기다리는 주소 예약 | 큰 요청 실패 시 free_cpu_cached_iovas()로 정리되는 대상 |
| FastRPC 버퍼 캐시 | 재사용할 실제 DMA 버퍼와 그 매핑 | 드라이버 입장에서는 아직 할당된 버퍼이므로, 위 주소 캐시 정리만으로 없어지지 않음 |
로컬 drivers/char/adsprpc.c에서 fastrpc_buf_free(buf, cache=1)는 조건에 맞는 버퍼를 fl->cached_bufs에 넣고 dma_free_attrs 전에 return한다(1000~1070행). 다음 할당은 캐시에서 적합한 버퍼를 찾는다(1650~1680행). 따라서 이것은 소스상 의도된 재사용 경로이며, 자동으로 누수 또는 앱의 잘못된 free 호출이라고 볼 수 없다.
작은 내부 버퍼의 dma_alloc_attrs() 실패 경로는 FastRPC 캐시를 비운 뒤 한 번 재시도한다(1712~1786행). 반면 weights의 dma_buf_map_attachment() 실패 경로는 오류를 기록하고 bail로 이동한다(1573~1583행). 두 실패 경로의 캐시 정리 정책이 다르다. FastRPC 캐시 반환과 IOVA 캐시 반환을 혼동해 “이미 모든 캐시를 비웠다”고 결론 내리면 안 된다.
추가 10회로 확인한 범위
domain-owner/에서는 커널 기본 fastrpc_dma_alloc/free/map/unmap 이벤트와 IOVA 검색 추적을 함께 켰다. 같은 PID 2923에서 모델 생성·해제 10/10 성공, LMKD 종료 로그 없음, 앱 Swap 4,024kB 유지였다. 각 회차 724바이트 DMA 버퍼의 할당 이벤트가 weights의 1,688MiB 요청보다 먼저 관측됐다. 예를 들어 3회차에는 phys=0x288bff000, size=724가 기록됐다. 이번 10회에서는 최종 DMA 실패와 경계 아래 반환을 재현하지 못했다.
전체 trace는 각 회차 entries-in-buffer와 entries-written이 같았다. 누적 missed는 alloc_ret=2, erase_enter=2, walk_enter=0이므로 전체 시스템 이벤트가 완전하다고 주장하지 않는다. 로드 구간만 tracing했으므로 해제 호출 이후의 DMA free 전부를 이벤트로 입증한 것도 아니다. 모델 해제 반환과 후속 스냅샷으로 별도 확인했다. 마지막에는 임시 probe와 FastRPC 이벤트를 끄고 진단 서버를 종료했다.
대응 검토를 어디에 요청할 것인가
- SoC/FastRPC 드라이버: 큰 weights 매핑 전에 안전하게 반환 가능한 캐시 버퍼를 정리하는 방안, 또는 작은 통신 버퍼가 큰 연속 IOVA 구간을 나누지 않도록 하는 배치 방안을 검토한다. 진행 중인 RPC·persistent 버퍼까지 강제로 해제하면 안 된다. 아직 적용·효과 검증한 해결책은 아니다.
- 커널 IOVA: 앞서 관측한 시작 경계 아래 반환과 overflow 수정 포함 여부를 함께 확인한다. FastRPC 캐시 정책만 바꿔 경계 처리 문제를 가리는 방식으로 판정하지 않는다.
- 앱: public SDK의 정상적인 context/session 해제와 재시도 직렬화를 검토한다. 앱에서 임의 커널 버퍼 해제를 호출하는 방식으로 대응하지 않는다.
이 결과는 “가용 RAM이 많은데도 NPU 매핑이 실패할 수 있는 이유”를 주소 배치와 서로 다른 캐시 수명으로 구체화한다. 다만 앞선 최종 DMA -12 회차의 방해 노드 소유자까지 확인한 것은 아니며, 현장 Swap 3GB 원인을 이 작은 버퍼로 설명할 수는 없다.
검색 경로 후속 — 작은 예약 구간과 시작 주소 아래 할당을 함께 관측
10/17 추가 8회에서는 모델 생성·해제가 모두 성공했지만, 8회차에서 설정 시작 주소 아래로 할당되는 결과를 재현했다. 성공 여부만으로 IOVA 경계 준수까지 정상이라고 볼 수 없다. 앞선 6회차 최종 DMA 실패와 별도의 실험이며, 이번 8회에는 LMKD 종료 로그가 없었다.
| 관측 | 실제 값과 의미 |
|---|---|
| 같은 프로세스 반복 | PID 2923 유지, 생성 8/8 성공, 해제 8/8 성공 |
| 앱 Swap | baseline부터 마지막 해제까지 4,024kB 유지. 이번 반복에서도 Swap 3GB 누적은 재현되지 않음 |
| 8회차 큰 요청 | 432,128페이지 = 1,688MiB, 시작 PFN 0x80000, 제한 PFN 0xf7fff |
| 캐시 반환 뒤 남은 노드 | 0x8b5fe..0x8b5fe: 4KiB IOVA 예약 구간. 물리 RAM 소비량을 뜻하지 않음 |
| 그 위 확인된 빈 구간 | 상위 노드 시작 0xf4a00까지 약 1,684.004MiB, 큰 요청보다 작음 |
| 시작 경계와 예약 노드 사이 | 약 181.992MiB로 역시 1,688MiB 요청을 넣을 수 없음 |
| 재검색 동작 | 같은 alloc_iova 호출 안에서 anchor를 다시 거쳐 같은 상위 노드들을 재방문 |
| 최종 반환 | PFN 0x21c00..0x8b3ff, IOVA 시작 0x21c00000. 설정 시작 0x80000000보다 낮음 |
위 빈 구간 계산은 관측한 두 노드 사이 주소 차이다. 도메인 전체 트리를 덤프한 결과나 전체 최대 빈 구간 측정으로 확대하지 않는다. rb_prev 진입의 노드와 호출자를 추적했으며, 하위 미방문 노드 및 전체 소유자는 아직 확인하지 않았다.
왜 중요한가
- 크기만 더해서는 설명할 수 없다. 4KiB 예약이라도 위치에 따라 1,688MiB 연속 주소 요청을 가로막을 수 있다. 이번에 관측한 예약은 캐시 반환 후에도 남아 있었다. 소유자 후속 대조는 위 절을 참고한다. 검색 순간의 정확한 객체 수명까지 입증한 것은 아니다.
- 실패와 겉으로 성공한 경우를 함께 봐야 한다. 이전 실험은 두 번의 할당 실패 후 DMA -12로 끝났고, 이번 실험은 anchor에서 재검색하다 시작 주소 아래를 반환했다. 동일 원인이라고 확정하지 않지만 비교해야 할 구체적인 분기 차이가 생겼다.
- 로컬 커널의 경계값 처리 검토 우선순위가 높아졌다.
__alloc_and_insert_iova_range()는low_pfn_new = curr_iova->pfn_hi + 1을 계산한다. anchor의pfn_hi = ~0UL이면 unsigned 계산이 0으로 돌아가 재검색 하한이 0이 될 수 있다. 이번 anchor 재방문·경계 아래 반환은 이 경로와 일치한다. 다만 보드 커널 전체 바이너리와 소스의 일치 및 해당 분기 레지스터 값까지 검증한 것은 아니므로 유력한 코드 검토 후보로 둔다. 앞 절의 upstream overflow 수정 검토와 연결하되, 적용하면 DMA 실패가 해결된다고 주장하지 않는다.
현실적인 다음 확인
- SoC 측에서 실제 배포 커널의 IOVA overflow 수정 포함 여부를 확인하고, 같은 재현 조건에서 수정 전후를 비교한다. 수정 후에는 부적절한 경계 아래 성공이 정상적인 할당 실패로 바뀔 수도 있어, 단순 성공률만 비교하면 안 된다.
- 최종 실패 순간 검색 노드와 각 예약 소유자를 함께 수집해 살아 있는 버퍼인지, 캐시인지, 해제 누락인지 구분한다.
- 앱 Swap 3GB는 별도 과제로 유지한다. 이번 주소 공간 이상과 Swap 크기를 직접 연결하는 증거는 없다.
증거와 한계: /mnt/c/Temp/a1-newboard-20261016/domain-walk/의 summary.json, 5/trace.txt, 8/trace.txt, 각 result.json·profile.txt·메모리 스냅샷. 8회차 trace 264/264로 ring 덮어쓰기는 없었다. 누적 probe missed는 alloc_ret 4, erase_enter 2이고 walk_enter는 0이다. 따라서 모든 시스템 호출을 빠짐없이 기록했다고 주장하지 않으며, 인용한 큰 요청의 진입·검색·반환은 직접 확보했다. 임시 추적은 제거했고 모델도 해제했다. 진단 probe 자체의 실행 비용은 존재한다.
핵심 후속 결과 — 최종 DMA -12 재현, IOVA 주소 할당 실패로 경로를 좁힘
2026-10-17 00:06:07, 찾던 최종 실패를 재현했다. PID 2923을 유지한 추가 시험 6회차에서 커널 dma_buf_map_attachment … ret -12와 QNN Failed to map weights buffer to device가 함께 발생했다. 1~5회는 create/free 모두 성공했고 6회는 create가 -1로 반환됐다. 실패 구간에 LMKD kill 로그는 없었으며 앱 프로세스는 유지됐다. 시험을 중단하고 계측을 정리했다.
지금 확정할 수 있는 설명
이번 실패 지점은 1,688MiB 버퍼를 장치에 연결할 IOVA 주소 범위의 할당이다. 두 번 모두 관리 구조체의 slab 할당은 성공했다. CPU별 IOVA 캐시 반환 뒤에도 주소를 확보하지 못해 DMA map 실패와 QNN 초기화 실패로 이어졌다. -12라는 숫자만 보고 “전체 물리 RAM 부족” 또는 “관리 구조체 malloc 실패”로 설명하면 이번 관측과 맞지 않는다. 다른 물리 메모리 압박이 전혀 없었다거나 모든 실패 사례가 같다는 뜻은 아니다.
| 같은 요청의 실제 순서 | 관측 |
|---|---|
| 요청 | 1,769,996,288 bytes = 1,688MiB, 432,128 pages |
| 첫 관리 구조체 할당 | non-NULL |
| 첫 alloc_iova | NULL |
| CPU별 주소 캐시 반환 | CPU 0~7 함수 호출, magazine 항목 17개, 같은 트리의 삭제 대상 17개·주소 범위 합계 252KiB |
| 두 번째 관리 구조체 할당 | non-NULL |
| 두 번째 alloc_iova | NULL |
| iommu_dma_alloc_iova | 0 |
| __msm_dma_map_sg | 0 — 매핑 성공 항목 없음 |
| FastRPC / QNN | dma_buf_map_attachment ret -12 / Failed to map weights buffer to device |
| GenieDialog_create | -1 |
| 그 뒤 관측된 같은 도메인의 4KiB 요청 | IOVA 확보·map 성공 |
작은 4KiB 요청은 이후 성공했다. 이는 큰 요청 실패 시점에 주소 공간이 모든 크기에 대해 완전히 고갈됐다고 설명할 수 없다는 추가 근거다. 큰 연속 주소 범위를 확보하지 못한 이유는 전체 점유·정렬·검색 상태를 더 확인해야 하며, 단순한 총량 부족과 단편화를 아직 수치로 분리하지 못했다.
성공 때와 실패 때 달랐던 검색 상태
이번 실패에서 캐시 반환 뒤 검색 시작 노드는 anchor가 아니라 pfn 0xf75de 한 페이지의 실제 노드였다. 앞선 성공 재시도에서는 anchor로 바뀐 사례를 관측했다. 이 차이는 주소 배치·검색 상태를 조사할 단서지만, 해당 한 노드가 유일한 장애물이라는 뜻은 아니다. 전체 트리 스냅샷이 없으므로 “어느 기능이 점유한 몇 MiB 때문에 실패했다”까지는 아직 확정하지 않았다.
첫·두 번째 요청의 start_pfn=0x80000, limit=0xf7fff, granule=4096 값은 같았다. 큰 요청 실패 뒤 max32_alloc_size가 432,128로 바뀌었는데, 이는 실패 크기 캐시와 부합하며 남은 물리 RAM 용량이 아니다.
RAM과 Swap은 어떻게 보였나?
직전 5회차 해제 후 MemAvailable은 5,203,452kB, 6회차 실패 후에는 5,222,852kB였다. 앱 VmSwap은 4,024kB로 유지됐다. 둘은 전후 스냅샷으로, 실패 명령 실행 순간의 물리 메모리 값을 직접 나타내지는 않는다. 이번 오류를 현장 Swap 3GB 누적 때문이라고 연결할 근거는 없다.
로그 원문 핵심
10-17 00:06:07.587 ... fastrpc_mmap_create: dma_buf_map_attachment for fd 95 failed on device soc:qcom,msm_fastrpc:qcom,msm_fastrpc_compute_cb2 ret -12
10-17 00:06:07.604 ... QnnDsp <E> Failed to map weights buffer to device!
10-17 00:06:07.914 ... -1 = GenieDialog_create(config.GetHandle(), &m_handle);
실무 대응과 남은 검증
- SoC/커널 담당자: 이번 요청의 크기·도메인·캐시 반환 전후·최종 실패 원문을 기준으로 전체 IOVA 점유와 최대 연속 빈 구간을 확인한다. 전체 MemAvailable만 보고 RAM 부족 여부를 결론 내리지 않는다.
- 앱/SDK 담당자: 실패 반환 뒤 graph/context·버퍼 정리가 완료됐는지 확인하고, 동시 초기화와 즉시 반복 재시도를 피하는 방안을 검토한다. 이번 실행으로 해당 개선이 적용·검증됐다는 뜻은 아니다.
- 풀 확대: 현재는 검토 후보이지 검증된 해결책이 아니다. 1,920MiB에서 모델 크기를 단순히 빼서 결정하지 않는다.
- 별도 커널 후보: 관측된 start_pfn 아래 반환과 관련해 상위 Linux의 IOVA overflow 수정 이력을 찾았다. anchor의 최댓값에 1을 더하는 경계 문제를 다룬다. 로컬 소스에는 해당 덧셈 형태가 있으나 실행 이미지에 대한 수정 적용 여부와 직접 분기 계측은 미검증이다. 이번 최종 -12의 원인이나 해결 패치로 확정하지 않았다.
trace는 209/209 events를 보존했다. 누적 kprobe profile에는 alloc_ret missed 8이 있으므로 전체 할당 호출 통계를 완전하다고 주장하지 않는다. 다만 이번 대형 요청의 진입, 두 관리 포인터, 두 NULL 반환, 하위 map 반환은 같은 스레드의 보존 구간에 모두 있다. NULL 반환에 딸린 부가 pfn 값은 무효로 제외했다.
근거: domain-cursor-below/6/{trace.txt,failure-excerpt.txt,profile.txt,kernel.txt,logcat.txt,result.json,failure-summary.json,cleanup.txt}, 5-unloaded.txt, 6-loaded.txt, domain-cursor-below-run.txt. 아래 과거의 “최종 -12 미재현” 문장은 각 시험 당시 결과이며 이번 재현으로 보완됐다.
후속 검증 — 작은 IOVA 예약 구간이 큰 연속 주소 범위 안에 남아 있던 사례
CPU별 캐시 반환 호출에 더해 트리에서 삭제하는 주소 범위를 계측했다. rb_erase 호출 중 복귀 주소가 현재 실행 중인 iova_magazine_free_pfns 함수 범위에 속하는 경우만 기록했다. 성공한 alloc_iova의 pfn 범위도 함께 읽어, 요청 페이지 수 및 iommu_dma_alloc_iova의 반환 주소와 대조했다. NULL 반환에 붙은 부가 pfn 값은 유효하지 않으므로 해석에서 제외했다.
이번 시험은 최대 10회 중 3회차에 첫 NULL·재시도 구간을 확보해 종료했다. 3회 모두 Genie create/free는 0이었고 앱은 유지됐다. 최종 DMA -12 실패를 재현한 시험은 아니다.
| 3회차 관측 | 값 |
|---|---|
| 대형 요청 | 432,128 pages = 1,688MiB |
| 첫 alloc_iova | 관리 포인터 non-NULL, 반환 NULL |
| 캐시 반환 중 관측한 rb_erase 대상 | 26개 범위, 합계 119 pages = 476KiB의 IOVA 주소 공간 |
| 재시도 결과 | pfn 0x21800 ~ 0x8afff, 길이 432,128 pages |
| 최종 IOVA 주소 | 0x21800000, pfn_lo × 4,096과 일치 |
| 새 범위 안에 있었던 삭제 대상 | pfn 0x8a7ff 한 페이지, 주소 0x8a7ff000 ~ 0x8a7fffff |
| 최종 map / Genie 초기화 | map 1, create 0 |
| trace 보존 | 218/218 events |
의미: 새로 확보한 1,688MiB 범위 안에, 캐시 반환 전에 트리에서 관리하던 4KiB 주소 예약이 하나 있었다. 적은 양의 캐시 주소라도 위치에 따라 큰 연속 주소 범위를 가로막을 수 있다는 구체적인 관측이다. 반환한 476KiB는 물리 RAM이나 Swap 회수량이 아니라 주소 공간 크기다. 26개는 magazine 진입 count 합계와 일치했고 rb_erase 대상의 root도 같은 도메인의 트리에 대응했다.
단, 모든 동시 할당·해제와 전체 트리의 빈 구간을 수집한 것은 아니다. 이 한 페이지가 첫 실패의 유일한 원인이라거나, 다른 위치에는 요청을 만족할 구간이 전혀 없었다고 단정하지 않는다. 전체 최종 -12 실패 원인도 아직 미확정이다.
새로 확인한 불일치 — 반환 주소와 start_pfn
같은 대형 요청 진입에서 기존 offset으로 읽은 start_pfn은 0x80000인데, 재시도 성공 pfn은 0x21800으로 더 낮았다. 성공 구조체의 pfn 범위 길이는 요청 크기와 일치하고, 하위 IOVA 함수의 반환도 0x21800000으로 일치했다. 따라서 단순히 다른 요청의 주소를 가져온 것으로 처리하지 않고 원문을 보존했다.
확정하지 않은 사항: 해당 runtime 필드 해석과 갱신, 실제 도메인 예약 범위, 실행 코드의 검색·재시도 경계 동작은 추가 확인이 필요하다. 로컬 소스의 __alloc_and_insert_iova_range()에는 검색 하한을 바꿔 재검색하는 경로가 있지만, 이번 반환 주소를 그 경로의 버그나 의도된 동작이라고 판정하지 않았다. 현재 근거로 DT의 1,920MiB 값을 모든 성공 할당의 엄격한 실행 범위로 간주하거나 1,920 − 1,688만으로 실패 원인을 계산하면 안 된다.
이 측정은 재시도 성공 사례의 주소 배치를 일부 보여 주며, 현장 Swap 3GB의 원인을 설명하지 않는다. 계측을 정리하고 앱 프로세스 유지 여부를 확인했다.
근거: domain-ranges-until-retry/3/{trace.txt,profile.txt,ranges-summary.json,logcat.txt}, 각 회차 결과, domain-ranges-run.txt. 필드 offset은 로컬 include/linux/iova.h와 앞선 runtime 관측을 사용했으며, 실행 커널 전체의 바이너리 동일성은 미검증이다.
후속 검증 — 첫 IOVA NULL 뒤 CPU별 주소 캐시 반환, 재시도 성공
이번에 새로 확보한 근거는 재시도 사이의 실제 함수 호출이다. 같은 스레드와 같은 IOVA 도메인에서 아래 순서를 관측했다. 이는 성공으로 회복된 사례이며, 최초 최종 DMA -12 실패를 재현한 것은 아니다.
| 순서 | 실제 관측 |
|---|---|
| 1 | 1,688MiB 요청, 관리 구조체 포인터 non-NULL |
| 2 | 첫 alloc_iova 반환 NULL |
| 3 | CPU 0~7의 free_cpu_cached_iovas 호출 8회 |
| 4 | iova_magazine_free_pfns 진입 96회, 그중 비어 있지 않은 magazine 22개, 진입 당시 캐시 항목 합계 39개 |
| 5 | 같은 크기·limit·도메인으로 두 번째 alloc_iova 호출, 관리 구조체 non-NULL, 할당 성공 |
| 6 | iommu_dma_alloc_iova가 0x8b800000 반환, __msm_dma_map_sg는 1 반환 |
| 7 | Genie create/free 모두 0, 앱 유지 |
trace는 192/192 events, kprobe profile의 missed 수는 0이었다. 39는 캐시 항목 개수이지 39페이지나 39MiB가 아니다. magazine 입력의 count를 읽은 값이며, 개별 주소 범위의 해제 결과·총 bytes·가장 큰 빈 구간은 계측하지 않았다. global cache 함수 진입은 관측되지 않았으므로 실제 호출된 CPU별 경로만 확정한다.
로컬 플랫폼 drivers/iommu/iova.c:alloc_iova_fast()는 첫 할당 실패 시 CPU별 캐시를 비우고 재시도하는 코드를 갖고 있다. iova_magazine_free_pfns()는 캐시에 보관된 IOVA 범위를 트리에서 반환하는 경로다. 이번 trace는 이 CPU별 반환 경로가 첫 실패와 재시도 성공 사이에 실행됐다는 직접 근거다. 실행 커널 전체와 로컬 소스의 바이너리 동일성까지 증명한 것은 아니며, 다른 스레드의 동시 해제 여부와 주소 공간 전체 배치도 관측하지 않았다. 따라서 캐시 반환만이 성공의 유일한 원인이었다거나 특정 연속 구간을 만들었다고 확정하지 않는다.
이름이 비슷한 세 가지 메모리 항목을 구분해야 한다
| 항목 | 무엇을 보관하나 | 이번 결과 |
|---|---|---|
| IOVA 주소 캐시 | 장치 매핑에 쓰는 가상 주소 범위 | 첫 주소 할당 실패 뒤 CPU별 반환 경로 실행, 재시도 성공 |
| ION 페이지 풀 | 재사용할 물리 메모리 페이지 | 앞선 시험에서 모델 해제 후 약 1.7GiB 풀 증가 확인. 이번 주소 캐시 반환과 같은 동작이 아님 |
| 앱 Swap / zram | swap-out된 메모리 페이지 / 압축 저장 공간 | 이번 5회에서 앱 VmSwap은 3,916kB 유지. 주소 캐시를 비웠다고 Swap이 해제됐다는 뜻이 아님 |
이번 계측은 선행 3회 모두 정상 완료 후, 최대 10회로 제한한 추가 시험에서 2회차에 재시도 구간을 확보해 종료했다. 합계 5회 create/free 성공, 최종 DMA -12는 미재현이다. 선행 첫 회에는 com.android.keychain이 LMKD로 종료됐고 나머지 4회 구간에는 kill 로그가 없었다. 이 횟수로 현장 발생률을 추정하지 않는다. 계측 프로브·서버·포트 전달을 정리했다.
남은 판단: IOVA 주소 캐시에 남은 범위가 큰 요청의 첫 할당에 영향을 줄 수 있다는 설명은 이번 성공 사례와 부합한다. 그러나 최초의 최종 -12는 두 번 모두 실패했으므로, 캐시 반환 이후에도 남아 있던 실제 점유 범위·연속 주소 구간·관리 구조체 상태를 그 실패 순간에 확보해야 한다. 지금 단계에서 IOVA pool 확대나 캐시 강제 flush를 제품 해결책으로 적용하지 않는다.
근거: domain-cache-until-retry/2/{trace.txt,profile.txt,cache-summary.json,logcat.txt,result.json}, domain-cache-repeat3/, domain-cache-until-retry/, 각 run 로그. 앞선 “재시도 사이 경로 미확정” 기록은 당시 한계이며, 이번 CPU별 경로 실측으로 일부 보완됐다.
후속 검증 — 계측을 좁힌 3회 재로드, trace 유실 없이 완료
직전 상세 slab 계측의 로그 유실을 보완했다. 범용 slab 반환 프로브를 제거하고, 직전 실행 trace에서 kmem_cache_alloc의 복귀 지점으로 확인한 alloc_iova+0x48에서 반환 레지스터 x0만 수집했다. 이 offset은 현재 보드의 실행 함수에 대한 것으로 다른 커널 빌드에 그대로 적용할 수 없다. 앱 TID 필터와 monotonic trace clock을 사용했다.
| 항목 | 1회 | 2회 | 3회 |
|---|---|---|---|
| 모델 create / free 반환 | 0 / 0 | 0 / 0 | 0 / 0 |
| trace 보존 / 기록 이벤트 | 82 / 82 | 91 / 91 | 94 / 94 |
| 관측 alloc_iova 진입·관리 포인터 수집 수 | 11 / 11 | 12 / 12 | 13 / 13 |
| 관리 포인터 NULL | 0 | 0 | 0 |
| 1,688MiB 요청의 내부 alloc_iova 시도 수 | 1 | 2 | 1 |
| 내부 alloc_iova NULL 반환 | 0 | 1 | 0 |
| 모델 해제 후 앱 VmRSS | 228.7MiB | 229.3MiB | 230.1MiB |
| 모델 해제 후 앱 VmSwap | 3,916kB | 3,916kB | 3,916kB |
kprobe profile의 missed 수는 모두 0이었다. 2회차의 대형 요청은 관리 포인터 non-NULL → 첫 alloc_iova NULL → 관리 포인터 non-NULL → 재시도 성공 → 최종 map 성공으로 끝났다. 따라서 앞선 로그 유실 구간에만 의존하지 않고, 보존된 전체 trace에서도 “내부 첫 NULL이 최종 DMA 실패와 같지 않다”는 것을 확인했다.
세 번 모두 같은 PID에서 초기화·해제가 완료됐고 앱은 종료되지 않았다. 단, 1회차 구간에서 android.process.acore와 제품 UI가 LMKD로 종료됐다. 2·3회차 수집 구간에는 kill 로그가 없었다. 성공률 100%의 일반 보장이나, 계측 제거만으로 LMKD가 해결됐다는 인과관계로 해석하지 않는다. 실행 전 시스템 상태가 달랐고 비계측 대조군 시험도 아니다.
이번에 좁힌 것: 관리 구조체 할당 실패와 IOVA 주소 확보 실패를 분리할 수 있는 계측을 확보했고, 3회에서는 관리 포인터 NULL 및 최종 DMA -12가 관측되지 않았다. 앱 Swap 3GB도 재현되지 않았다. 모델 해제 후 RSS의 작은 차이를 장기간 누수의 증거 또는 부재 증거로 삼지 않는다.
아직 필요한 것: 최초 최종 -12 실패와 같은 상황에서, 이번 방식으로 관리 포인터·두 차례 주소 할당·최종 map 반환을 함께 확보해야 한다. 현재 결과만으로 당시 실패를 관리 구조체 부족 또는 IOVA 연속 구간 부족 중 하나로 확정할 수 없다.
모든 프로브와 계측 서버, 포트 전달을 정리했다. 근거: domain-focused-repeat3/{focused-summary.json,events.jsonl,*-loaded.txt,*-unloaded.txt,1/trace.txt,2/trace.txt,3/trace.txt,2/large-map-excerpt.txt}, 각 회차 profile.txt·logcat.txt, domain-focused-repeat3-run.txt.
추가 실측 — 첫 IOVA NULL 뒤 매핑은 성공, 이후 LMKD 종료
DMA 매핑 -12 재현을 위해 최대 3회로 제한한 상세 계측을 시작했다. 첫 로드에서 앱이 LMKD로 종료되어 1회만 수행했고 중단했다. 이번에도 목표인 dma_buf_map_attachment … ret -12와 Failed to map weights buffer to device의 동시 재현은 없었다.
다만 이번에는 동일 로드에서 1,688MiB 버퍼의 IOVA 재시도 성공 → DMA map 성공 → 앱 LMKD 종료를 구분할 근거를 확보했다.
| 보존된 같은 스레드의 trace 순서 | 실제 반환·입력 | 해석 |
|---|---|---|
iommu_dma_alloc_iova 진입 |
1,769,996,288 bytes | 1,688MiB 요청 |
첫 alloc_iova |
432,128 pages, limit 0xf7fff |
granule 4,096, start 0x80000 |
내부 kmem_cache_alloc |
non-NULL | 이 호출의 관리 구조체 할당은 성공 |
첫 alloc_iova 반환 |
NULL | 이것만으로 최종 map 실패는 아님 |
두 번째 alloc_iova의 내부 slab 할당 |
non-NULL | 재시도의 관리 구조체도 확보 |
두 번째 alloc_iova 반환 |
non-NULL | 재시도 성공 |
iommu_dma_alloc_iova 반환 |
0x8b200000 |
IOVA 주소 확보 |
__msm_dma_map_sg 반환 |
1 | 이 버퍼의 map 호출 성공 |
| 이후 앱 LMKD 종료 | RSS 2,045.96MiB, Swap 3.82MiB | critical pressure and device is low on memory |
첫 내부 할당 실패를 물리 RAM의 관리 구조체 할당 실패로 설명할 수는 없다. 해당 구간에서는 실제 slab 반환이 non-NULL이었다. 다만 재시도 사이 어느 경로가 주소 공간을 확보했는지는 이번 계측만으로 확정하지 않았다. 또한 한 버퍼의 map 성공은 Genie 초기화 전체 성공이 아니며, GenieDialog_create의 성공 반환은 관측하지 못했다.
제품 UI와 입력기 프로세스도 같은 시험 구간에서 종료됐다. 앱은 이후 새 프로세스로 재시작했으며 모델 초기화 완료를 의미하지 않는다. 이번 결과를 근거로 현장 전체의 실패율이나 RSS 분포를 추정하지 않는다.
이번 상세 계측의 한계
범용 slab 반환까지 계측하면서 trace 기록량이 커졌다. 버퍼에는 386,027개 중 67,150개가 남아 앞부분이 덮어써졌다. 각 kretprobe의 missed 수는 0이지만, 이것이 ring buffer 손실이 없다는 뜻은 아니다. 위 대형 요청의 진입·내부 slab 반환·재시도·최종 map 반환은 같은 스레드의 연속 구간에 남아 있어 해당 구간만 해석했다. 전체 요청의 실패/성공 횟수를 이 파일로 계산하지 않는다.
프로브 자체의 실행 비용이 압박과 타이밍에 영향을 줄 수 있으므로 이번 종료를 비계측 제품의 대표 성능으로 취급하지 않는다. 다음 실패 재현에서는 범용 slab 이벤트 기록을 줄여야 한다. 임의 메모리 압박 도구나 LMKD 정책 변경은 사용하지 않았다. 프로브·계측 서버·포트 전달을 정리했다.
현재 구분: 최종 ret -12로 끝나는 DMA 실패와, 중간 NULL을 회복해 map은 성공했지만 이후 LMKD로 종료되는 경우는 서로 다르다. 최초 확보한 최종 DMA 실패의 세부 내부 원인은 여전히 미확정이다.
근거: domain-slab-repeat3/1/{trace.txt,large-map-excerpt.txt,profile.txt,kernel.txt,logcat.txt,result.json}, domain-slab-repeat3/events.jsonl, domain-slab-repeat3-run.txt.
추가 실측 — NPU 버퍼 1,708MiB와 ION 풀의 이동, 종료 시 zone 22.9MiB
직전 초기화 중 종료 이후 새 PID에서 LLM 로드·해제 1회를 계측했다. 이번에는 create/free 모두 0으로 완료됐고 앱은 유지됐다. 단, 로드 중 제품 UI 프로세스가 LMKD로 종료되어 시스템 영향 없는 성공으로 표현할 수는 없다. 같은 실행에서 ION 풀, 할당 버퍼, 앱 Swap 및 LMKD zone 입력을 수집했다.
모델 해제 후 1.7GiB는 어디에 남았나?
| 항목 | 로드 전 | 로드 완료 | 모델 해제 후 |
|---|---|---|---|
| 시스템 ION 풀 | 1,698.0MiB | 6.1MiB | 1,714.4MiB |
| 시스템 ION 할당 버퍼 총량 | 68.1MiB | 1,776.4MiB | 68.1MiB |
| 시스템 ION 버퍼 수 | 89 | 97 | 89 |
| 앱 VmSwap | 3,784kB | 3,912kB | 3,912kB |
| 앱 smaps RSS | 189.9MiB | 371.0MiB | 220.7MiB |
로드 시 새 DMA-BUF 8개, 합계 1,708.273MiB가 생겼고 해제 후 해당 inode들이 사라졌다. 전체 ION DMA-BUF inode/크기 목록도 로드 전과 해제 후가 일치했다. 시스템 ION 할당 총량 증가와 같은 크기이며, 해제 시 할당 총량이 원복되고 풀은 1,708.273MiB 증가했다. 값들은 순차 스냅샷이므로 페이지별 이동을 직접 추적했다는 뜻은 아니다.
이번 성공 사례에서는 모델 해제 후 큰 DMA 버퍼 객체가 사라지고 ION 풀에 메모리가 남는 패턴을 확인했다. 앱 Swap에 1.7GiB가 쌓인 패턴이 아니다. 풀의 물리 페이지는 버퍼 객체 해제와 동시에 모두 buddy allocator로 돌아가는 것은 아니며, 별도 회수 정책의 대상이다. 풀의 전체 용량을 앱 전용 메모리로 귀속하거나, 즉시 사용 가능한 모든 zone의 여유로 해석하지 않는다.
전체 MemFree 약 1.2GiB인데 제품 UI가 종료된 순간
| 같은 이벤트의 근거 | 값 |
|---|---|
| LMKD zone uprobe 시각 (mono) | 186593.838670초 |
| zone 합산 free | 5,871 pages = 22.93MiB |
| 합산 CMA | 0 pages |
| 합산 high / low / min | 100.36 / 98.75 / 70.46MiB |
| pgskip 로그 | 0 / 28,599 |
| 제품 UI 종료 로그 시각 (monotonic) | 186593.842초 |
| 같은 killinfo 전체 MemFree | 1,250,420kB = 1,221.1MiB |
| 종료된 제품 UI RSS / Swap | 109.99MiB / 3.85MiB |
실행 /system/bin/lmkd의 SHA-256이 앞서 분석한 바이너리와 같은지 재검증한 뒤 같은 offset을 계측했다. trace clock을 mono로 설정하고 logcat도 monotonic으로 읽었다. trace는 11/11 events를 보존했다. 해당 이벤트에서 LMKD 합산에 들어간 free는 전체 MemFree보다 훨씬 작고 min보다도 작았다. 이 값은 최종 모든 보정값을 포괄한 임계값이라고 주장하지 않으며, zone 합산 지점의 값이다.
약 41ms 뒤에는 zone free가 324,958 pages(약 1,269MiB)로 바뀌고 pgskip이 0/0으로 바뀌었다. 이 차이를 그 사이 제품 UI 종료만으로 1.2GiB가 새로 생긴 것으로 해석하면 안 된다. 합산에 포함되는 zone이 달라진 기존 코드 분석과 함께 읽어야 한다.
현재 가장 구체적인 설명: LLM 로드 시 시스템 공유 버퍼의 큰 물리 메모리 수요가 발생하며, 전체 여유량과 별개로 LMKD가 보는 zone 합산 여유가 작아져 종료가 발생할 수 있다. 이번에는 우선순위가 낮은 제품 UI(oom_score_adj 500)가 선택됐고 앱은 생존했다. 직전 앱 종료(oom_score_adj 200)나 현장 10대에 이번 숫자를 그대로 대입하지 않는다. 물리 메모리 수요가 어떤 allocation/zone에서 압박을 만들었는지의 페이지별 인과관계는 추가 검증이 필요하다.
계측 이벤트·Frida 서버·포트 전달을 정리했고 앱 PID 유지 및 trace 비활성화를 확인했다. 계측 설정 첫 시도는 uprobe 등록 명령 오류로 모델 로드 전에 중단됐으며, 수정 후 위 1회를 수행했다.
근거: zone-swap-lifecycle/{events.jsonl,smaps-summary.json,ion-summary.json,inode-summary.json,*-dmabuf.txt,*-ion.txt,*-memory.txt,logcat-final.txt}, zone-swap-trace.txt, zone-swap-logcat-mono.txt, zone-swap-run2.txt.
추가 실측 — Swap 3GB 없이도 초기화 중 LMKD 발생
2026-10-16 23:30, STT 단독 3회 시험을 마친 동일 프로세스에서 LLM 로드 1회를 추가했다. STT 객체는 이미 해제했고 이번에 STT/TTS를 새로 실행하지 않았다. 다만 앞선 시험의 할당 이력이 있는 프로세스이므로 깨끗한 신규 프로세스의 LLM 단독 시험과 동일하지 않다. 초기화 완료 전에 프로세스가 종료되어 계획했던 load/free 비교는 완료하지 못했다.
| 관측 | 결과 | 의미 |
|---|---|---|
| Genie create 진입 | 23:30:18.530 | 반환 성공은 관측하지 못함 |
| 앱 LMKD 종료 | 23:30:21.725, RSS 424.3MiB, Swap 3.66MiB, oom_score_adj 200 | 큰 Swap이 이번 종료의 필수 조건은 아니었음 |
| 종료 사유 원문 | critical pressure and device is low on memory |
앱 RSS의 고정 상한을 넘었다는 로그가 아님 |
| 같은 종료 이벤트의 전체 MemFree | 1,189.0MiB | 전체 여유 RAM만으로 종료 여부를 설명할 수 없음 |
| 바로 앞 zone 집계 로그 | pgskip 0 / 1 |
이전에 확인한 zone 제외 경로와 부합. 이번에는 zone uprobe를 설치하지 않았으므로 실제 유효 free/watermark 값까지 단정하지 않음 |
| DMA 실패 문자열 | 수집 구간에 대상 dma_buf_map_attachment … ret -12 및 QNN weights mapping 실패 미관측 |
DMA 실패 재현 횟수에 포함하지 않음 |
원문 핵심: Kill 'com.skmagic.ondeviceai.agent' ... oom_score_adj 200 to free 434472kB rss, 3752kB swap; reason: critical pressure and device is low on memory.
따라서 현장 Swap 3GB의 원인과 LMKD가 동작하는 조건은 따로 설명해야 한다. 이번 결과는 “Swap이 3GB가 되어야 앱이 종료된다”는 설명을 지지하지 않는다. 반대로 현장 10대의 원인이 이번과 같다는 증거도 아니다. 제품 UI 프로세스도 앞서 종료됐으므로 시스템 부하와 회수 상태가 함께 영향을 준 시험이다.
ION 풀과 zram을 분리해서 읽기
다음은 순차 수집한 전후 스냅샷이다. 종료 순간의 동시 값이 아니고, 전후 차이를 전부 해당 앱의 기여로 배분할 수 없다.
| 지표 | 로드 전 | 종료 후 별도 수집 |
|---|---|---|
| 시스템 ION 풀 | 886.2MiB | 1,698.0MiB |
zram 전체 저장 원본 크기 (orig_data_size) |
127.8MiB | 130.4MiB |
zram 압축 데이터 크기 (compr_data_size) |
32.8MiB | 33.5MiB |
zram 할당 RAM (mem_used_total) |
35.2MiB | 35.5MiB |
mm_stat 첫 세 필드는 로컬 플랫폼 drivers/block/zram/zram_drv.c:mm_stat_show()의 출력 순서를 확인해 해석했다. 실행 커널 전체와 소스의 바이너리 일치까지 검증한 것은 아니다. 이 보드에는 bd_stat 항목이 없어 해당 값은 수집하지 않았다.
ION 풀 약 1.7GiB와 앱 Swap 약 3.7MiB는 다른 회계 항목이다. 풀 증가를 앱 Swap 누적으로 표현하면 안 된다. zram 통계 또한 시스템 전체 값이므로 특정 앱의 압축 RAM 사용량으로 읽을 수 없다. 현장의 앱 Swap 3GB에 이 시험의 압축 비율을 곱해 실제 RAM 사용량을 추정하지 않는다.
앱 프로세스는 새 PID로 재기동된 것을 확인했다. 이는 서비스 재시작의 증거이며 LLM 정상 초기화 완료 증거는 아니다. 계측 서버와 포트 전달은 정리했다.
근거: ion-swap-lifecycle2/{events.jsonl,baseline-memory.txt,baseline-ion.txt,baseline-zram.txt,logcat-final.txt,post-ion.txt,post-zram.txt,post-status.txt,summary.json}. 선행 수집 1회는 선택 항목 bd_stat 부재로 모델 로드 전에 종료되었으며 모델 시험 횟수에 포함하지 않았다.
추가 실측 — STT 단독 3회 재로드에서 해제 후 누적 증가는 미관측
LLM 동시 시험이 LMKD로 중단됐던 조건을 분리하기 위해, 이번에는 새 LLM 로드 없이 같은 PID 22128에서 격리 STT 객체를 3회 생성·디코드·해제했다. CPU SenseVoice 한국어 모델, 1 thread, 매회 1초 합성 무음 입력을 사용했다. 세 회 모두 decode 완료와 release 반환을 확인했고 서비스 recognizer 필드는 계속 null이었다. 실제 마이크 인식·정확도·전체 서비스 시험은 아니다.
| 단계 | smaps RSS | smaps Anonymous | VmSwap |
|---|---|---|---|
| 시작 | 226.80MiB | 124.14MiB | 3,684kB |
| 1회 디코드 후 | 738.55MiB | 621.98MiB | 3,680kB |
| 1회 해제 후 | 316.46MiB | 199.89MiB | 3,680kB |
| 2회 해제 후 | 314.74MiB | 198.17MiB | 3,680kB |
| 3회 해제 후 | 314.12MiB | 197.55MiB | 3,680kB |
각 회 해제 시 RSS 약 421~422MiB가 감소했다. 첫 시험 전과 마지막 해제 후에는 RSS 약 87.31MiB, Anonymous 약 73.40MiB 차이가 남았다. 영역별 RSS 차이는 Scudo primary +40,816kB, secondary +33,008kB, APK 매핑 +14,848kB 등이었다. 영역 이름은 할당 소유 함수나 누수의 증명이 아니며, native allocator 보유량·라이브러리 초기화·계측 영향 등을 별도 구분해야 한다.
이번 범위의 결론: 해제 후 RSS는 316.46 → 314.74 → 314.12MiB로 안정됐고 Swap 증가는 없었다. 순차 STT 재로드마다 계속 누적되어 3GB가 되는 패턴은 이 3회 시험에서 관측되지 않았다. 첫 회 후 남은 메모리를 모두 정상 캐시라고 확정하거나 장시간·실제 음성 입력·다른 언어·동시 재진입의 누수를 배제하는 결과는 아니다. 해당 시험 구간 logcat에는 LMKD kill 줄이 없었고 동일 PID가 유지됐다.
근거: 내부 stt-only-repeat3/{baseline-smaps.txt,1-stt-freed-smaps.txt,2-stt-freed-smaps.txt,3-stt-freed-smaps.txt,smaps-summary.json,retained-group-delta.json,logcat.txt}, stt-only-repeat3-run.txt. 마지막 release 및 진단 서버 정리 완료. 이 시험에서도 현장 3GB Swap은 재현되지 않았다.
음성 엔진 점검 — 정상 교체의 미해제·TTS 이중 생성 가설 구분
현재 앱 소스와 app/libs/sherpa-onnx-1.11.3.aar의 classes.jar를 직접 확인했다. 이 결과는 현장 설치 APK와 동일성을 입증한 것은 아니다.
- STT 정상 교체:
ForegroundService.initializeSTT():701-704는 새 recognizer 생성 전에stopSttModel()을 호출한다.:1439-1448에서 기존 객체의 release를 호출한다. 따라서 순차 언어 변경에서 항상 이전 모델을 그대로 둔다는 설명은 맞지 않는다. 다만 해제 부분만 동기화되어 전체 stop→create→assign의 동시 재진입은 별도 검증이 필요하다. - TTS 정상 교체:
initTts():1466은 busy 여부 확인 후stopTtsEngine()을 호출한다.TtsPlaybackRunner.close():121은 실행 중 작업이 없으면 즉시 release를 실행하고, 작업이 남아 있으면 실제 완료 후 release하도록 보관한다. 취소 요청만으로 네이티브 생성이 끝났다고 간주하지 않는 구조다. 종료를 기다리는 동안의 보유와 영구 누수는 구분해야 한다. - 생성자 다음 allocate가 두 번 로드하는가: AAR의 OfflineTts 생성자는 네이티브 ptr을 저장한다.
allocate()바이트코드는 ptr==0일 때만 newFromAsset/newFromFile을 호출한다. 정상 생성된 객체에서 뒤이어 호출하는 allocate는 두 번째 모델 생성이 아니다. - release가 GC를 기다리는가: 해당 AAR의 TTS와 recognizer는 release가 finalize 메서드를 직접 호출하고, 그 안에서 native delete 후 ptr=0으로 설정한다. 이 직접 호출을 JVM의 나중 GC 실행과 혼동하지 않는다. native delete가 allocator pool까지 모두 OS에 즉시 반환한다는 증명은 아니다.
좁혀진 판단: 정상 순차 교체에서 해제 호출 자체가 없거나 TTS 생성자+allocate가 항상 모델 두 벌을 만든다는 가설은 현재 소스·AAR와 맞지 않는다. 남은 검증 대상은 동시 재진입, 실패한 생성의 SDK 내부 정리, 실제 네이티브 해제량, 살아 있는 엔진의 ORT arena 유지량이다. 이 네 항목을 현재 확인된 누수 또는 3GB Swap의 원인으로 확정하지 않는다. TTS arena 회수 ON/OFF는 이와 별도로 단독 측정한 절충안이다.
근거: 위 소스 위치 및 내부 tts-lifecycle-audit/{OfflineTts.javap.txt,OfflineRecognizer.javap.txt,classes.jar,artifact-sha256.json}. 앱·라이브러리 수정이나 설치, 추가 모델 로드는 하지 않았다.
소스 점검 — 중복 초기화와 완료 판정은 별도 검증 필요
이번에는 추가 보드 부하 없이 현재 feature/feature_mr9 소스를 점검했다. 아래는 소스에서 확인한 경로이며, 현장 A1_1.8.0의 APK 또는 현재 설치 바이너리와 전체 코드 일치를 입증한 결과가 아니다.
호출 경로: DeviceCommunicator.onServiceConnected():608-624 → 서비스 callback onConnected() → ForegroundService.initializeApp() → initializeLLAMA() → QaClient.Init() → JNI 전역 g_dialog.Init() → GenieDialog_create().
| 점검 사항 | 소스 근거 | 의미와 검증 한계 |
|---|---|---|
| 초기화 중 재진입 방지 | ForegroundService.kt:390-398에서 완료 플래그를 검사한 뒤 coroutine을 시작하고, 초기화 반환 후 true로 설정 |
초기화 완료 전 두 번째 콜백이 오면 둘 다 검사 통과 가능한 구조. 실제 재연결·동시 실행은 미관측. |
| LLM 실행 직렬화 | 같은 파일 :298-299, :751에 Default serviceScope 및 4-thread LLM dispatcher |
단일 스레드에 의한 직렬화를 보장하지 않는다. JNI도 전역 g_dialog를 공유하고 Init/UnInit에 잠금이 없다. |
| 중복 create 시 위험 | native-lib.cpp:9-28, main.cpp:231-249의 handle 검사 후 create |
두 호출이 NULL 검사를 함께 통과하면 같은 handle 저장 위치에 create를 겹쳐 요청할 가능성. 핸들 덮어쓰기·누수 여부는 SDK 동작과 실제 동시 호출 증거가 필요. |
| 실패 후 재시도 | ForegroundService.kt:751-777 최대 3회, 간격 1초 |
지속 압박 중 초기화 부하를 반복할 가능성. 순차 재시도 자체가 3GB 누수라는 증거는 아님. |
| 전체 초기화 완료 판정 | ForegroundService.kt:485-492는 LLM/STT/TTS가 모두 false일 때만 중단 |
LLM 실패·STT/TTS 성공이면 Ready 경로로 진행 가능. “Ready 표시”만으로 LLM 정상 복구 판정 불가. |
| 호출자 완료 플래그 | ForegroundService.kt:397-398는 initializeApp 반환 후 true |
함수가 실패 분기로 조기 반환해도 호출자가 성공 결과를 받아 구분하는 구조가 아니다. 복구 판정 로그 보강이 필요. |
현실적인 개선 후보: 초기화 중 작업을 하나만 유지하고 중복 콜백은 같은 작업 결과를 기다리게 하기, 필요한 엔진별 성공 여부로 Ready를 판정하기, 모델 생명주기와 추론의 동시 실행을 제어하기, 지속 압박에서는 재시도를 늦추기. 이는 아직 적용·검증한 수정이 아니다. 실제 재진입 시험과 실패 주입으로 동작을 확인한 뒤 구현해야 한다.
메모리 해제 경로도 구분했다. JNI의 DsLog와 DsConfig는 지역 객체이고 소멸자에서 UnInit을 호출한다. 따라서 “재시도마다 지역 config/log가 아무 정리 없이 남는다”는 설명은 현재 소스와 맞지 않는다. DsDialog::Init은 create 실패 때 handle을 NULL로 덮지만, SDK가 실패 때 유효한 핸들을 반환했는지 확인하지 못했으므로 부분 할당 누수로 확정하지 않는다. free 실패 때도 handle을 지우는 경로는 오류 처리 검토 대상이다.
DsLog::UnInit의 logging 활성 분기에 잘못된 GenieDialogConfig_free 호출도 보이지만, 현재 CMake는 NO_LOGGING을 정의해 GenieLog_free 분기를 선택한다. 이를 현재 실행 경로의 3GB 원인으로 제시하지 않는다.
근거: 현재 작업 트리의 app/src/main/java/com/skmagic/ondeviceai/agent/service/{DeviceCommunicator.kt,ForegroundService.kt,QaClient.java}, app/src/main/cpp/{native-lib.cpp,main.cpp,CMakeLists.txt}. 소스 수정·APK 교체·재연결 유발 시험은 수행하지 않았다. 현재 보드의 APK/런타임/모델/설정 9개 파일 해시는 내부 current-deployment-manifest.json에 확보했으나 현장 배포본과 대응은 미확인이다.
핵심 실측 — 초기화 RSS 2,078MiB 중 1,690.5MiB는 clean 모델 파일
새 PID 22128에서 LLM 초기화·해제 1회를 완료했다(Genie create/free 모두 0). full smaps와 상태·zone·ION pool을 순차 수집했고 trace clock은 이번에는 명시적으로 mono를 설정·확인했다. 앱은 생존했지만 keychain과 permissioncontroller가 LMKD로 종료됐으므로 시스템 무영향 시험은 아니다.
| 단계 | smaps 합산 RSS | smaps 합산 Anonymous | 모델 파일 매핑 RSS |
|---|---|---|---|
| 시작 | 190.20MiB | 90.51MiB | 없음 |
| 초기화 중 관측 최대 | 2,077.78MiB | 282.78MiB | 1,690.50MiB |
| 초기화 완료 | 379.45MiB | 274.89MiB | 매핑 없음 |
| 모델 해제 후 | 229.03MiB | 124.51MiB | 매핑 없음 |
최대 표본의 /system/etc/model/kvcache_1_of_1.serialized.bin은 r--p, Size/RSS/Private_Clean 각각 1,731,072kB, Anonymous/Swap/Private_Dirty 각각 0이었다. 이번 큰 RSS 피크의 대부분은 익명 메모리가 아니라 모델 파일 페이지다. 파일명에 kvcache가 있다는 이유로 이 매핑을 런타임 KV cache라고 단정하지 않는다. 초기화 완료 후 매핑 소멸은 확인되지만 시스템 파일 캐시의 물리 페이지가 모두 즉시 반환됐다는 뜻도 아니다.
이 관측은 초기화 도중 RSS가 크게 변할 수 있는 구체적인 원인을 보여준다. clean 파일 매핑 자체가 익명 메모리 3GB처럼 Swap에 누적됐다는 증거는 아니다. 파일 페이지와 NPU 버퍼의 동시 존재가 메모리 압박에 기여할 가능성을 조사해야 하지만, 이 둘을 단순 합산해 중복 없는 물리 사용량으로 확정하지 않는다. 현장 장기 구동 후 RSS 800~1,400MB 편차 전체를 이번 초기화 피크 하나로 설명하지도 않는다.
측정 한계: 최대 표본은 loading 단계의 full smaps 합산이고, 같은 수집 묶음에서 뒤이어 읽은 VmRSS는 386,272kB였다. 약 0.59초 수집 중 초기화 상태가 바뀐 것으로 볼 수 있어 두 값을 같은 순간으로 취급하지 않는다. 다음 full smaps에서 파일 매핑은 사라졌다. 전체 32개 표본은 비원자적·간헐 측정이므로 실제 순간 최대를 보장하지 않는다. 최대 표본의 smaps Swap 합계는 3,836kB이며, 뒤이어 읽은 VmSwap은 3,684kB였다. 두 계정도 동일 지표로 혼용하지 않는다.
근거: 내부 init-pressure-samples/{0008-smaps.txt,0008-brief.txt,0009-smaps.txt,0032-smaps.txt,samples.jsonl,smaps-summary.json,logcat.txt}, init-pressure-trace/{clock.txt,load-run.txt}. 모델 해제 및 프로브 정리 완료. 이 시험에서 현장 3GB Swap은 재현되지 않았다.
핵심 추가 확인 — 종료 후 1.7GiB 풀과 종료 직전 회수 가능량은 다르다
모델 종료 후 풀에 1.7GiB가 남았다는 측정은, 초기화 중에도 그만큼 회수 가능한 풀이 남았다는 뜻이 아니다. 직전 시험의 원본 trace에서 nr_to_scan=0 조회 반환값을 다시 분석했다. 같은 kswapd 호출 흐름의 6개 일반 풀 조회를 묶으면 아래와 같다. 새 모델 로드는 수행하지 않았다.
| 시점 | 6개 풀의 조회 반환값 합계 |
|---|---|
| 초기 관측, trace 183959.2408초 | 434,700페이지 ≈ 1,698.05MiB |
| 마지막 구간, trace 183968.6454초 | 16페이지 = 64KiB |
| 앱 종료 후 디버그 통계 | 1,780,875,264bytes ≈ 1,698.38MiB |
첫 조회 반환값은 2 / 321,018 / 0 / 13,328 / 0 / 100,352페이지였다. 마지막 구간은 0 / 0 / 16 / 0 / 0 / 0페이지였다. 각각 약 수십 마이크로초에 걸친 연속 조회이므로 완전한 원자적 스냅샷은 아니다. 다른 kswapd 스레드의 종료 근접 조회에서도 합계 16페이지가 관측됐다.
현재 가장 설득력 있는 해석은 로드 중 풀의 페이지가 사용 중 버퍼로 이동하고, 종료 후 풀로 돌아왔다는 것이다. 다만 alloc/free의 페이지별 대응은 수집하지 않았으므로 이것을 모델 버퍼의 정확한 소유권 증명으로 표현하지 않는다. 수집 구간에서 회수 함수가 반환한 63.05MiB는 풀 감소 약 1.7GiB 전체와 같지 않다. 따라서 풀 감소를 모두 시스템으로 회수한 양으로 계산해서도 안 된다.
시간 정합성도 확인했다. 같은 PID·RSS·Swap의 LMKD 원문을 logcat -v monotonic으로 다시 읽었을 때 종료 시각은 183968.847초였다. 원본 수집 스크립트는 trace clock을 명시하거나 저장하지 않았다. 사후 기본 clock은 local로 확인됐으며, 별도 인스턴스에서 log-before → trace-marker → log-after를 기록했을 때 184240.777 → 184240.790188 → 184240.805초로 순서가 맞았다. 약 0.2초 앞선 위 풀 조회는 종료 전 구간으로 해석할 근거가 있지만, 사후 보정이고 local clock의 CPU 간 정합성을 엄밀히 보장하지는 않으므로 밀리초 단위 지연의 확정값으로 사용하지 않는다. 다음 동시 계측에는 mono clock과 명시적 마커를 사용해야 한다.
이 결과로 배제되는 설명: “회수 가능한 ION 풀 1.7GiB를 그대로 방치해서 LMKD가 죽였다.” 실제 조회상 초기화 마지막 구간의 가용 풀은 매우 작았다. 남은 과제는 사용 중 버퍼의 물리 영역과 초기화 임시 메모리, zone별 여유와 LMKD 결정을 같은 시간축으로 수집하는 것이다. IOVA 매핑 실패와 현장 앱 Swap 3GB는 여전히 별도 분석 축이다.
근거: 내부 ion-load-trace/{paired-events.json,trace.txt,logcat-monotonic.txt,calibration-clock.txt,calibration-trace.txt,calibration-log.txt,after.txt}. 이번 작업은 기존 로그 분석과 짧은 시계 보정만 수행했으며 추가 초기화는 하지 않았다.
추가 검증 — ION 풀 회수는 실제 동작하지만 LMKD 종료도 발생
“ION 풀은 전혀 회수되지 않는다”는 가설은 이번 계측과 맞지 않는다. 보드의 ion_msm_page_pool_shrink 진입/복귀를 kprobe/kretprobe로 관측했다. 먼저 30초 대기에서는 호출 0회였다. 이어 LLM 초기화 1회와 종료 후 수집을 포함한 구간에서는 아래 결과를 얻었다. 강제 메모리 압박이나 pool shrink 명령은 사용하지 않았다.
| 계측 항목 | 결과 |
|---|---|
| 진입·복귀 짝 | 3,852쌍 |
nr_to_scan=0 가용량 조회 |
3,540회 — 회수량에서 제외 |
nr_to_scan>0 실제 회수 요청 |
312회 |
| 회수 요청 중 양수 반환 | 169회 |
| 회수 요청 반환값 합계 | 16,140페이지 = 63.05MiB |
| trace 기록 / 보관 | 7,704 / 7,704 이벤트 |
| kprobe/kretprobe missed | 각각 0 |
로컬 소스 ion_msm_page_pool.c:200-231에서 scan=0 반환은 풀 크기 조회이며, scan>0은 풀에서 페이지를 빼서 free 후 페이지 수를 반환한다. 둘을 구분해 계산했다. 이는 실행 함수의 반환값 관측이며 물리 페이지별 추적은 아니다. 합계는 전체 수집 구간의 총 회수량이므로, 전부 LMKD 종료 전에 회수됐다거나 시스템 free의 순증가량이라고 해석하지 않는다.
이 시험의 앱 PID 20684는 22:52:00.337에 RSS 1,754,848kB (1,713.72MiB), Swap 3,632kB (3.55MiB)로 LMKD 종료됐다. 같은 killinfo의 전체 MemFree는 1,287,848kB였다. 정상 초기화/해제 완료 시험이 아니며 DMA 매핑 실패로 판정하지 않는다. 재사용 풀 전체는 수집 전 1,780,531,200bytes, 종료 후 1,780,875,264bytes였다. 풀은 할당·반환·회수가 함께 진행되므로 전후 크기 차이가 총 회수량과 같을 필요는 없다.
현재 좁혀진 결론: 재사용 풀의 존재 자체를 누수로 볼 수 없고, 회수 경로도 실제 호출된다. 그럼에도 모델 초기화 중 LMKD가 발생하므로 다음 확인 대상은 회수 시점·속도, Normal 영역의 압박과 LMKD 정책 입력의 시간 관계다. 회수 함수가 호출된다는 사실만으로 충분히 빠르고 충분한 양을 회수했다고 판정하지 않는다. 앱 Swap 3GB의 직접 소유 메모리는 여전히 별도 미확정이다.
근거: 내부 ion-idle-trace/trace.txt, ion-load-trace/{trace.txt,profile.txt,summary.json,logcat.txt,before.txt,after.txt}. 모델 초기화 반복은 중단했고 진단 프로브·서버 정리 및 앱 새 PID 22128 관측을 확인했다.
추가 재현 — LLM 초기화만으로도 LMKD 종료, ION 풀은 별도 계정
22:46:27.949 PID 16918에서 GenieDialog_create를 시작한 뒤, 22:46:31.269 LMKD가 앱을 종료했다. 이번 시험은 STT/TTS를 추가 생성하지 않은 LLM 단독 초기화 시험이다. 정상 load/free 전후 ION 풀 비교를 계획했으나 초기화 중 종료되어 완료하지 못했다. DMA 매핑 실패로 판정한 시험도 아니다.
| 종료 시 항목 | 관측 |
|---|---|
| 앱 RSS | 1,163,148kB = 1,135.89MiB |
| 앱 Swap | 2,368kB = 2.31MiB |
| 같은 killinfo의 전체 MemFree | 1,273,548kB ≈ 1.21GiB |
| 직전 두 zone pgskip delta | 0 / 20 |
| 종료 이유 | critical pressure and device is low on memory |
STT 추가 로드가 없어도 LLM 초기화 단계에서 종료될 수 있고, Swap 3GB가 없어도 발생한다. 이번에도 일부 zone을 합산에서 제외하는 조건과 종료가 함께 관측됐다. 종료 순간 최종 zone 합산값은 이번 시험에서 직접 계측하지 않았다.
ION system heap의 디버그 통계는 다음과 같다. 이 풀은 시스템 공용 재사용 페이지이며 앱의 Swap 항목과 다르다.
| 항목 | 로드 전 | 앱 종료 후 |
|---|---|---|
| 재사용 pool total | 1,775,722,496 bytes (1,693.46MiB) | 1,780,809,728 bytes (1,698.31MiB) |
| 사용 중 버퍼 바이트 | 80,568,320 | 80,568,320 |
| 사용 중 버퍼 수 | 83 | 83 |
로컬 Qualcomm ION 소스 ion_msm_system_heap.c:136-156에는 일반 해제에서 페이지를 풀로 돌려주고, SHRINKER_FREE 경로에서는 즉시 해제하는 분기가 있다. 버퍼 객체 소멸과 모든 물리 페이지의 즉시 free 반환은 같은 사건이 아니다. 앞선 해제 후 읽기에서도 cached pool 약 1,710MiB가 관측됐다. 다만 이번에는 초기화 완료 시점의 풀 상태를 얻지 못했고 페이지별 소유권도 추적하지 않았으므로, 특정 모델이 풀 전체를 만들었다거나 풀 누수가 있다고 단정하지 않는다. 전체 카운터가 같아도 버퍼별 동일성을 증명하지는 않는다.
근거: 내부 ion-lifecycle/baseline-ion.txt, postkill-ion.txt, interrupted-logcat.txt, ion-lifecycle-run.txt; 이전 zone-owner/post-ion-stats.txt. 초기화 중 프로세스가 죽어 Frida script destroyed가 발생했고 프로브 서버는 정리됐다. 강제 pool shrink나 LMKD 정책 변경은 수행하지 않았다. 다음 검증은 풀에서 재할당되는 양과 압박 중 shrinker 회수를 직접 추적하는 것이다. 현장 3GB Swap 귀속은 별도 미해결 항목이다.
추가 확인 — 남아 있는 free RAM은 대부분 Movable 영역
새 보드 PID 16918에서 LLM load/free 1회를 완료했다(Genie create/free 모두 0). 각 단계의 /proc/zoneinfo를 직접 수집했다. 아래 값은 종료 순간이 아닌 단계별 스냅샷이다.
| 단계 | Normal free | Movable free | 두 영역 free 합계 |
|---|---|---|---|
| 로드 전 | 43.91MiB | 1,341.02MiB | 1,384.92MiB |
| 로드 후 | 49.45MiB | 1,211.70MiB | 1,261.14MiB |
| 해제 후 | 131.29MiB | 1,358.55MiB | 1,489.84MiB |
전체 free가 1GiB 이상이어도 Normal 영역의 free는 수십 MiB일 수 있다. 이 관측은 앞서 확인한 LMKD의 zone 선택 계산과 함께 해석해야 한다. 두 영역의 관리 용량은 Normal 약 5,241.81MiB, Movable 2,048MiB다. Normal에는 로드 후에도 active/inactive file 합계 약 2,035.68MiB가 있으므로 Normal의 free 수치만으로 회수 가능한 메모리까지 모두 고갈됐다고 단정하지 않는다.
이 시험 중 앱은 생존했지만 acore, keychain, permissioncontroller, launcher 4개 프로세스가 LMKD로 종료됐다. 따라서 모델 로드 성공을 시스템 무영향으로 해석하지 않는다. 추가 반복 부하는 여기서 멈췄다.
로컬 Qualcomm ion_msm_system_heap.c:30-32의 기본 할당 플래그는 GFP_HIGHUSER 계열이며 __GFP_MOVABLE을 포함하지 않는다. 이는 Normal 쪽 압박을 조사할 근거지만, 이번 모델 DMA-BUF의 실제 heap/페이지 PFN/할당 플래그를 추적한 증거는 아니다. 기존 ION pool 재사용, 파일 캐시 회수와 다른 프로세스 종료가 함께 있으므로 위 free 차이를 1,708MiB 모델 버퍼의 물리 배치로 환산해서는 안 된다. IOVA 주소 공간 부족과도 별개다.
근거: 내부 zone-owner/{baseline,loaded,unloaded}-zones.txt, zone-summary.json, logcat.txt, zone-owner-run.txt. 프로브 정리 및 모델 해제 완료. 현장 Swap 3GB의 메모리 소유자는 여전히 미확정이다.
추가 재현 — LLM 성공 후 STT 로드 중 RSS 739MiB에서 앱 종료
같은 PID에서 이전 시험은 LLM+STT RSS 약 831MiB로 완료됐지만, 후속 시험에서는 STT 생성 도중 RSS 약 739MiB에서 LMKD가 앱을 종료했다. 앱 RSS가 일정 숫자를 넘으면 항상 죽는다는 해석과 맞지 않는다. 시스템 압박·zone 판단·실행 단계와 대상 우선순위를 함께 봐야 한다.
| 이번 시간 순서 | 직접 확인한 근거 |
|---|---|
| 22:32:55.680 | GenieDialog_create=0: LLM 생성 완료 |
| 이어진 스냅샷 | NPU DMA-BUF 8개, 합계 1,708.27MiB 생성 확인 |
| 22:33:00.289 | CPU SenseVoice 한국어 STT 생성 설정 로그 |
| 22:33:01.816 | LMKD의 두 zone pgskip delta = 0 / 220 |
| 22:33:01.818 | PID 13619, oom_score_adj=200인 ondevice 앱 종료 |
| 종료 로그 RSS / Swap | 756,488kB / 1,900kB = 약 738.76MiB / 1.86MiB |
| 같은 killinfo의 전체 MemFree | 1,109,204kB ≈ 1.06GiB |
| 종료 이유 | critical pressure and device is low on memory |
| 종료 후 | 이번에 생성한 DMA-BUF 8개 inode가 모두 사라짐 |
원문 핵심:
22:32:55.680  >>>>>>>>>> 0 = GenieDialog_create(config.GetHandle(), &m_handle);
22:33:01.816  calc_zone_watermarks pgskip_deltas_val: 0
22:33:01.816  calc_zone_watermarks pgskip_deltas_val: 220
22:33:01.818  Kill 'com.skmagic.ondeviceai.agent' (13619), uid 1000, oom_score_adj 200 to free 756488kB rss, 1900kB swap; reason: critical pressure and device is low on memory
이번에 좁혀진 것
- DMA 실패와 구분: LLM 생성은 성공했고, 그 후 STT 객체 생성 중 프로세스가 종료됐다. 이 사례를
Failed to map weights buffer오류로 분류하지 않는다. - RSS 고정 상한이 아님: 이전 성공과 이번 종료는 같은 PID에서 관측됐다. 831MiB에서 생존한 뒤 739MiB에서 종료될 수 있었으므로, “RSS를 800MB로 맞추면 LMKD를 막을 수 있다”는 보장은 성립하지 않는다. 측정 방식도 이전 표의 smaps와 이번 LMKD RSS가 다르므로 두 값을 정밀한 peak 차이로 해석하지 않는다.
- 큰 Swap은 종료의 필수 조건이 아님: 이번 앱 Swap은 1.86MiB 수준이었다. 현장 3GB의 원인과 LMKD의 실행 조건은 각각 확인해야 한다.
- 전체 여유와 정책 입력은 다름: 같은 종료 로그의 전체 MemFree는 1.06GiB였다. pgskip이 0이 아닌 zone을 합산에서 제외하는 실행 바이너리 분기와 부합한다. 이번에는 uprobe로 합산 free·watermark·배율을 직접 수집하지 않았으므로 이전 다른 사례의 73MiB를 이번 값으로 재사용하지 않는다.
- 프로세스 종료 뒤 DMA 객체 잔존 없음: 이번 로드에서 생긴 8개 객체가 모두 사라졌다. 전체 시스템 DMA 목록은 다른 서비스 활동으로 달라졌으므로, 전 시스템이 이전 상태로 완전히 복구됐다고 판정하지 않는다.
반복 누적 시험은 미완료
원래 계획은 같은 프로세스에서 STT 생성·1초 무음 처리·해제를 3회 반복하는 것이었다. 첫 회 STT 생성 중 종료됐기 때문에 완료한 STT 주기는 0회다. 따라서 앞서 남은 약 71MiB가 반복 누적인지 안정되는지를 이번 시험으로 판정하지 않는다. Frida의 script has been destroyed는 프로세스 종료 후 수집 도구에서 발생한 오류이며, 최초 원인은 LMKD 종료 로그로 확인했다.
별도 압박 프로그램은 사용하지 않았지만 다른 서비스의 실행·메모리는 통제하지 않았다. STT 객체는 서비스의 recognizer 필드에 넣지 않은 독립 시험 객체였고, 마이크·TTS·기기 제어는 시작하지 않았다. 종료 후 앱 PID 16918의 재기동을 확인했으나 전체 모델 초기화 성공을 확인한 것은 아니다. 추가 부하 시험은 이 종료를 확인한 시점에서 멈췄고 진단 서버도 종료했다.
로컬 근거: a1-newboard-20261016/isolated-stt-repeat3-run.txt, isolated-stt-repeat3/interrupted-logcat.txt, loaded-dmabuf.txt, postkill-dmabuf.txt, result-summary.json. 종료 후 meminfo는 종료 당시 수치와 구분해 보관했다.
추가 실측 — STT를 더하면 익명 메모리가 약 406MiB 증가
현재 보드에서 기기 제어 설정과 마이크·스피커를 건드리지 않고, 앱과 같은 한국어 STT 설정으로 독립 모델을 생성했다. LLM에 STT를 추가하자 RSS가 약 415MiB 늘었고, 대부분이 익명 메모리였다. NPU 가중치 DMA-BUF와 달리 CPU 음성 모델의 메모리는 앱 RSS·Swap 후보를 따로 확인해야 함을 보여준다.
| 동일 PID 13619의 단계 | smaps RSS | smaps Anonymous | 앱 VmSwap |
|---|---|---|---|
| 기준 | 231.66MiB | 126.55MiB | 0kB |
| LLM 로드 후 | 415.97MiB | 311.74MiB | 1,900kB |
| LLM + STT 로드 후 | 830.84MiB | 717.48MiB | 1,900kB |
| 1초 합성 무음 STT 처리 후 | 831.86MiB | 718.11MiB | 1,900kB |
| STT 해제, LLM 유지 | 425.22MiB | 311.43MiB | 1,900kB |
| LLM까지 해제 | 302.81MiB | 188.80MiB | 1,900kB |
- STT 추가 효과: 직전 LLM-only 표본 대비 RSS +414.87MiB, Anonymous +405.74MiB. 큰 Scudo secondary 영역의 RSS가 132,312kB → 505,260kB로 늘었다.
- STT 해제 효과: 처리 후 대비 RSS 약 406.64MiB 감소. 모든 모델 해제 뒤 RSS가 기준보다 약 71MiB 높아, 모든 할당이 즉시 원복됐다고 판정하지 않는다. 초기화·런타임·할당자 보유가 섞일 수 있으며 이 단일 시험으로 누수라고 단정할 수 없다.
- Swap 계측 주의: 이 표의 Swap은
/proc/PID/status의 VmSwap이다. 별도 smaps 합산 Swap은 13,956kB, SwapPss는 14kB까지 관측됐다. 이 smaps Swap 중 11,932kB는 진단 도구의/memfd:frida-agent-64.so (deleted)영역이었다. 서로 다른 집계값을 같은 숫자로 취급하거나 합산하지 않으며, 진단 도구의 메모리를 제품 STT 사용량으로 해석하지 않는다. 어느 계측에서도 3GB를 재현하지 못했다.
800MB로 유지할 수 있나?
이번 구성에서는 TTS 없이 LLM+STT만으로 약 831MiB RSS가 관측됐다. 따라서 단순히 “800MB를 상한으로 고정하면 된다”고 보장할 근거는 없다. 그렇다고 이것이 최적화할 수 없는 최소 요구량이라는 뜻도 아니다. 실제 활성 모델 구성, 로드·첫 추론·대기 단계, 회수 정책을 같게 놓고 먼저 메모리 예산을 잡아야 한다. 이전 TTS 단독 절감량 약 457MiB를 이번 수치에 기계적으로 더하거나 빼면 안 된다.
시험 조건과 제한
- 앱 실행 버전은
1.20.09/ versionCode 124. 현장 표의A1_1.8.0은 제품 버전 표기이므로 이 앱 버전과 직접 동일·상이 판정을 할 수 없다. - 실제 앱의
getModelConfig(15)를 이용했다. 설정은 한국어 SenseVoicemodel.int8.onnx, provider=cpu, numThreads=1, 16kHz/80 feature였다. 서비스의 recognizer 필드는 시험 전후 null로 유지했다. - 독립 객체로 16kHz float 무음 1초를 한 번 처리하고 stream과 recognizer를 해제했다. 실제 녹음·음성 인식 정확도 시험이나 긴 발화 시험이 아니다. TTS 생성·재생과 기기 제어도 실행하지 않았다.
- 이번 시작 PID는 13619로, 직전 LLM-only 시험의 PID 3320과 다르다. 로그에는 22:24:20 BootBroadcastReceiver 경유 앱 시작이 있다. 이 도구가 프로세스 재시작을 요청한 것은 아니며, 재시작 원인을 확정하지 않았다. 수치 비교는 이번 PID 안에서만 수행했다.
- 시험 로그에는 다른 앱들의 LMKD 종료도 있다. 별도 압박 프로그램을 사용하지 않았지만 시스템 전체 활동을 통제한 실험은 아니다. Frida와 스냅샷 수집 부하도 포함된다.
- 현재 서비스 자체는 DeviceAgent 연결 대기 상태이고 STT/TTS 객체가 없다. 따라서 본 시험은 LLM+독립 STT 구성의 메모리 증분 측정이며, 현장 전체 서비스의 장기 재현 완료가 아니다.
로컬 근거: a1-newboard-20261016/stt-runtime-inspection.json, isolated-stt-run.txt, isolated-stt/*-smaps.txt, *-memory.txt, smaps-summary.json, process-transition.txt. 모델 생성·합성 입력 처리·모델 해제를 모두 확인한 뒤 진단 서버를 종료했다.
추가 실측 — NPU 1,688MiB 버퍼는 Swap이 아닌 별도 DMA-BUF
이번 정상 로드에서는 NPU의 큰 버퍼가 앱 Swap으로 쌓이지 않았다. 앱 매핑과 실제 DMA-BUF 객체를 연결했고, 모델 해제 시 해당 객체가 사라지는 것까지 확인했다.
| 확인 항목 | 실측 결과 | 의미 |
|---|---|---|
가장 큰 앱 /dmabuf: 매핑 |
Size=1,728,512kB = 1,688MiB, inode=4043461 | 앱 주소 공간에 보이는 DMA 버퍼 |
| 같은 inode의 커널 객체 | 1,769,996,288바이트, exporter=ion_dma_buf |
단순 주소 예약이 아닌 실제 DMA-BUF 객체 |
| 연결 장치 | msm_fastrpc_compute_cb2 |
NPU/FastRPC 경로와 연결 확인 |
| 앱 fdinfo | FD 95, 동일 크기와 exporter | 앱이 해당 크기의 DMA-BUF 핸들을 보유 |
| 큰 매핑의 smaps 집계 | RSS=0, PSS=0, Anonymous=0, Swap=0; pf io 플래그 |
일반 익명 힙과 다른 페이지 매핑/집계 경로 |
| 전체 DMA-BUF 객체 합계 | 84,205,568 → 1,875,460,096 → 84,205,568바이트 | 로드 전 → 로드 후 → 해제 후 |
| 로드 중 새 객체 | 8개, 합계 1,708.27MiB | 이 추가 시험에서 직접 센 객체 합계 |
| 해제 후 확인 | 8개 inode 모두 사라짐, 전후 전체 inode·크기·exporter 목록 일치 | 이 정상 해제에서는 DMA-BUF 객체 잔존 없음 |
| 앱 VmSwap | 전·중·후 모두 3,868kB | 큰 DMA 버퍼 크기와 앱 Swap은 별개 |
RSS=0인데 왜 시스템 메모리는 줄어드나?
이 버퍼의 사용자 매핑은 VM_PFNMAP/VM_IO 방식이다. 로컬 플랫폼 소스의 ION 경로는 ion_heap_map_user() → remap_pfn_range()로 페이지를 매핑한다. smaps_pte_entry()는 일반 페이지로 처리할 수 있는 경우에 RSS를 합산하며, vm_normal_page()는 해당 PFN 매핑을 일반 페이지로 반환하지 않는 분기를 가진다. 실제 기기의 pf io, RSS=0 관측이 이 집계 방식과 부합한다. 로컬 커널 전체가 실행 커널과 바이너리 단위로 동일하다고 검증한 것은 아니므로, 소스 설명과 기기에서 직접 확인한 사실은 구분한다.
따라서 NPU 버퍼의 RSS=0은 물리 메모리 사용량이 0이라는 뜻이 아니다. 이 시험의 MemAvailable은 로드 전 5,262,648kB → 로드 후 3,319,392kB → 해제 후 5,269,396kB였다. 시스템 다른 동작과 파일 캐시도 섞인 값이므로 이 차이를 전부 DMA-BUF 하나의 사용량으로 환산하지 않는다. 객체가 사라졌다는 사실 역시 모든 backing page가 같은 순간 buddy allocator로 반환됐다는 증명은 아니다. ION 풀·지연 해제는 별도로 볼 수 있다.
Swap 3GB 조사에 주는 결론
- 직접 소유: 이번에 확인한 NPU 가중치 DMA 매핑 자체를 앱 Swap 3GB의 직접 소유자로 볼 근거가 없다. 그 매핑은 Swap=0이었다.
- 간접 압박: NPU가 공유 RAM 약 1.7GiB를 필요로 하면서 다른 일반 메모리의 reclaim·swap을 유발할 가능성은 별개로 남는다.
- 정상 해제: 이번 모델 해제는 DMA 객체를 남기지 않았다. 과거 두 번의 매핑 실패 경로나 현장 장기 세션의 잔존 여부까지 정상이라고 판정한 것은 아니다.
- 다음 판별 대상: 현장과 같은 서비스 구성에서 Swap이 큰 VMA의 이름·Anonymous·SwapPss를 확보해야 한다. LLM 호스트 버퍼, STT/TTS 힙, 공유/zygote 페이지를 나눠야 하며, NPU를 사용한다는 사실만으로 CPU 측 할당을 제외할 수 없다.
시험 범위: 10월 16일 22시대, 동일 PID 3320, 모델 생성·해제 각 1회 성공. 추론/STT/TTS 실행 없는 별도 추가 시험이다. 앞의 연속 smaps 시험과 횟수를 섞지 않는다. Frida 수집 부하가 포함됐으며 시험 후 모델·진단 서버를 해제했다.
로컬 원본: a1-newboard-20261016/dmabuf-owner/{baseline,loaded,unloaded}-{dmabuf,smaps,fdinfo,memory}.txt, objects-summary.json, dmabuf-owner-run.txt. 소스 근거: drivers/staging/android/ion/ion_heap.c:171, mm/memory.c:611, fs/proc/task_mmu.c:588.
추가 실측 — 초기화 RSS 피크의 대부분은 모델 파일 매핑
LLM 초기화 도중 포착한 RSS 1.54GiB 중 약 1.18GiB는 깨끗한 모델 파일 페이지였다. 이번 큰 RSS 피크를 Swap 3GB의 직접 원인으로 볼 근거는 없다.
| 단계·항목 | smaps 실측 | 해석 |
|---|---|---|
| 로드 전 프로세스 RSS | 232.16MiB | 동일 PID의 초기 상태 |
| 초기화 중 관측 최대 RSS | 1,575.09MiB | 연속 표본 중 최대이며 실제 순간 최대의 상한이 아님 |
| 위 표본의 모델 파일 RSS | 1,207.24MiB | /system/etc/model/kvcache_1_of_1.serialized.bin |
| 위 모델 파일의 속성 | r--p, Private_Clean=1,236,216kB, Anonymous=0, Swap=0 |
읽기 전용 파일 기반 페이지 |
| 전체 표본의 Anonymous 최대 | 293.19MiB | 이 시험에서는 수 GiB 익명 메모리 보유가 관측되지 않음 |
| 초기화 완료 후 약 10초간 RSS | 359.29MiB | 큰 모델 파일 매핑은 smaps에서 사라짐 |
| 모델 해제 후 RSS | 223.12MiB | 로드 전보다 낮음 |
| 전체 표본의 smaps Swap | 3,892kB로 동일 | 대규모 Swap 전환 없음; VmSwap과는 다른 계측값 |
파일 이름에 kvcache가 들어가지만, 이름만으로 런타임 KV cache라고 판단하지 않는다. 여기서 직접 확인한 것은 serialized 모델 파일의 읽기 전용 매핑이다. 깨끗한 파일 페이지는 파일에서 다시 읽을 수 있으므로 일반 익명 메모리처럼 Swap에 보존해야 하는 대상과 구분해야 한다. 이번에는 그 VMA 자체가 초기화 완료 후 사라졌다. 이 관측만으로 시스템 파일 캐시까지 즉시 모두 반환됐다고 단정할 수는 없다.
기존 가설을 좁힌 결과: 현재 보드·모델 구성의 정상 초기화 1회에서, 큰 RSS 증가분이 초기화 후 계속 남아 Swap 3GB로 누적되는 모습은 보이지 않았다. 따라서 다음 조사는 LLM 파일 매핑 자체보다 익명 메모리를 만드는 별도 버퍼·다른 모델/런타임·장기 병행 동작·실패 경로의 잔존 할당을 구분하는 데 초점을 둬야 한다. NPU용 DMA-BUF는 일반 smaps RSS만으로 전체 점유를 계산할 수 없으므로 이 결과로 NPU의 물리 메모리 압박까지 부정하지 않는다.
이번 관측의 범위
- 10월 16일 22:10, 동일 PID 3320에서 모델 생성·해제 각 1회 성공. 정상 추론 및 STT/TTS는 실행하지 않았다.
- 약 20초 동안 smaps 33개 수집, 표본 시작 간격 중앙값 약 0.51초. 목표 0.2초보다 느렸으며, 그 사이 더 짧은 피크는 놓칠 수 있다. smaps 스캔과 이후 status/meminfo 수집은 원자적 동시 스냅샷이 아니다.
- 초기화 중
com.android.keychain은 direct reclaim 사유로 종료됐다. ondevice 앱은 생존했다. 따라서 이 시험도 시스템 전체 무압박 상태라고 부르지 않는다. - Frida 및 smaps 수집 부하가 포함돼 있다. 현장 앱 구성·장기 압박 조건과 동일한 시험은 아니며, 현장 Swap 3GB 가능성을 배제하는 결과가 아니다.
- 기존 로드 횟수 집계와 별도의 추가 1회다. 시험 후 모델 해제 성공과 진단 서버 종료를 확인했다.
로컬 근거: a1-newboard-20261016/init-samples/{0001..0033}-smaps.txt, samples.jsonl, timeline.json, smaps-summary.json, logcat.txt, init-samples-run.txt.
추가 실측 — 전체 여유 1.22GiB인데 LMKD 판단 여유는 73MiB
10월 16일 22:00 새 보드에서, 전체 MemFree와 LMKD가 실제 합산한 여유량의 차이를 직접 포착했다. 이번 종료 대상은 ondevice 앱이 아닌 com.sk.productsystemui였다. 따라서 이전 ondevice 종료 순간의 수치를 확보했다고 해석하면 안 된다.
| 같은 판단 구간의 지표 | 실측값 | 의미 |
|---|---|---|
| killinfo의 전체 MemFree | 1,274,312kB ≈ 1.22GiB | 시스템 전체의 free 값 |
| LMKD zone 합산 free | 19,324페이지 | 실제 실행 파일의 함수 종료 지점에서 수집 |
| 위 합산에서 차감하는 CMA free | 625페이지 | LMKD가 일반 여유량에서 제외 |
| LMKD 비교용 free − CMA | 18,699페이지 ≈ 73.04MiB | 전체 MemFree와 다른 판단 입력 |
| 배율 적용 전 high watermark | 25,693페이지 ≈ 100.36MiB | 73.04MiB는 이 값보다도 작음 |
| 두 zone의 pgskip delta | 0 / 51,920 | 두 번째 zone은 합산 대상에서 제외되는 분기 |
| 실제 종료 이유 | direct reclaim and low on memory | medium pressure 이벤트에서 product system UI 종료 |
약 29ms 뒤 다음 계산에서는 pgskip이 0 / 0으로 바뀌었고, 합산 free − CMA는 323,602페이지 ≈ 1,264.07MiB로 커졌다. 이때 로그는 Not killing이었다. 이는 29ms 동안 물리 RAM이 그만큼 새로 생겼다는 뜻이 아니라 합산 대상 영역이 달라졌음을 뒷받침한다. 실제 종료로 반환된 메모리 변화도 함께 포함될 수 있다.
현재 좁혀진 해석: 전체 RAM 잔량만으로 LMKD 종료를 설명할 수 없다. 해당 펌웨어는 reclaim 시 건너뛴 zone을 판단 합계에서 제외한다. 모델 로드 중 특정 zone의 압박과 이 판단 방식이 결합하면 전체 여유가 있어도 다른 프로세스를 종료할 수 있다. 이 동작을 정책 버그로 확정하거나, 현장 10대의 원인으로 단정한 것은 아니다. 이번 함수 종료 시점의 watermark 배율과 캐시 가산값은 별도 계측하지 않았으므로 최종 비교식을 완전히 복원했다고 주장하지 않는다.
이번 추가 3회 결과와 한계
- 동일 PID 3320에서 모델 로드 3회 모두
GenieDialog_create=0, 해제 3회 모두GenieDialog_free=0. DMA 매핑 오류 및 ondevice 앱 종료는 이번 3회에서 없었다. - 로드 후 VmRSS: 388,876 / 378,292 / 378,436kB. 각 해제 후: 234,960 / 235,364 / 236,260kB. 순간 최대값이 아니라 단계 완료 후 스냅샷이다.
- 앱 VmSwap: 기준 3,880kB → 각 로드·해제 후 3,868kB. 이번 반복만으로 Swap 3GB 누적은 재현되지 않았다.
- 첫 로드 중 product system UI 1회 종료를 관측했다. ondevice 앱은 생존했고 최종 모델 해제까지 완료했다.
- 현재 구성의 LLM 단독 로드 시험이며 STT/TTS를 포함한 서비스 전체 장기 시험이 아니다. Frida와 추적 도구의 관측 부하가 있으며 별도 메모리 압박 프로그램은 실행하지 않았다.
- 기존 19회 집계와 별도로 수행한 추가 3회다. 이번 성공을 과거 DMA 실패가 해결됐다는 근거로 사용하지 않는다.
계측은 SHA-256 및 text 일치가 확인된 LMKD의 calc_zone_watermarks 종료 지점에 uprobe를 설치해 출력 구조체를 읽었다. 정책 설정은 변경하지 않았다. 수집 이벤트 9 / 기록 이벤트 9로 덮어쓰기 없이 저장했고, 시험 후 uprobe·kprobe 및 Frida 서버를 해제했다.
로컬 근거: a1-newboard-20261016/lmk-zone-load-trace.txt, lmk-zone-load/1/logcat.txt, lmk-zone-load/{1,2,3}/trace.txt, lmk-zone-load-run.txt. 원본 로그에는 제품 운영 정보가 있어 공개 페이지에는 필요한 수치와 발췌 해석만 싣는다.
초기 조사 기록 — 새 보드에서 DMA 실패 2회 재현
“RAM이 남아 있는데 모델 초기화가 실패한다”는 현상은 이번 시험에서 NPU용 IOVA 주소 할당 실패까지 추적했다. 현장 Swap 3GB의 원인을 찾았다는 뜻은 아니다. 아래 세 문제는 분리해서 판단해야 한다.
| 문제 | 이번에 확인한 사실 | 아직 확인하지 못한 것 |
|---|---|---|
| TTS 합성 후 메모리 보유 | ON 단독 시험에서 약 457MiB 감소, 긴 생성 평균 약 0.26초 증가 | 앱 전체 장기 효과·현장 LMKD 예방 효과 |
| LLM 초기화의 DMA 오류 | 1,688MiB IOVA 할당 실패 → DMA map 실패 → QNN 초기화 실패, 새 보드 2회 재현 | 주소 단편화·잔존 매핑·정렬/범위 제한·할당 관리 객체 중 구체 원인 |
| 현장 RSS 편차·Swap 약 3GB·LMKD | 새 보드에서도 매핑 성공 후 LMKD 별도 관측. DMA 실패 당시 앱 Swap은 약 3.7MiB | 현장 3GB의 소유 버퍼와 수명, 현장 kill 순간의 정확한 정책 조건 |
시험 순서와 결과
앱 1.20.09 / A1_BUILD3_820이 설치된 새 보드에서 기존 QaClient.Init/UnInit을 진단 도구로 호출했다. 시작 시 앱은 STATE_INIT_NOW, initialized=false였고, 정상 서비스 초기화가 완료되지 않았다. LLM만 분리한 로드·해제 시험이며 STT/TTS·추론을 포함한 제품 전체 조건과 동일하지 않다. APK·모델·라이브러리·시스템 메모리 정책은 교체하지 않았다.
| 순서 | 프로세스 | 결과 | 근거 |
|---|---|---|---|
| 1 | 첫 PID | 로드 성공 → 해제 성공 | Genie create/free 각각 0; 해제 전후 MemAvailable 약 2.77 → 4.66GiB |
| 2 | 첫 PID | 큰 DMA 매핑 성공 후 LMKD | IOVA 0x8be00000, map 반환 1; RSS 1,800,004kB, Swap 3,288kB로 kill |
| 3·4 | 자동 복구된 동일 PID | 로드·해제 각각 성공 | create/free 각각 0 |
| 5 | 복구 PID 유지 | DMA 오류 재현 | 1,688MiB IOVA 반환 0, kernel ret -12, QNN weights map 오류 |
| 6 | 복구 PID 유지 | 추가 추적에서도 같은 실패 | alloc_iova 2회 시도 모두 NULL → 상위 IOVA 반환 0 |
1차 6회 중 성공 3회, DMA 오류 2회, 매핑 성공 후 LMKD 1회다. 각 반복은 독립적인 기기 표본이 아니므로 이 비율을 제품 실패율로 사용하지 않는다. 마지막 실패 후 진단 추적을 제거했다. 1차 시험 종료 시에는 앱이 살아 있으나 LLM 초기화가 실패한 상태였다. 이후 후속 시험 결과는 아래와 같다.
후속 확인 — 같은 PID에서 재시작 없이 13회 성공
첫 DMA 실패 2건 이후, 같은 PID를 유지한 채 추가 로드·해제 13회(3회 + 10회)를 수행했고 모두 성공했다. 최초 실패 묶음 6회와 합치면 이 초기화 반복 묶음의 로드 시도는 총 19회이며, 성공 16회·DMA 실패 2회·매핑 성공 후 LMKD 1회다. 초기 6회와 후속 13회의 관측 조건과 시간은 다르다.
| 확인 항목 | 후속 13회 결과 | 해석 범위 |
|---|---|---|
| 모델 생성·해제 | create/free 모두 0 | 프로세스 재시작 없이도 다시 성공할 수 있음 |
| 앱 Swap | 로드 후·해제 후 3,836kB(약 3.75MiB) 유지 | 이 초기화 단독 조건에서 3GB 누적은 미재현 |
| 해제 후 FastRPC | 13회 모두 해당 앱 PID의 debug 항목 없음 | 정상 해제 후 앱 map이 계속 쌓인다는 증거 없음. 전체 IOVA tree/다른 소유자의 매핑까지 검증한 것은 아님 |
| 마지막 해제 후 | RSS 247,536kB, MemAvailable 5,304,516kB | LLM을 해제한 상태의 스냅샷. 음성 서비스 전체 초기화 완료값이 아님 |
수정해야 할 해석: “한번 DMA 오류가 나면 프로세스를 반드시 재시작해야 한다”, “매번 모델 재로드할 때마다 큰 매핑/Swap이 누적된다”는 결론은 현재 증거로 성립하지 않는다. 반대로 후속 성공이 앞선 실패를 무효로 만들지는 않는다. 실패 시점에 큰 IOVA 할당이 거절됐다는 사실은 확인됐다.
실패와 후속 성공 사이에는 시간이 지났고, 보드의 다른 작업을 통제하지 않았다. 따라서 기다리기만 하면 해결된다는 보장이나 특정 backoff 시간의 효과로 해석하지 않는다. Frida 호출 및 커널 probe는 정상 제품 스레드/타이밍과 다르고 계측 비용도 있다.
이번에는 alloc_iova에서 호출한 kmem_cache_alloc의 성공 반환도 성공 사례에서 관측했다. 그러나 이 하위 추적을 켠 13회에는 실패가 없었으므로, 앞선 실패의 관리 객체 할당 실패 가능성을 배제하지 못했다. 일부 trace는 ring buffer overwrite가 있어 전체 이벤트 부재를 근거로 결론 내리지 않았다. 성공 여부는 create/free 반환값, QNN·커널 로그, 해제 후 스냅샷으로 교차 확인했다.
후속 시험 종료 시 모델은 정상 해제했고, 진단 probe·PID 필터·Frida 서버·포트 전달을 정리했다. 정상 앱 전체 초기화나 실제 추론 품질은 이번 시험의 검증 범위가 아니다. 근거: slab.log, slab-repeat.log, repeat-unloaded-summary.json 및 각 회차의 *-unloaded-fastrpc.txt.
정상 입력의 LLM 추론 5회 — RSS 감소와 Swap 유지
초기화 반복 다음으로, 로컬 앱 소스 ForegroundService.kt:2246 부근의 함수 선택용 프롬프트 형식으로 QaClient.Infer()를 직접 호출했다. 입력은 짧은 상태 조회 문장이며, 반환 문자열을 TTS나 기기 제어에 전달하지 않았다. GenieDialog_query 5회 모두 반환값 0, 각 결과는 17자였다. 정상 제품의 전체 음성 경로 시험이나 17자 결과의 의미 정확성 검증은 아니다.
아래 RSS/PSS/SwapPss는 각 시점의 /proc/PID/smaps_rollup 값이며 단위는 kB다. 표의 RSS는 /proc/PID/status의 VmRSS나 현장 LMKD 출력과 혼용하지 않았다.
| 시점 | RSS | PSS | SwapPss | 관측 |
|---|---|---|---|---|
| 로드 전 | 232,532 | 133,550 | 116 | 시작 상태 |
| 모델 로드 후 | 360,780 | 261,833 | 116 | create 성공 |
| 첫 정상 추론 후 | 267,644 | 168,701 | 116 | RSS 93,136kB ≈ 90.95MiB 감소 |
| 다섯 번째 추론 후 | 267,644 | 168,700 | 116 | 짧은 추론 반복에서 누적 증가 미관측 |
| 10초 대기 후 | 267,644 | 168,700 | 116 | 이 짧은 대기 구간에서는 유지 |
| 모델 해제 후 | 234,816 | 135,873 | 116 | free 성공; 시작 RSS보다 2,284kB 높음 |
전 구간 /proc/PID/status의 VmSwap은 3,836kB, rollup의 Swap은 3,892kB, SwapPss는 116kB였다. 이 지표들은 집계 범위와 공유 페이지 계산 방식이 달라 같은 값이 아니다. 특히 개별 VMA의 정수 kB SwapPss를 단순 합산하면 반올림/절삭 누적으로 rollup 값보다 작아질 수 있으므로, 프로세스 전체 비교에는 rollup 값을 사용했다. 이 차이로 현장 3GB를 설명했다는 뜻은 아니다.
RSS 감소를 VMA 이름별로 비교하면 다음과 같다.
| 영역 | 로드 후 RSS | 첫 추론 후 RSS | 해당 영역 Swap | 의미 |
|---|---|---|---|---|
[anon:scudo:secondary] |
120,020kB | 26,872kB | 양쪽 0 | 큰 감소가 관측된 native 할당자 영역 |
[anon:scudo:primary] |
78,152kB | 78,156kB | 양쪽 0 | 이 시점에는 거의 동일 |
secondary 영역의 가상 크기 합계는 양쪽 174,460kB로 동일했다. 따라서 가상 주소 범위 유지, 실제 상주 페이지 감소, Swap 이동은 서로 다른 현상이다. 페이지 반환의 정확한 API와 각 할당의 호출자는 이번에 추적하지 않았으므로, 이 감소를 특정 QNN 버퍼의 명시적 free라고 단정하지 않는다. 다섯 번째 추론 후에도 FastRPC의 1,688MiB 큰 버퍼는 존재했다. 모델 전체 해제 때문에 RSS가 줄어든 것은 아니다.
해석: 이 보드의 짧은 LLM 단독 추론·reset 반복은 3GB Swap 누적을 재현하지 않았다. STT/TTS 동시 실행, 더 긴 입력·출력, 장기 대기, 다른 서비스의 지속 압박을 포함한 현장 조건을 배제하지 못한다. 시작/종료 스냅샷은 추론 중 메모리 피크를 나타내지 않는다.
제외한 시험과 입력 형식 주의
먼저 사용한 일반 Llama 대화 형식은 이 함수 선택 모델의 앱 입력 형식과 달랐다. 이 조건에서는 문자열 502자가 반환됐지만 네이티브 query는 5회 모두 -6이었다. 후속 호출 로그에 Requested 121 KV$ doesn't fit capacity 120이 나타났다. 보드 설정은 context.size=128, max-num-tokens=127이다. 이 실패를 정상 제품 추론 실패나 물리 RAM 부족 증거로 분류하지 않았다. 앱 소스와 같은 형식으로 변경한 위 5회에서는 모두 성공했다. 실제 설치 APK와 로컬 소스의 전체 바이너리 일치까지 검증한 것은 아니다.
또한 현재 로컬 JNI 구현은 query 오류가 발생해도 문자열을 반환하는 경로가 있으므로, 문자열 존재만으로 추론 성공 또는 정상 초기화를 판정하면 안 된다. 제품 진단에는 native create/query/reset/free 상태를 함께 기록하는 방안을 검토해야 한다. 이 관측만으로 현장 10대가 잘못 복구됐다고 판단할 수는 없다.
근거: 내부 시험 묶음의 infer-product/events.jsonl, query-1.txt, query-5.txt, 각 *-smaps.txt와 query-5-fastrpc.txt. 입력 형식이 달랐던 자료는 infer/로 분리 보관했다. 추론 시험 후 모델을 해제했고 진단 서버·포트 전달도 종료했다.
후속 시험 — LLM 단독 100회 반복에서도 Swap 증가 없음
같은 앱 프로세스에서 모델을 한 번 로드한 뒤, 앞의 함수 선택용 짧은 입력을 100회 반복했다. 네이티브 GenieDialog_query 반환값은 100회 모두 0, create/free도 0이었다. 첫 query 완료부터 마지막 완료까지 약 165초이며, 호출 사이에 메모리 수집 시간이 포함된다. STT/TTS 실행과 기기 제어는 이 시험에서 호출하지 않았다. 서비스의 전체 초기화 완료 여부를 증명하는 시험은 아니다.
| 시점 | rollup RSS (kB) | rollup PSS (kB) | VmSwap (kB) |
|---|---|---|---|
| 로드 전 | 234,728 | 135,855 | 3,836 |
| 로드 후 | 355,340 | 261,696 | 3,836 |
| 추론 1회 후 | 262,196 | 168,552 | 3,836 |
| 추론 50회 후 | 262,208 | 167,959 | 3,836 |
| 추론 100회 후 | 262,004 | 167,753 | 3,836 |
| 10초 대기 후 | 262,004 | 167,753 | 3,836 |
| 모델 해제 후 | 229,572 | 135,321 | 3,836 |
100개 추론 후 스냅샷에서 rollup RSS는 262,000~262,220kB, 변동 폭은 220kB였다. /proc/PID/status의 VmRSS는 259,908~260,148kB로 별도 집계다. rollup Swap은 3,892kB로 일정했고 SwapPss는 116~120kB였다. 공유 페이지 비례 집계의 작은 변동을 새 Swap 누적으로 해석하지 않는다. 모델 해제 후 RSS/PSS가 시작값보다 조금 낮아졌지만, 이는 모든 할당의 누수가 없다는 증명이 아니다.
이 시험으로 좁혀진 것: 이 입력·설정·짧은 실행 시간에서는 반복 횟수에 비례한 큰 메모리 누적이 관측되지 않았다. 따라서 단순히 LLM을 반복 호출했다는 사실만으로 현장 3GB Swap을 설명할 근거는 약하다. 반대로 다양한 입력, 긴 출력, 실패 후 복구 경로, 장기 대기, STT/TTS 동시 사용은 여전히 별도 검증 대상이다.
추론 후 시스템 MemAvailable은 약 3.25~3.32GiB였다. PSI 누적 stall은 소량 증가했으나 지속 압박을 주입한 시험은 아니며, 현장의 압박 지속 조건을 재현하지 않았다. 각 추론이 끝난 뒤 수집했으므로 실행 중 순간 피크 역시 이 표에 포함되지 않는다. 다음 우선순위는 반복 횟수를 더 늘리는 것보다 전체 서비스가 로드된 상태의 메모리 구성 확인과 압박 시 실제 Swap 증가 영역 추적이다.
근거: 내부 infer-repeat100/events.jsonl의 native 반환값, 시점별 /proc/PID/status·smaps_rollup·PSI, infer-repeat100/summary.json. 시험 후 정상 모델 해제, 진단 서버 종료 및 포트 전달 제거를 완료했다.
시험 환경 차이 확인 — 전체 음성 서비스는 초기화되지 않은 상태
100회 시험 이후 같은 앱 프로세스를 읽기 전용으로 확인했다. status=STATE_INIT_NOW, isInitialized=false이며 recognizer, ttsData, speechRecognitionService는 모두 null이었다. 앞선 LLM 단독 시험은 진단 경로로 QaClient.Init/Infer/UnInit를 호출한 것이며, 전체 제품 초기화 성공을 의미하지 않는다.
새 보드의 PackageManager에서 기존 com.sk.airbot.deviceagent는 사용자 0에 installed=false, stopped=true다. 시스템 APK 파일과 패키지 기록은 남아 있지만 일반 설치 목록에는 없고 pm list packages -u에서 확인된다. 이는 단순 enabled=false 상태와 다르다. 한편 새 FrameworkService의 Binder 서비스는 실행 중이다.
관측한 앱 시작 로그는 DeviceAgent 연결 시도까지 진행돼 있다. 로컬 앱 소스의 초기화 흐름은 DeviceControlProxy 연결 → onConnected → initializeApp → LLM → STT → TTS다. 로컬 AAR의 bytecode도 bindService 대상 패키지를 기존 DeviceAgent로 지정한다. 설치 APK와 로컬 소스의 전체 일치까지 입증한 것은 아니지만, 실제 객체가 null인 런타임 관측으로 현재 전체 음성 모델이 로드되지 않은 점은 확인했다.
해석에 미치는 영향: 앞선 약 256MiB RSS와 작은 Swap은 LLM 단독 조건의 결과다. 이를 현장의 전체 서비스 RSS 800~1,400MB와 직접 비교하거나, 현장 3GB Swap 가능성을 배제하는 근거로 사용하지 않는다. 전체 서비스 비교 시험은 보드의 기존 DeviceAgent와 새 FrameworkService 중 사용할 구성을 먼저 맞춰야 한다. 새 프레임워크 구성에 영향을 줄 수 있어 기존 패키지를 임의 복구하지 않았다.
근거: 내부 service-runtime.json, deviceagent-package.txt, service-current-log.txt, proxy-singleton-javap.txt. 이 확인은 모델을 로드하거나 기기 제어를 실행하지 않았으며, 진단 서버와 포트 전달은 종료했다.
결정적인 로그 — 어디서 실패했는가
2026-10-16 20:56:08의 첫 실패에서 같은 스레드의 커널 호출과 QNN 로그를 연결했다.
iommu_dma_alloc_iova(size=1769996288) → 0
__msm_dma_map_sg → 0
dma_buf_map_attachment ... msm_fastrpc_compute_cb2 ret -12
QNN: Failed to map weights buffer to device!
QNN: Could not allocate persistent weights buffer!
GenieDialog_create → -1
추가 실패(20:57:09)에서는 더 안쪽의 호출도 관측했다.
alloc_iova(size=432128 pages, limit=0xf7fff, aligned=1) → NULL
재시도 alloc_iova(같은 크기·주소 상한) → NULL
iommu_dma_alloc_iova → 0
432,128 × 4,096 bytes = 1,688MiB다. 같은 스레드의 뒤이은 4KiB IOVA 요청은 0xf7f3e000으로 성공했다. 큰 요청을 수용할 주소 범위 확보 문제를 우선 의심할 근거이며, 단편화 자체를 직접 측정한 것은 아니다.
로컬 커널 drivers/iommu/dma-iommu.c의 iommu_dma_map_sg는 IOVA 할당이 0이면 실제 iommu_map_sg 호출 전에 실패한다. 따라서 이번 오류를 “IOMMU 페이지 테이블을 연결하다 실패했다”로 표현하면 단계가 맞지 않는다. 현재 확보한 직접 증거는 IOVA 할당 단계 실패다. 실행 커널과 로컬 소스의 바이너리 일치까지 검증한 것은 아니지만, 함수 진입·반환값은 실제 보드에서 측정했다.
DMA 추가 단서 — 성공 10회 중 4회도 내부 할당 재시도가 필요했다
기존 slab-repeat 10회 성공 시험의 큰 버퍼 요청을 같은 스레드별로 다시 추출했다. 1·2·3·9회차에서는 첫 alloc_iova가 NULL, 두 번째 호출은 성공했다. 이 네 번 모두 첫 호출 내부 kmem_cache_alloc은 non-NULL이었다. 나머지 여섯 회는 관측된 첫 할당이 성공했다. 이는 새로 10회를 추가 실행한 것이 아니라 기존 원본을 더 세밀하게 분석한 결과다.
1,688MiB IOVA 요청
  관리 객체 kmem_cache_alloc → non-NULL
  첫 alloc_iova → NULL
  내부 재시도: 관리 객체 → non-NULL
  두 번째 alloc_iova → 성공
  iommu_dma_alloc_iova → 유효 주소
  DMA 매핑 → 성공
좁혀진 부분: 이 네 번의 첫 내부 실패는 관리 객체 할당 실패가 아니다. 로컬 커널 alloc_iova 구현상 이후 주소 범위 할당 단계의 실패와 부합한다. alloc_iova_fast는 첫 실패 후 CPU/global IOVA 캐시를 반환하고 한 번 재시도한다. 실제 trace의 서로 다른 반환 지점(+0x170, +0x26c)도 이 두 호출 경로와 부합한다. 다만 캐시 반환 함수 자체와 IOVA 트리 전후를 추적하지 않았으므로, 특정 캐시 항목 제거가 성공을 일으켰다고까지 확정하지 않는다. 동시 해제나 실패 크기 캐시(max32_alloc_size) 상태도 구분해야 한다.
범위 제한: 최종 QNN 초기화가 실패한 앞선 2회에는 관리 객체 반환 증거가 없었다. 이번 네 번의 복구 사례를 그 두 번에 소급해 원인을 확정하지 않는다. 앱에서 재시작한 것이 아니라 커널 한 번의 매핑 요청 내부에서 복구된 사례다. 즉 alloc_iova → NULL 한 줄만으로 제품 초기화 실패를 판정하면 안 되며, 최종 매핑·create 결과까지 연결해야 한다.
정렬과 DT 범위 설명의 보정
새 보드의 /proc/config.gz는 CONFIG_IOMMU_LIMIT_IOVA_ALIGNMENT=y, CONFIG_IOMMU_IOVA_ALIGNMENT=9, CONFIG_DMA_CONFIGURE_ALIGNMENT=y이며 페이지 크기는 4,096 bytes다. 로컬 코드와 이 설정을 함께 보면 일반 정렬 상한은 4KiB × 2^9 = 2MiB다. 도메인의 force_no_align 설정은 별도이며 이번에는 읽지 않았다. 따라서 trace의 aligned=1을 1,688MiB 또는 2GiB 경계 정렬 강제로 해석하면 안 된다.
또한 1·2회차 큰 요청의 성공 반환 주소는 0x22600000으로, 기존 DT cb2의 시작값 0x80000000보다 낮다. 다른 성공에서는 0x8c000000, 0x8be00000 등도 관측됐다. 당시 trace에는 IOVA 도메인 식별자를 기록하지 않았으므로 도메인 차이와 실제 초기화 범위를 아직 구분할 수 없다. DT의 1,920MiB 설정을 곧바로 모든 관측 요청의 실제 allocator 유효 범위로 취급해서는 안 된다. 실제 iovad.start_pfn, 도메인 식별자, 예약 구간을 확보하기 전에는 “1,920MiB 중 1,688MiB를 써서 남은 232MiB 때문에 실패”라는 설명을 원인으로 제시하지 않는다.
다음 DMA 추적은 전체 부하를 늘리는 것보다 도메인·start_pfn·max32_alloc_size·관리 객체 반환값·캐시 반환 전후를 같은 요청에 묶는 것이 우선이다. DT 크기 변경은 아직 해결책으로 확정하지 않았다.
근거: slab-repeat/{1,2,3,9}/trace.txt, 재추출 iova-retry-extract.json, 새 보드 iova-alignment-config.txt; 로컬 drivers/iommu/iova.c의 alloc_iova, alloc_iova_fast, limit_align_shift. 런타임 함수 결과와 로컬 소스 해석의 근거 수준을 구분했다.
도메인 추가 추적 — 실제 범위 확인, 매핑 성공 후 LMKD 재현
추적 항목을 도메인 포인터·시작 PFN·관리 상태로 좁혀 모델 로드를 한 번 시도했다. 큰 요청의 alloc_iova 진입에서 다음 값이 관측됐다. 필드 위치는 로컬 vmlinux 역어셈블리와 구조체 정의를 대조해 정했으며, 실행 커널 전체의 바이너리 일치를 검증한 것은 아니다.
| 항목 | 이번 관측 | 해석 |
|---|---|---|
| granule | 4,096 bytes | 페이지 단위 |
| start_pfn | 0x80000 |
시작 주소 0x80000000 |
| 요청 limit_pfn | 0xf7fff |
요청 상한 주소 0xf7ffffff |
| 요청 size | 432,128 pages | 1,688MiB |
| best_fit / force_no_align | 0 / 0 | 읽어낸 필드값; 로컬 정의에 따르면 기본 탐색·정렬 적용 |
| max32_alloc_size | 1,048,576 pages | 당시 실패 크기 캐시값; 사용량 또는 가용량이 아님 |
| IOVA 반환 | 0x8b400000 |
큰 요청의 주소 할당 성공 |
| DMA 매핑 반환 | 1 | 매핑 성공 |
이번 요청에 한해서는 DT의 1,920MiB 범위와 실제 시작·상한이 일치했다. 앞선 0x22600000 성공 요청에는 도메인 필드가 없었으므로 그 주소와의 차이는 아직 해소되지 않았다. 이번 확인으로 과거 모든 요청의 도메인이 같았다고 소급하지 않는다. 이번 trace는 entries-in-buffer/entries-written가 65/65로, 기록된 이벤트의 버퍼 덮어쓰기는 없었다.
하지만 매핑 성공 뒤 21:40:41.016에 LMKD가 앱을 종료했다.
RSS 2,093,536kB, Swap 3,836kB, oom_score_adj 200
reason: critical pressure and device is low on memory
RSS는 약 1.997GiB다. 이는 샘플링으로 추정한 피크가 아니라 LMKD 종료 로그의 값이다. 같은 killinfo의 MemFree 필드는 1,255,476kB였지만, 이를 앱이 사용 가능한 RAM이나 특정 zone의 watermark 여유로 해석하면 안 된다. 이번 시험은 DMA 매핑 실패가 아니며, Swap 3GB 없이도 초기화 중 LMKD가 발생할 수 있음을 추가 확인했다. 전체 서비스는 여전히 STT/TTS 미초기화 상태였으므로 CPU 음성 모델만으로 이 종료를 설명할 수 없다.
앱 프로세스가 종료돼 native create의 정상 반환은 확보하지 못했다. 계획했던 후속 반복은 실행하지 않았다. 모델 로드 외 별도 메모리 압박 프로그램은 실행하지 않았지만, 보드의 다른 서비스 부하를 통제한 시험은 아니다. 추적 설정과 진단 서버·포트 전달은 제거했다.
근거: 내부 domain/1/trace.txt, domain/1/logcat.txt, domain.log, alloc-iova-local-disasm.txt. 다음에는 LMKD 판단 시점의 zone별 free/min/low, reclaim·PSI와 로딩 중 호스트 RSS 증가를 같은 시간축으로 확인해야 한다.
LMKD 판단 추가 분석 — 전체 여유 RAM과 계산에 포함된 여유 RAM은 다르다
21:40:41 종료 직전 로그와 로컬 LMKD 코드를 대조하면, zone 제외 조건이 이번 종료를 설명할 유력한 경로다. 로컬 calc_zone_watermarks()는 각 zone의 pgskip 증가량이 0일 때만 해당 zone의 free/CMA와 watermark를 합산한다. get_lowest_watermark()는 이 선택된 free에서 CMA를 제외하고, 조건부 파일 캐시 기여·watermark 배수를 반영한다. 전체 /proc/meminfo의 MemFree를 그대로 비교하는 코드가 아니다.
실제 종료 직전에는 다음 순서가 기록됐다.
| 시각 | pgskip 로그 두 항목 | 결과 |
|---|---|---|
| 21:40:40.707 | 0 / 0 | critical polling이지만 종료하지 않음 |
| 21:40:40.810 | 0 / 0 | critical polling이지만 종료하지 않음 |
| 21:40:41.013 | 0 / 17 | 직후 ONDEVICE 앱 종료 |
같은 로드 중 앞서 종료된 네 프로세스의 직전 값도 각각 0/3900, 0/664, 0/85, 0/158이었다. 이 값은 메모리 용량이 아니며, zone의 reclaim 스킵 카운터 증가량이다. 관측된 상관관계만으로 그 증가를 일으킨 구체적인 할당 요청이나 단편화를 확정할 수는 없다.
보드의 후속 /proc/zoneinfo 순서는 Normal → Movable이었다. 이 순서와 로컬 순회 코드를 적용하면 두 번째 로그는 Movable에 해당할 가능성이 높다. 다만 당시 로그에는 zone 이름이 없어 확정 표기는 피한다. 종료 이후 별도 스냅샷의 free는 Normal 11,156 pages(약 43.6MiB), Movable 371,770 pages(약 1,452.2MiB)였다. 이 값은 종료 순간 값이 아니며, 당시 watermark 계산을 재현하는 데 사용할 수 없다. 전체 여유량의 상당 부분이 Movable에 있을 수 있음을 보여주는 후속 관측이다.
로컬 소스에서 실제 출력된 종료 사유에 대응하는 조건은 critical 이벤트와 wmark <= WMARK_HIGH의 결합이다. 따라서 “RAM이 남으니 LMKD가 돌면 안 된다”보다, “이 시점에 LMKD가 계산에 포함한 zone의 여유가 부족했는가”를 확인하는 것이 맞다. 이 보드에서는 pgskip이 증가한 zone 제외와 종료가 함께 나타나므로, 전체 RAM 고갈 가설보다 이 경로를 우선 조사한다. 설치 LMKD와 로컬 코드의 전체 바이너리 일치, 종료 순간의 zone free·CMA·protection·배수·최종 wmark는 아직 확보하지 못했다.
현실적 대응 방향: 우선 로딩 중 호스트 메모리 피크와 다른 서비스의 동시 사용을 줄이는 방향을 검증한다. 압박이 지속될 때 즉시 재초기화를 반복하지 않는 backoff도 검토 대상이다. LMKD를 끄거나 우선순위만 올리면 다른 프로세스의 종료·지연으로 문제가 옮겨갈 수 있으므로 원인 해결로 간주하지 않는다. zone 배치나 watermark 설정 변경은 정확한 계산값을 수집한 다음 판단한다.
근거: 내부 domain/1/logcat.txt, lmk-pgskip-correlation.json, 종료 후 lmk-zone-current.txt; 로컬 lmkd.cpp의 calc_zone_watermarks, get_lowest_watermark, critical kill 분기. 이번 분석에는 추가 모델 로드나 압박 부하를 실행하지 않았다.
실행 LMKD 검증 — 로컬 산출물 일치와 현재 판단 설정
보드 /proc/545/exe와 /system/bin/lmkd, 로컬 QSSI lmkd_intermediates/lmkd의 SHA-256이 모두 00721b5df0e22a83b7bcc170f693d3543835af4af31c33792c0326d4a40c5fed로 일치했다. 대응하는 unstripped 파일의 .text도 보드 실행 파일과 동일했다. 따라서 앞선 “설치 LMKD와 로컬 산출물 일치 미확인”은 이 후속 확인으로 해소했다. 현재 소스 전체가 빌드 시점과 동일하다는 뜻은 아니므로 핵심 분기는 실행 코드에서도 확인했다.
역어셈블리의 calc_zone_watermarks는 pgskip 값이 0일 때만 zone 합산 경로로 들어간다. 따라서 pgskip이 증가한 zone을 제외한다는 동작은 로컬 소스상의 가설만이 아니라, 실제 실행 바이너리의 분기와도 일치한다. 당시 어느 zone의 free가 얼마였는지와 최종 watermark 계산값은 여전히 별도 증거가 필요하다.
대응 심볼과 실행 매핑 주소를 이용해 LMKD 프로세스 메모리의 다음 필드만 읽었다. 쓰기·attach·설정 변경·데몬 재시작은 수행하지 않았다.
| 현재 필드 | 읽은 값 | 의미와 한계 |
|---|---|---|
wbf_effective |
4 | low/high watermark 비교에 반영되는 배수. 동적으로 바뀌므로 과거 kill 시점 값으로 소급 불가 |
cache_percent |
0.0 | 현재 파일 캐시를 여유로 더하는 비율은 0. 캐시가 커 보여도 이 계산에 그대로 더해지는 것이 아님 |
debug_process_killing |
0 | 상세 zone/aggregate 로그가 출력되지 않는 현재 설정과 일치 |
설명이 더 명확해진 부분: 전체 MemFree뿐 아니라 표시된 Cached도 LMKD의 유효 여유량과 같지 않다. zone 선택, CMA 제외, 적용 배수를 거친 값을 비교한다. 현재 배수 4를 적용하면 high 기준은 원래 high보다 높아지지만, 과거 종료 순간의 수치나 원인을 이 스냅샷으로 재계산하지 않는다.
근거: 내부 board-lmkd, lmkd-board-text, lmkd-symbol-text, lmkd-zone-disasm.txt, lmkd-maps.txt, lmkd-runtime-settings.json. 실제 보드 실행 파일 해시와 코드 섹션을 대조했고, 이번에는 모델 로드나 메모리 압박을 발생시키지 않았다.
왜 RAM 여유와 다른가? 1,920·1,688·1,708MiB의 의미
| 숫자 | 출처 | 의미·주의점 |
|---|---|---|
| 1,920MiB | 새 보드 DT cb2 qcom,iommu-dma-addr-pool: base 0x80000000, size 0x78000000 |
DT에 선언된 IOVA 설정값. 실제 allocator 범위와의 일치는 미확인이며, 범위 밖 성공 주소도 관측됨. 물리 RAM 예약량이나 빈 연속 공간이 아님 |
| 1,688MiB | 실제 iommu_dma_alloc_iova 요청 1,769,996,288 bytes |
이번 실패에서 확보하려던 큰 주소 범위 |
| 약 1,708MiB | 이전 보드에서 관측한 FastRPC 7개 map의 size 합계 | 특정 시점의 map 크기 합계. 새 보드 실패 순간의 전체 IOVA 점유량이 아님 |
RAM에 저장할 페이지가 있어도, NPU가 접근할 수 있는 제한된 주소 범위 안에 큰 버퍼를 배치하는 단계는 별도로 성공해야 한다. 1,920 - 1,708을 계산해 “남으니 반드시 성공한다”고 판단할 수 없다. 다른 예약·매핑, 연속 구간, 정렬 제한을 모두 확인해야 한다.
첫 DMA 실패 직전의 이전 해제 완료 후 MemAvailable은 약 5.00GiB였고, 실패 후 약 5.06GiB였다. 실패 순간의 동시 측정값이나 로드 중 최저 가용 메모리는 아니다. 실패 단계를 판단하는 핵심 근거는 전후 RAM 수치가 아니라, IOVA 할당 함수의 직접 실패 반환이다. 단, alloc_iova 내부 관리 객체 할당 실패는 아직 배제하지 못했다. alloc_iova_mem probe는 호출 관측이 0건이어서 판단에 사용하지 않았다.
Swap 3GB와 연결되는가?
이번 DMA 오류 2회는 앱 Swap 약 3.7MiB에서도 발생했다. 따라서 3GB Swap이 있어야 발생하는 오류는 아니다. NPU 공유 버퍼가 시스템 RAM을 사용해 다른 익명 페이지의 swap-out을 간접 유발할 수 있다는 설명과, NPU DMA 버퍼 자체가 앱 Swap 3GB라는 주장은 다르다.
이번 시험은 모델 재로드만으로 3GB가 누적된다는 가설을 입증하지 않았다. 프로세스 종료 후 이전 PID의 사유 Swap이 새 PID에 계속 더해지는 설명도 맞지 않는다. 현장에서는 동일 PID의 host heap/익명 매핑과 SwapPss를 시간별로 수집해야 한다.
대응 방안 — 지금 적용할 것과 추가 검증할 것
| 대상 | 현실적인 대응 | 검증 조건·한계 |
|---|---|---|
| 초기화 실패 반복 | create/free 결과를 기록하고 자동 재시도 횟수·간격 제한; 새벽 자동 복구음 정책 별도 검토 | 구현 제안. 현재 제품에 적용 완료한 변경이 아님 |
| IOVA 확보 실패 | 성공/해제/실패의 alloc/free 및 IOVA tree를 비교하고 내부 실패 분기를 추가 추적 | 잔존 매핑·단편화·주소 제한과 관리 객체 실패를 구분해야 함 |
| 큰 weights 버퍼 | SoC/QNN 담당과 지원되는 분할 로딩/모델 변환 설정, 주소 범위 조정 가능성 검토 | 단순 pool 확장을 검증된 해결책으로 제시하지 않음; 호환성과 다른 사용자 영향 시험 필요 |
| 동일 PID 재시도 실패 지속 | worker 프로세스 재시작 시 복구 여부를 비교 시험 | 효과 미확인. 제품에 무제한 재시작 적용 금지 |
| 현장 Swap 3GB | 초기화·추론·장기 대기별 smaps/SwapPss 및 host 할당 수명 수집 | TTS ON의 457MiB 효과를 그대로 3GB에서 빼지 않음 |
증거 위치: 내부 시험 묶음 a1-newboard-20261016의 batch2/3/trace.txt:914–916, kernel.txt:16, logcat.txt:127–130; deep/1/trace.txt:756–762; run.log, batch2.log, deep.log. 원문 전체에는 기기·시스템 정보가 포함될 수 있어 공개 페이지에는 필요한 호출·수치만 발췌했다.
1. TTS ON/OFF — 얼마를 줄였고 무엇은 남는가
현상과 기존 보유 이유
긴 TTS를 생성한 뒤, 다음 입력이 짧아져도 큰 작업 공간이 남았다. 기존 ORT arena는 확보한 공간을 재사용해 다음 추론의 메모리 할당 비용을 줄이는 구조다. TTS 생성 지연을 줄이기 위한 재사용과 메모리 보유량 사이의 절충이며, 사용하지 않는 객체가 계속 새로 쌓이는 누수와는 구분해야 한다. 당시 제품이 이 정책을 명시적으로 선택한 이력까지 확인한 것은 아니다.
변경 방안과 의사결정
한 가지 개선 방안은 추론 후 arena 회수를 켜는 것(ON)이다. 모델 전체를 매번 다시 로드하지 않으면서 보유 메모리를 줄일 수 있지만, 다음 생성에서 필요한 공간을 다시 확보하는 비용이 생길 수 있다.
| 선택 | 장점 | 단점·제약 | 판단 기준 |
|---|---|---|---|
| OFF 유지 — 기본 전달 설정 | 작업 공간 재사용으로 생성 지연에 유리 | 긴 생성 후 큰 메모리가 남을 수 있음 | 메모리 여유가 충분하고 응답 속도가 우선인지 |
| ON 적용 — 회수 활성화 | 단독 시험에서 합성 후 약 457MiB 감소 | 긴 생성에서 평균 약 0.26초 증가; 합성 중 피크는 남음 | 체감 지연을 수용하고 메모리 여유 확보를 우선할지 |
의사결정이 필요하다: ON을 무조건 정상 사양으로 확정하지 않는다. 현재는 ON 체감 시험 중이며, 음성 자연스러움·응답성·동시 서비스 안정성을 함께 보고 기본 적용 여부를 결정한다. “첫 생성에서 0.23초 증가”라는 표현은 사용하지 않는다. 측정된 값은 긴 입력의 전체 합성 시간 평균이며 첫 음성 출력 지연과 동일하지 않다.
확인된 효과
Sherpa v1.11.3 기반 실험 라이브러리와 ORT 1.17.1 조건의 단독 TTS 프로그램에서 같은 입력 순서 6회를 비교했다. 아래 RSS는 마지막 합성 후 측정값이며, 합성 중 최고 RSS나 앱 전체 값이 아니다. 긴 입력 평균은 각 모드의 2·3·5·6회, 총 4개 표본이다. 출력 샘플 수가 완전히 동일하지 않아 지연 수치는 제한된 시험의 관측값이다.
| 측정값 | OFF | ON | 차이 |
|---|---|---|---|
| 마지막 합성 후 RSS | 667.973MiB | 211.211MiB | 456.762MiB 감소, 68.38% |
| 긴 입력 평균 생성 시간 | 3,240.657ms | 3,496.455ms | 255.798ms 증가, 약 7.9% |
| 짧은 입력 후에도 이전 큰 RSS가 남는가 | 4회차 약 665.5MiB | 4회차 약 211.0MiB | 이 시험에서 ON의 보유량 감소 확인 |
원본은 내부 진단 자료 device/native-summary.json, probe-off.log, probe-on.log다. 통계적 성능 보장이나 장기 누수 검증은 아니다.
ON/OFF가 실제로 회수하는 메모리
회수 대상은 TTS 모델 자체가 아니라, VITS 추론에 사용한 ORT CPU arena의 미사용 메모리 영역이다. Arena는 매번 OS/하위 할당자에 요청하는 비용을 줄이려고 큰 공간을 확보한 뒤 나눠 쓰는 메모리 풀이다. 중간 계산용 텐서가 수명을 다해도 그 공간은 다음 계산을 위해 풀에 남을 수 있다.
| 대상 | OFF | ON |
|---|---|---|
| 계산이 끝난 중간 텐서가 사용하던 작업 공간 | 텐서 수명은 끝나도 공간을 arena가 재사용용으로 보유 가능 | 영역 전체가 미사용이면 shrink 후보가 되어 하위 할당자에 반환 |
| 아직 사용 중인 텐서가 섞인 arena 영역 | 유지 | 유지 — 일부 빈 공간이 있어도 사용 중 chunk가 있으면 해당 영역 전체를 반환하지 않음 |
| TTS 모델 가중치·ORT 세션 | 유지 | 유지 — 모델 unload/세션 재생성 기능이 아님 |
| 아직 참조 중인 출력 텐서·생성된 PCM·재생 대기 음성 | 정상 수명에 따라 유지/해제 | 정상 수명 유지 — 재생할 음성을 강제로 지우지 않음 |
| STT 모델/arena, LLM·QNN/NPU 버퍼, Java 버퍼 | 이번 스위치 대상 아님 | 이번 스위치 대상 아님 |
동작 순서는 다음과 같다.
OFF: VITS 계산 → 중간 텐서 사용 종료 → arena가 빈 공간 보유 → 다음 계산에 재사용
ON : VITS 계산 → 중간 텐서 사용 종료 → Run 종료 시 arena 검사
                                      → 완전히 비어 있는 회수 가능 영역 반환
                                      → 다음 계산에 필요하면 다시 할당
회수 시점은 음성 재생 종료가 아니라 해당 ORT Run() 종료 시점이다. 재생 완료를 기다리는 타이머나 앱 전체 GC가 아니다. 반환할 영역이 없으면 ON이어도 회수량은 작거나 0일 수 있다. 기본 kNextPowerOfTwo 확장 정책에서는 첫 할당 영역도 shrink 대상에서 제외된다. 따라서 “ON이면 모든 여유 메모리를 즉시 0으로 만든다”는 기능은 아니다.
구현은 offline-tts-vits-model.cc의 세 sess_->Run() 경로에 GetVitsRunOptions(config_.provider)를 전달한다. ON 빌드이면서 provider가 cpu일 때만 memory.enable_memory_arena_shrinkage=cpu:0을 설정하고, OFF 빌드는 이 옵션을 넣지 않는다. OFF는 텐서 해제를 전부 끄는 것이 아니라, 이번에 추가한 arena shrink 요청을 끄는 것이다. CPU arena 자체를 비활성화하는 변경도 아니다.
ORT 1.17.1의 BFCArena::Shrink()는 회수 후보 영역에 사용 중 chunk가 없는지 확인하고 device_allocator_->Free(region_ptr)를 호출한다. 하위 할당자의 캐시·단편화 정책 때문에 이 호출량과 OS에서 즉시 감소하는 RSS가 항상 같지는 않다. 약 457MiB는 이 원리로 계산한 예상량이 아니라 단독 시험에서 실제 관측한 RSS 감소량이다. ORT 1.17.1 구현, 공식 arena shrink 설명
이 때문에 ON은 유지 메모리를 줄이는 대신 영역 검사·반환 및 이후 필요한 공간 재할당 비용을 추가할 수 있다. 긴 생성에서 관측한 평균 약 0.26초 증가는 이러한 절충을 평가하는 지표이며, 모든 증가분을 재할당 하나에 귀속한 프로파일링 결과는 아니다. 합성 중 최대 작업 공간은 여전히 필요하다.
기본 전달물은 OFF이고 ON은 라이브러리 교체로 선택한다. 앞선 체감 시험 기기는 ON으로 준비했으며, 이후 연결한 새 보드의 ON/OFF 배포 상태를 이 결과로 보장하지 않는다.
결론: 개선 효과를 수치로 확인한 것은 TTS의 합성 후 보유량이다. 앱 전체의 OFF/ON 교대 시험은 미완료이고, 현장 Swap 3GB 감소나 LMKD 방지를 입증하지 않았다. 457MiB를 현장 3GB에서 그대로 빼서 잔여량을 계산하지 않는다.
다음 비교 시험의 합격 기준
동일 APK·모델·초기 상태에서 OFF와 ON을 교대로 시험한다. 짧은/긴 문장, 반복, 취소를 구분하고 합성 전·중 최고·종료·대기 후의 RSS/PSS/SwapPss와 생성 지연을 기록한다. 음질·첫 음성 지연·재생 연속성도 함께 판단한다. 사용자 테스트 중에는 이 비교를 위해 앱을 재시작하지 않았다.
2. Swap 약 3GB — 현재 결론과 원인을 확인할 방법
지금 내릴 수 있는 결론
현장에서는 앱에 약 3GB의 Swap이 잡혔다. 하지만 그 메모리를 LLM의 어떤 버퍼가 보유했는지는 아직 확인하지 못했다. 지금 가장 먼저 확인할 대상은 LLM을 로딩하거나 실행할 때 앱 쪽에 만든 큰 작업 버퍼가 사용 후에도 남는지다. 이는 조사 우선순위이며, LLM 누수나 모델 결함이 확정됐다는 뜻은 아니다.
NPU로 계산해도 앱은 모델을 읽고 NPU에 전달하며 실행 상태를 관리할 메모리가 필요하다. 따라서 NPU 실행과 앱 Swap 발생은 함께 일어날 수 있다. 다만 NPU에 연결한 공유 버퍼와 앱의 일반 작업 버퍼는 구분해야 한다.
① 현장 숫자는 무엇을 뜻하는가?
아래는 전달받은 첫 kill 10건의 범위다. 단위는 팀원이 전달한 표의 MB를 그대로 사용했다. 원본 LMKD 로그 및 환산 기준은 아직 받지 못했다.
| 현장 수치 | 쉬운 설명 | 이 수치만으로 알 수 없는 것 |
|---|---|---|
| RSS 887.5~1,470.0MB | kill 직전 앱의 페이지 중 RAM에 올라와 있던 양 | 앱이 확보한 메모리 전체, 실제 kill 후 늘어난 여유 RAM |
| Swap 3,153.6~3,406.1MB | LMKD VmSwap 기준이라면, 앱의 익명 메모리 중 swap으로 옮겨진 양 | 어느 기능이 할당했는지, 언제부터 남았는지, 압축 후 실제 RAM 점유량 |
RSS가 900MB라고 해서 앱이 900MB만 보유한 것은 아니다. Swap으로 옮겨져도 앱 관점에서는 그 메모리를 계속 보유하며, 다시 접근하면 RAM으로 가져와야 한다. zram을 쓴다면 표의 약 3GB는 압축 전 논리 크기이며 실제 압축 저장 공간이 3GB라는 의미는 아니다. 또한 kill 로그의 RSS/Swap은 종료 직전 집계이므로 “물리 RAM을 그만큼 회수했다”는 실측값과 같지 않다.
RSS 차이는 접근한 페이지, swap으로 이동한 양, 파일 페이지 회수, 수행한 작업과 할당량 등이 다르면 생긴다. 중요도가 RSS 목표치를 800MB나 1,400MB로 정하는 것은 아니다. 중요도는 LMKD의 희생 대상 선택에 영향을 주며, RSS는 당시 실제 상주 상태다. 이번 표에서는 RSS가 줄어든 만큼 Swap이 정확히 늘어난 관계도 아니므로, 편차 전부를 swap 이동 하나로 설명할 수 없다.
② 가장 먼저 의심하는 과정 — 아직 검증할 가설
LLM 모델 로딩 / 추론
        ↓
앱 쪽에 큰 작업 버퍼 할당
        ↓
작업이 끝나도 버퍼 또는 할당자 풀이 보유 [확인 필요 A]
        ↓
다른 서비스 + NPU 공유 RAM 사용으로 시스템 여유 감소 [확인 필요 B]
        ↓
최근 접근하지 않은 앱 페이지가 swap으로 이동
        ↓
앱 RSS는 일부만 보이고, Swap은 크게 남음
이 과정이면 “지금 추론하지 않는데도 Swap이 크다”는 현상을 설명할 수 있다. 하지만 현장 3GB가 실제로 이 과정을 거쳤다는 시간대별 자료는 아직 없다. 단순 대기만으로 3GB가 새로 만들어지는 것이 아니라, 그 전에 앱이 해당 메모리를 할당하고 사용한 경로부터 찾아야 한다.
NPU 공유 RAM은 압박을 만드는 원인일 수 있고, Swap에 들어간 앱 버퍼는 별개의 대상일 수 있다. 이 둘을 합쳐 “NPU 모델 3GB가 swap됐다”고 설명하면 안 된다.
③ 현재 증거는 어디까지인가?
| 확인한 사실 | 여기서 내릴 수 있는 판단 |
|---|---|
| 현장 첫 kill 10건 모두 Swap 약 3.15~3.41GB | 공통 실행 경로나 보유 정책을 조사할 이유가 있음. 같은 원인이라는 증명은 아님 |
| 현재 시험기는 NPU 큰 매핑 약 1.65GiB가 있는데 앱 VmSwap 0KiB | 큰 NPU 버퍼가 존재하는 것만으로 Swap 3GB가 필수적으로 생기는 것은 아님 |
| 현재 앱 native 할당자 영역 RSS 약 888MiB | 앱 일반 작업 메모리도 큼. 이 값은 현재 RAM 상주량이며 현장 Swap 3GB의 소유자를 알려주지 않음 |
| SDK 수정 이력에 모델 파일 mmap 관련 수정이 있음 | 로딩 방식 확인의 단서. 우리 버전의 결함이나 3GB 원인으로 확정할 수 없음 |
| TTS 단독 시험에서 ON이 합성 후 약 457MiB 절감 | TTS 개선은 확인됨. 현장 Swap 3GB를 TTS로 설명하거나 LLM을 제외할 근거는 아님 |
현재 빠진 핵심 증거는 “어느 기능이 몇 GB를 할당했고, 사용 후에도 무엇이 살아 있는가”다. kill 순간의 합계와 압박이 없는 현재 기기의 측정만으로는 이 질문에 답할 수 없다. 따라서 현 단계의 결론은 “LLM 호스트 버퍼를 우선 조사할 근거는 있으나, 3GB의 직접 소유자·보유 이유는 미확정”이다.
④ 다음 시험은 세 갈래만 먼저 구분한다
| 순서 | 시험 조건 | 결과가 이렇게 나오면 | 이어질 조치 |
|---|---|---|---|
| 1 | TTS/STT를 제외하고 LLM 초기화 전·중·후 비교 | 초기화 직후 큰 익명 버퍼가 남음 | 모델 읽기·복사·역직렬화 버퍼의 할당/해제 추적. 불필요한 복사본인지 확인 |
| 2 | LLM만 같은 조건으로 반복 추론 | 반복할수록 살아 있는 할당량 증가 | 누수·캐시·세션 누적 구분. 일정량에서 안정되면 보유 정책 검토 |
| 3 | 초기화 후 장기 대기 및 통제된 병행 부하 | 익명 RSS는 줄고 Swap은 늘며, 익명 RSS+Swap은 대체로 유지 | 새 할당보다 기존 보유 메모리의 swap 이동을 지지. 버퍼 수명과 동시 실행 메모리 예산 검토 |
세 시험에서 같은 PID의 영역별 RSS·Swap, 살아 있는 할당의 호출 경로, NPU 공유 버퍼, 시스템 압박을 함께 기록한다. 3번의 비교는 파일·공유 영역을 섞은 전체 RSS 합계가 아니라 동일 익명 영역을 대상으로 해야 한다. 초기화 중 재차 kill된 사례는 별도로 초기화 피크와 재시작 간격을 확인한다.
⑤ 지금 무엇을 결정할 수 있는가?
- TTS ON/OFF: 메모리 절감과 긴 생성 지연을 비교해 적용 여부를 결정할 수 있다. Swap 3GB 해결 효과는 별도 검증이 필요하다.
- LLM 메모리 개선: 아직 해제할 버퍼를 특정하지 못했으므로 임의 해제나 모델 교체를 해결책으로 확정할 수 없다. 위 시험으로 불필요한 복사본·반복 증가·장기 보유 중 어느 경우인지 먼저 가른다.
- RSS 800MB 유지: Swap으로 더 밀어내서 RSS만 낮추는 것은 메모리 보유량 감소가 아니다. 모델 기능·응답성·초기화 피크까지 포함한 예산 검증 없이 800MB 보장을 제시할 수 없다.
담당자 공유용: “앱에 잡힌 약 3GB Swap은 앱이 보유하던 익명 메모리가 swap으로 이동한 값으로 해석됩니다(원본 LMKD 로그 대조 필요). NPU 공유 버퍼 자체가 3GB swap됐다는 근거는 없습니다. 현재는 LLM 초기화·추론 과정의 앱 측 버퍼가 장기 보유되는지 우선 조사하고 있으며, 직접 소유자는 아직 특정하지 못했습니다. 초기화만/반복 추론/장기 대기 조건을 분리해 보유 시점과 해제 여부를 확인하겠습니다.”
상세 근거 — 코드·측정값·SDK 확인 내역
아래 내용은 위 판단의 기술적 근거다. 위 시험 계획은 아직 수행 완료된 결과가 아니다.
우리 프로세스의 메모리인가?
그렇다. 현장 표가 해당 LMKD 로그를 변환한 것이라면 우리 프로세스에 귀속되는 값이다. QSSI system/memory/lmkd/lmkd.cpp:2959는 /proc/PID/status의 VmSwap을 읽고, 2996~3004행은 이를 kill 로그의 swap으로 출력한다. 표만 전달받았으므로 원문 로그와 MB 환산 규칙은 아직 대조하지 못했다.
VmSwap은 익명 private 페이지의 swap 사용량이며 공유 메모리 swap은 이 항목에 포함되지 않는다. 공유 페이지/압축 전 크기 등 집계 차이 때문에 RSS+Swap을 고유 물리 RAM 사용량으로 해석하지 않는다. Linux proc 문서
zram의 논리 데이터 크기와 실제 RAM 점유량은 다르다. orig_data_size, compr_data_size, mem_used_total을 구분해야 한다. 이 통계는 시스템 전체 값이며 앱별 실제 압축 점유량으로 바로 환산할 수 없다. Linux zram 문서
LLM이 NPU에서 실행돼도 메모리를 세 종류로 나눠야 한다
| 영역 | 실제 역할 | Swap 3GB와의 관계 |
|---|---|---|
| 모델 파일의 clean mmap 페이지 | 저장장치의 context binary를 주소 공간에 매핑 | 일반적으로 파일에서 다시 읽을 수 있어 회수 가능. clean 파일 페이지 자체를 익명 VmSwap으로 설명할 수 없음 |
| LLM 호스트 native heap | 로딩·역직렬화·복사·런타임 상태·일부 작업 버퍼 후보 | 실제 익명 페이지를 보유한다면 VmSwap 직접 후보. 현재 소유량과 수명은 미확정 |
| NPU/FastRPC의 ION DMA-BUF | HTP가 접근하는 공유 DDR | 현재 관측한 ION 공유 버퍼를 익명 VmSwap으로 간주할 수 없음. 시스템 여유 RAM 감소를 통한 간접 압박 후보 |
플랫폼의 ION system heap은 커널 페이지 풀/SG table을 통해 DMA 버퍼를 제공하고 FastRPC는 DMA-BUF attach/map을 수행한다. 모든 DMA-BUF 구현이 동일하다는 일반화가 아니라 이 기기의 ION/FastRPC 경로에 대한 구분이다. NPU 버퍼가 1.65GiB라는 이유로 그것이 swap에 들어간 1.65GiB라고 계산하면 안 된다.
이번 읽기 전용 측정: NPU 큰 버퍼와 Swap 0이 동시에 존재
2026-10-16 16:11:48 KST, 같은 프로세스 PID 유지 상태에서 수집했다.
| 지표 | 관측값 | 의미 |
|---|---|---|
| 앱 RSS | 1,091,176KiB ≈ 1,065.6MiB | 현재 상주량 |
| 앱 VmSwap | 0KiB | 이 조건에서 3GB swap 미재현 |
| smaps_rollup Swap / SwapPss | 44KiB / 0KiB | 공유 영역을 포함하는 집계 차이; 미미한 수준 |
| Scudo primary + secondary RSS | 약 888.2MiB | native 익명 영역의 큰 비중; 전부 LLM이라고 귀속할 수 없음 |
| FastRPC | cid=3, 앱 tgid 일치, 매핑 7개, smmu.faults=0 | 현재 NPU 연결과 매핑 확인 |
| 가장 큰 NPU 매핑 | 1,769,996,288 bytes ≈ 1.648GiB | 이전 관측과 같은 크기 |
| 시스템 MemAvailable | 약 1,652.5MiB | 순간 여유량; 장기 안정성 증명 아님 |
FastRPC debugfs의 size는 0x 접두어가 있어도 해당 드라이버 포맷이 십진수이므로 십진수로 파싱했다. 다른 서비스의 CDSP 연결은 앱 tgid와 구분했다. 원본은 내부 followup-review/npu-swap-readonly.txt, npu-swap-smaps.txt에 보관한다.
의미: 약 1.65GiB의 NPU 공유 버퍼가 있다는 사실만으로 앱 Swap 3GB가 필수적으로 발생하지 않는다. 반면 큰 NPU 비용이 다른 서비스와 겹쳐 압박을 만드는 가능성은 남는다. 이전 정지 시험에서 큰 버퍼가 사라졌다는 결과도 있으나, 압박 중 자동 재시작이나 장기 운전까지 보증하지 않는다.
LLM/NPU 원인 후보 — 직접 소유와 간접 압박을 분리
| 우선순위 | 가설 | 현재 근거 | 아직 필요한 증거 |
|---|---|---|---|
| 1 | 모델 로딩·복사 후 호스트 버퍼가 남음 | 모델 binary 약 1.65GiB, 큰 native 익명 영역, 아래 mmap 관련 SDK 수정 이력 | 로딩 중 할당 stack과 로딩 완료 후 살아 있는 할당량; 파일 크기의 두 배라는 산술만으로 증명 불가 |
| 2 | NPU 공유 RAM 비용이 시스템 압박을 유발하고 앱의 차가운 heap이 swap으로 이동 | 약 1.65GiB의 NPU 버퍼 실측 | 타 서비스 사용량·PSI·reclaim과 앱 Swap 증가의 동시 추이; 이동한 heap 소유자는 따로 규명 |
| 3 | LLM 반복 추론 후 호스트 작업 공간 보유/누수 | 세션을 유지하며 query/reset 호출하는 앱 구조 | TTS/STT를 호출하지 않는 LLM-only 반복의 증가량과 안정화 여부 |
| 4 | 세션 재초기화·실패 경로에서 구/신 자원 중첩 | 현장 초기화 중 재차 kill 2대, free 오류 처리 공백 | PID·create/free·매핑 시간축; 이전 자원이 실제로 남았는지 |
앱 main.cpp의 DsDialog::Init은 기존 handle이 있으면 생성하지 않는 방어가 있다. 정상 호출만으로 중복 세션이라고 단정할 수 없다. Query의 GenieDialog_reset은 dialog reset이며 host heap 전체를 OS에 반환한다는 API 보장이 없다. UnInit은 free 실패 여부와 무관하게 handle을 지우므로 오류 시 추적을 보강할 필요가 있지만 실제 SDK 누수 발생 증거는 아니다.
새 단서: use-mmap 설정만으로 실제 파일 매핑 동작을 보장할 수 없음
현재 기기 JSON은 QnnHtp, use-mmap=true, mmap-budget=0, spill-fill-bufsize=0, context 128, allow-async-init=false다. 로컬 QAIRT 2.44 문서의 QNN revision history 2.41.0 / issue 157330에는 use-mmap 활성화에도 HTP 엔진이 serialized binary를 mmap하지 않던 문제를 수정했다는 항목이 있다.
따라서 이전 설명 중 “true 설정이므로 heap 복사 경로는 배제 가능”이라는 추론은 사용할 수 없다. 이것은 우선 조사할 SDK 동작 단서이지 현장 원인 확정이 아니다. 수정 이력만으로 영향을 받는 최초 버전·우리 버전 포함 여부·메모리 장기 보유를 알 수 없다.
현재 관측 기기의 기존 런타임 확인값은 QNN 2.34 / Genie 1.8이며, 사용자가 지목한 QNN 2.24 / Genie 1.8 및 현장 A1_1.8.0과는 동일성을 확인해야 한다. 2.24, 2.34, 문서 2.44를 같은 버전으로 취급하지 않는다. 2.44 문서는 수정 이력 확인에만 사용했으며 라이브러리를 교체하지 않았다.
후속 smaps에서 context binary 이름의 VMA는 보이지 않았다. 로딩 시에만 mmap하고 정상 unmap했을 수도 있으므로 현재 VMA 부재는 해당 버그의 재현 증거가 아니다. 또한 clean 파일 매핑이 보이더라도 별도 heap 복사가 없다고 보장하지 않는다.
기존 모델 metadata 분석에서 노출 KV 입출력 총량은 약 8MiB였다. 내부 workspace·복제·다중 세션은 별도지만, 노출 KV 크기만으로 3GB를 설명할 수 없다. 모델 파일 크기 약 1.65GiB와 현장 swap 약 3.2GB가 비슷한 배수라고 두 벌 복사로 결론내리지 않는다.
찰나의 회수 전인가, 오래 보유한 것인가?
두 경우 모두 가능하다. 그러나 현장 kill 시점 표만으로 유지 시간을 알 수 없다. OFF의 arena/런타임 버퍼는 추론이 끝나도 세션 수명 동안 남을 수 있어 “기다리면 반드시 회수된다”는 전제는 성립하지 않는다. ON도 지정 TTS 경로의 회수이지 LLM 전체 회수가 아니다.
10대 첫 kill의 Swap은 3,153.6~3,406.1MB로 비슷하다. 공통 모델/런타임 보유량이라는 가설을 검토할 이유는 있지만, kill 조건으로 선택된 표본이므로 짧은 피크인지 장기 plateau인지 구분하는 증거는 아니다.
해결 방향과 가설 판별 시험
| 시험 | 함께 측정할 항목 | 판별 기준 |
|---|---|---|
| LLM 초기화만 실행 | 모델 open/mmap/unmap, malloc/free stack, host RSS/PSS/SwapPss, DMA-BUF | 로딩 후 큰 host 복사본이 남는지 |
| TTS/STT 없이 LLM 반복 | 반복 횟수, 토큰 수, query/reset 결과, native 살아 있는 할당, NPU 매핑 | 반복에 비례한 증가인지 일정 크기에서 안정되는지 |
| 초기화 후 장기 대기 + 통제된 병행 부하 | host RSS+Swap 추이, PSI, swap-in/out, zram 실점유 | 해제인지 swap 이동인지, NPU 간접 압박과 시점이 맞는지 |
| 별도 시험기의 LLM 해제·재로딩 | free 성공, 남은 host allocation, 매핑 수/크기, 다음 초기화 peak | 반환 누락 또는 구/신 자원 중첩 여부 |
초기 읽기 전용 조사에서는 사용자 체감 시험 기기에 위 부하·재시작 시험을 수행하지 않았다. 이후 새 보드의 LLM 로드·해제 시험 결과는 문서 상단에 추가했다. 원인별 조치는 ① 불필요한 로딩 복사본 조기 해제, ② SDK 결함 확인 시 해당 수정의 적용·회귀 검증, ③ 필요 없는 세션/버퍼 수명 축소, ④ 시스템 동시 실행 예산 및 압박 중 재초기화 backoff다. 어느 조치가 필요한지는 위 판별 결과로 선택한다. swappiness 조정이나 RSS 800MB 제한만으로 해결 완료라고 판단하지 않는다.
근거와 Connections
- 기존 상세 분석·현장 10대 표·모델 metadata·NPU 종료 시험
- 앱 소스:
app/src/main/cpp/main.cpp,native-lib.cpp; TTS 전달물tts-arena-switch/README.md및device/native-summary.json. - 플랫폼: QSSI
system/memory/lmkd/lmkd.cpp:2959,2996; UMkernel/msm-5.4/drivers/char/adsprpc.c및drivers/staging/android/ion/heaps/ion_system_heap.c. - SDK:
QAIRT-Docs/QNN/general/revision_history.html, 2.41.0 issue 157330;include/Genie/GenieDialog.hreset API. 전체 SDK 원문·기기 식별자·대화 로그는 공개 자료에 넣지 않았다.
이번 결론: TTS 합성 후 약 457MiB 절감은 확인했다. Swap 3GB는 LLM의 host 버퍼 소유와 NPU 공유 RAM의 간접 압박을 분리해 조사해야 하며, 직접 소유자와 유지 시간은 아직 확정하지 못했다.
10/19 IOVA 보충 기록
10/19 추가 실측: 작은 주소 점유가 큰 요청을 막는 사례
같은 네이티브 프로세스에서 모델 생성·해제를 12회 모두 완료했다. 별도 압박 프로세스는 추가하지 않았다. 1,688MiB 요청 12건 중 2건은 첫 alloc_iova가 NULL을 반환했고 내부 재시도에서 성공했다. 12건의 최종 주소는 모두 설정 범위 안이었다. 최종 DMA -12는 이번에 재현되지 않았다.
| 회차 | 첫 탐색의 작은 점유 PFN | 그 위 빈 구간 | 필요 크기 | 재시도 성공 PFN |
|---|---|---|---|---|
| 3 | 0x8afff (4KiB) |
0x8b000~0xf45ff: 1,686MiB |
1,688MiB | 0x8ae00~0xf45ff |
| 9 | 0x8a1ff (4KiB) |
0x8a200~0xf37ff: 1,686MiB |
1,688MiB | 0x8a000~0xf37ff |
해석: 작은 주소 점유의 위치가 큰 연속 매핑을 방해하는 구체적 배치를 확인했다. 큰 요청 크기만 줄이거나 RAM 잔량만 보는 접근은 부족하다. 다만 이번에는 해당 노드의 삭제 이벤트와 객체 소유자를 직접 수집하지 않아, “특정 FastRPC 버퍼를 회수해서 해결됐다”까지 확정하지 않는다. 내부 재시도 경로에서 성공했다는 사실과 주소 트리의 변화가 증거다.
이번 표본 MemAvailable은 약 2.54~4.70GiB였지만, 이는 초기화 전후 표본이며 할당 실패 순간 값은 아니다. trace는 16,296/16,296개가 보존됐고 alloc 반환 probe는 전체적으로 4회 누락이 있었으나 대상 큰 요청 14회(재시도 포함)는 진입·반환 쌍을 확보했다. 같은 PID여도 중간에 IOVA 도메인 주소가 바뀌어 전체 회차를 동일 도메인 누적 시험으로 보지 않는다. 네이티브 프로세스 종료와 진단 probe 제거를 확인했다.
시험 중 카메라 등 다른 프로세스의 종료가 관측됐고, 시험 종료 후 제품 앱 초기화에서도 LMKD가 세 차례 발생했다. 따라서 이 시험은 무압박·무간섭 기준선이 아니다. NPU 매핑 성공과 제품 전체 초기화 생존성을 구분한다. 최종 복구 PID 27842에서 LLM·STT·TTS 초기화 성공과 STATE_PRE_RECORDING 진입을 확인했다. 진단 프로세스와 probe는 남아 있지 않다.
IOVA 건의 현 단계 결론: 실패 계층은 장치 주소 할당으로 확정했고, 작은 주소 점유에 따른 연속 구간 부족을 뒷받침하는 재현 근거를 추가했다. 과거 최종 -12를 일으킨 잔존 객체의 소유자와 경계 처리 결함 여부는 미확정이다. SoC 쪽 수정 검증에서는 전체 주소 트리·해제 이벤트·실행 커널 경계 분기를 같은 실패에서 확보해야 한다. 캐시 반환 뒤에도 실패한 과거 사례가 있으므로 단순 재시도만으로 해결됐다고 결론내리지 않는다.
로컬 원본: /mnt/c/Temp/a1-iova-20261019/의 trace.txt, large-allocations.txt, run.log, profile.txt, snapshots.tar, recovery-latest.txt. 기존 10/16~18 기록은 위에 보존했다.
10/19 후속 정밀 추적
10/19 후속 40회: 캐시 예약과 경계 결함을 분리 확인
새 결론: 일시적인 IOVA 실패 중에는 이미 반환 가능한 작은 주소 예약이 큰 연속 할당을 막는 경우가 있다. 또 재시도 중 설정 하한이 0으로 바뀌어 범위 밖 주소를 반환하는 allocator 경계 결함을 실제 실행에서 확인했다. 따라서 GenieDialog_create=0만으로 정상적인 장치 주소 배치라고 판정할 수 없다.
| 추가 시험 | 모델 생성·해제 반환 성공 | 큰 요청의 첫 할당 실패 | 작은 예약 삭제 후 정상 범위 성공 | 설정 하한 아래로 반환 |
|---|---|---|---|---|
| CPU 캐시·주소 삭제 추적 | 20/20 | 9 | 8 | 1 |
| FastRPC 소유 경로·경계 레지스터 추적 | 20/20 | 6 | 5 | 1 |
| 합계 | 40/40 | 15 | 13 | 2 |
40회 모두 API 생성·해제는 완료했다. 하지만 2회의 주소 경계 이탈 때문에 40회 정상 매핑 통과라고 표현하지 않는다. 최종 DMA -12는 이번 추가 40회에서는 발생하지 않았다.
A. 캐시 예약 때문에 실패했다가 회복한 13건
각 실패 호출의 주소 탐색에서 작은 4KiB 노드를 확인했고, 같은 스레드의 CPU 0~7 IOVA 캐시 정리 과정에서 그 노드의 rb_erase 이벤트를 포착했다. 이어 같은 1,688MiB 요청이 정상 범위에서 성공했다. 단순히 “캐시가 원인일 수 있다”에서 해당 주소 노드 삭제와 성공의 연결을 관측한 단계로 좁혔다. 이 캐시는 TTS arena나 Swap이 아닌 커널 IOVA 주소 예약 캐시다.
B. 잔존 FastRPC 매핑과 범위 밖 성공을 확인한 사례
동일 주소의 재사용을 혼동하지 않도록 실패 시점을 포함하는 매핑 생존 구간을 비교했다.
| 보드 monotonic 시각(초) | 관측 |
|---|---|
| 90005.964236 | 같은 LLM 시험 프로세스의 FastRPC 작업 스레드가 fd 11, 4KiB, 전달 길이 24bytes를 0x28a3ff000에 map |
| 90005.995886 | 모델의 1,688MiB 첫 IOVA 요청이 NULL 반환 |
| 90005.995982 | 재시도 시작 노드가 anchor; low_new=0, 원래 하한 0x80000 |
| 90005.995991 | 재시도 경계 변수 low=0, 설정 하한은 0x80000인 채로 기록 |
| 90005.996001 | PFN 0x20a00~0x8a1ff 반환: 시작 IOVA 0x20a00000은 허용 시작 0x80000000보다 낮음 |
| 90005.996886 | FastRPC가 fd 16, 1,769,996,288bytes를 0x220a00000에 map했다고 기록 |
| 90006.538517 | 앞의 fd 11 매핑 unmap |
FastRPC 로그의 상위 context-bank 표기를 제외한 하위 IOVA를 비교했다. 로컬 adsprpc.c는 cb << 32를 주소에 합치는 경로를 포함한다. 방해 노드 PFN 0x8a3ff는 작은 버퍼의 IOVA 0x8a3ff000과 일치하고, 그 위의 빈 구간은 1,686MiB로 필요한 1,688MiB보다 작았다. 실패 시점에는 map 이후·unmap 이전이므로, 이 사례의 노드는 단순히 삭제 가능한 CPU IOVA 캐시 예약으로 볼 수 없다. 다만 QNN 내부의 정확한 버퍼 명칭·업무 용도까지 특정하지는 않았다.
C. 실행 코드와 알려진 수정 방식 대조
보드의 실행 중인 alloc_iova 기계어를 읽었고, 경계 처리 구간 +0x230~+0x2c8의 39개 명령이 로컬 빌드와 일치했다. 전체 커널 이미지 동일성을 주장하는 검사는 아니다. 이 구간은 anchor의 최대 unsigned PFN에 먼저 1을 더하고, 재시도 하한에 그 값을 넣는 동작을 포함한다. 위 레지스터 기록은 실제로 값이 0이 된 경로를 증명한다.
Android 공통 커널에는 같은 overflow 유형의 수정 이력이 있다. 덧셈 이전 값으로 범위를 비교한 뒤 재시도에 진입할 때만 1을 더하도록 바꾼다. Android common 수정 원문
관측한 주소 트리 상단을 사용한 호스트 알고리즘 모델에서도 기존 분기는 0x20a00을 반환하고, 수정 방식은 해당 배치에서 할당 실패를 반환했다. 정상 연속 공간이 있는 대조 조건에서는 양쪽 모두 합법 주소를 반환했다. 이것은 분기 동작 검증이며, 보드 커널 패치·제품 회귀 시험은 아니다. 실제 기기의 커널이나 라이브러리를 교체하지 않았다.
현실적인 수정 순서와 남은 범위
- SoC 커널 담당: overflow 수정의 5.4 vendor 커널 적용성 검토. 수정 후 모든 대형 매핑이
[0x80000000, 0xf8000000)안에 있는지를 합격 기준으로 삼는다. - QNN/FastRPC 담당: 대형 weights 매핑 전에 생성된 작은 버퍼의 배치·수명 확인. 유효한 매핑을 임의로 해제하지 않고, 매핑 순서 조정·별도 도메인·배치 정책 등의 지원 가능성을 검토한다.
- 수정 검증: 경계 결함 수정은 비정상 성공을 올바른 실패로 바꿀 수 있다. 주소 배치 개선과 함께 반복 초기화 성공률·해제·정상 추론·카메라 동작을 확인해야 한다. 단순 재시도나 풀 확대만으로 해결 판정하지 않는다.
남은 핵심 한계: 과거 최종 DMA -12 사례의 잔존 객체 소유자까지 소급 확정한 것은 아니다. 이번에 확인한 경계 결함이 현장 Swap 3GB나 모든 LMKD를 설명한다는 증거도 없다. 현장 Swap 원인은 계속 별도 미확정이다.
측정 품질: 두 trace는 각각 26,312/26,312개와 27,501/27,501개를 보존했다. 전체 alloc 반환 probe에는 각각 18/12회 누락, 두 번째 erase probe에는 1회 누락이 있었으나 대상 큰 요청은 각각 29/26회의 진입·반환을 모두 짝지었다. 경계 변수 probe의 누락은 없었다. 진단 probe 자체의 시간 영향과 시험 도중 다른 프로세스의 LMKD 가능성이 있어 성능·현장 발생률 통계로 사용하지 않는다. 마지막 복구 PID 21088에서 LLM/STT/TTS 초기화 및 음성 대기를 확인했고 추가 probe·시험 프로세스를 정리했다.
로컬 근거: /mnt/c/Temp/a1-iova-20261019/repeat/, boundary-owner/, runtime-alloc-iova-disasm.txt, boundary-code-match.json, allocator-model-result.json.