MINI+MESH 잠정 결론 — Default / F 0.55 / F 0.6
MINI+MESH의 잠정 기본값은 F 필터 + AGC ON + vol 0.55 + EQ_TOTAL_GAIN 0으로 잡는다. gain을 올리는 방법은 이번 녹음으로 확인됐다. 후보를 계속 늘리기보다 이 값을 기준으로 실제 음성인식을 평가한다.
이것은 현재 실측에 근거한 보수적인 기본값 선정이지, 음성인식률 1위가 입증됐다는 뜻은 아니다. 마이크에서 잃은 정보나 신호 대 잡음비는 출력 증폭만으로 복구되지 않는다. 원래 A1 수준의 완전한 RMS 회복도 아직 직접 비교하지 않았다.
먼저 결론 3개
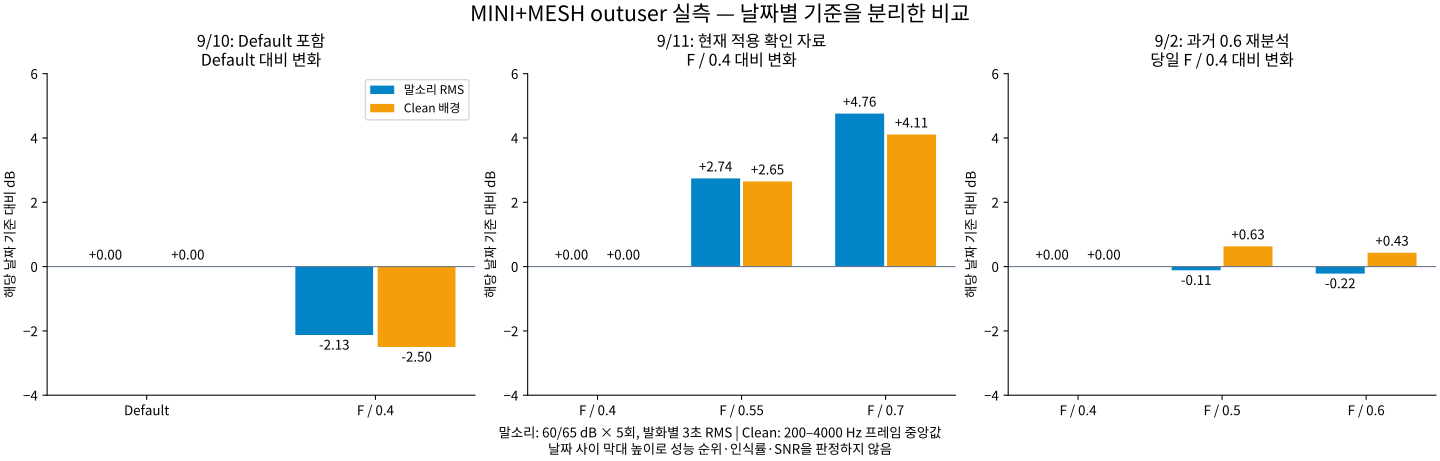
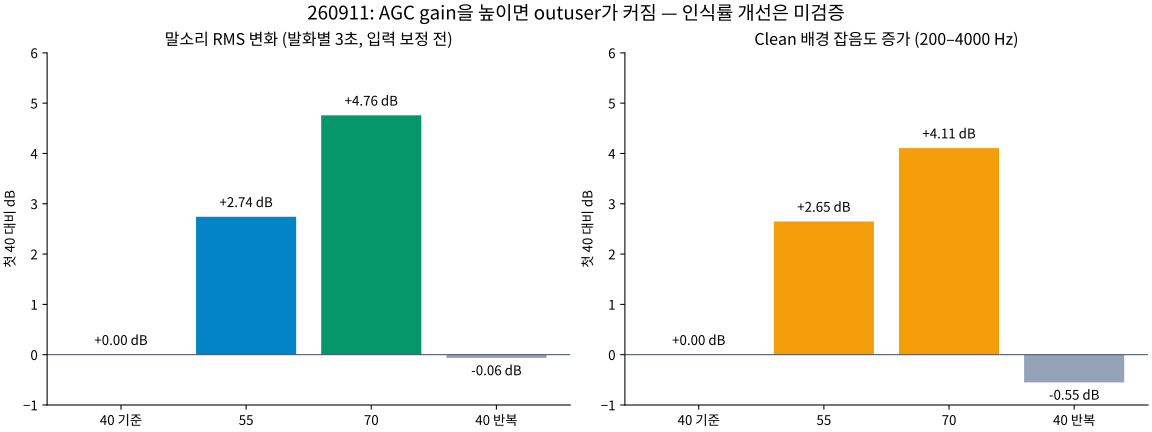
- F + 0.55를 잠정 기본값으로 사용한다. 9/11의 F + 0.4보다 말소리 RMS가 +2.74 dB 커졌다. Clean 배경도 +2.65 dB 커졌으므로 인식률이나 SNR 개선을 뜻하지는 않는다.
- Mini+Mesh Default와 비슷한 출력 크기까지 올라온 것으로 보인다. 9/10 Default는 −38.64 dBFS, 9/11 F + 0.55는 −38.15 dBFS였다. 날짜가 달라 동등성 확정은 아니지만, F + 0.4의 낮은 출력 수준을 벗어났다는 잠정 판단은 가능하다.
- 0.6 녹음은 있다. 다만 더 좋은 값이라는 증거는 없다. 9/2 F-V06을 outuser로 다시 계산해도 당일 0.4 대비 말소리 RMS −0.22 dB였다. 현재 1.1.18 조건의 0.55와 같은 시험 묶음이 아니므로 우열은 정하지 않는다.
여기서 Default는 Mini+Mesh의 MM118_DEFAULT다. 원래 A1 Default나 일반 Mini를 뜻하지 않는다.
세 후보의 실제 녹음값
| 후보 | 사용한 녹음 | 말소리 RMS | Clean 배경 | 잠정 판단 |
|---|---|---|---|---|
| Mini+Mesh Default | 260910 / MM118_DEFAULT | −38.64 dBFS | −56.82 dBFS | 비교 기준으로 유지 |
| F + 0.55 | 260911 / F_AGC55 | −38.15 dBFS | −56.71 dBFS | 우선 사용할 값 |
| F + 0.6 | 260902 / F-V06 | −36.54 dBFS | −50.40 dBFS | 과거 자료. 현재 조건의 우승 후보로 선정하지 않음 |
dBFS는 0에 가까울수록 크다. 표는 녹음값 목록이지 날짜를 넘긴 성능 순위표가 아니다. 특히 과거 0.6의 말소리와 배경이 모두 큰 것을 0.6의 효과라고 해석하면 안 된다. 당시 0.4도 이미 −36.32 / −50.83 dBFS로 컸다.
실제 Original Default 기준으로 얼마나 회복됐나?
F + 0.55는 실제 Original Default의 말소리 출력 수준에 도달했다. 다만 배경은 1.76 dB 높고, 음성대역 발화와 Clean 배경의 레벨 차이는 0.95 dB 작다. 기준은 Mini Default가 아니라 mesh/original/Original_Default의 260724 원본 WAV다. 이를 260911 F_AGC55와 같은 방식으로 재계산했다.
| 정량 지표 — 60/65 dB 각각 5발화 평균 | 실제 Original Default | F + 0.55 | 0.55 − Original |
|---|---|---|---|
| 발화별 3초 outuser RMS | −38.61 dBFS | −38.15 dBFS | +0.46 dB |
| 음성대역 발화 레벨, 프레임 p75 | −35.77 dBFS | −34.96 dBFS | +0.81 dB |
| MIC 4채널 중앙값의 음성대역 발화 레벨 | −70.69 dBFS | −69.23 dBFS | +1.46 dB |
| outuser − MIC 음성대역 전달량 | 34.92 dB | 34.27 dB | −0.65 dB |
| Clean 음성대역 배경 레벨 | −58.47 dBFS | −56.71 dBFS | +1.76 dB |
| 음성대역 발화 p75 − Clean 배경 | 22.70 dB | 21.76 dB | −0.95 dB |
60 dB 조건의 전체 대역 RMS는 Original −40.03 → 0.55 −39.01 dBFS(+1.02 dB), 65 dB는 −37.18 → −37.28 dBFS(−0.10 dB)다. 평균 출력 진폭의 비는 dB 평균 차이를 환산하면 약 1.05배다. MIC 입력 레벨도 1.46 dB 높으므로 출력 증가 전부를 처리 성능 향상으로 해석하지 않는다. 입력을 뺀 디지털 전달량은 Original보다 0.65 dB 낮다.
측정은 두 프로필 모두 60/65 dB의 호출어 10회, standalone outuser/MIC WAV를 사용했다. RMS는 발화별 3초 전체 대역, 음성대역은 200–4000 Hz다. Clean은 앞뒤 2초를 제외한 100 ms 프레임 RMS 중앙값이다. 마지막 행은 별도 Clean 녹음과 발화 p75의 레벨 차이이며, 동시 측정 SNR이나 과거 표의 SBR과 같은 지표가 아니다. 두 프로필 20발화 검출과 MIC 4채널 검출을 확인했고, F_AGC55의 RMS·전달량·Clean은 기존 공개 CSV의 값과 1e-9 dB 이내로 재현됐다.
판정: 출력 크기는 Original 수준, 배경 억제는 Original보다 다소 부족하다. 날짜·음원·거리·환경의 완전 일치는 확인되지 않았으므로 녹음 간 정량 비교이며, 인식률 회복이나 완전 동등성을 뜻하지 않는다. 과거 F의 SBR 격차 해소율 33%는 최신 0.55의 회복률로 사용하지 않는다.
근거: Original 직접 비교 요약, 20개 발화별 수치, Clean 원본 경로와 수치, 호출어 원본 SHA-256.
같은 날짜 안에서 무엇이 바뀌었나?
| 실제 비교 | 말소리 RMS 변화 | Clean 배경 변화 | 의미 |
|---|---|---|---|
| 9/10 Default → F + 0.4 | −2.13 dB | −2.50 dB | F + 0.4는 Default보다 작았음. 필터와 gain이 함께 달라짐 |
| 9/11 F + 0.4 → F + 0.55 | +2.74 dB | +2.65 dB | 현재 조건에서는 출력 크기 회복 확인 |
| 9/2 F + 0.4 → F + 0.6 | −0.22 dB | +0.43 dB | 과거 시험에서는 의미 있는 증폭이 나타나지 않음 |
9/10과 9/11의 F + 0.4 기준 녹음은 말소리 RMS 차이 약 −0.12 dB, Clean 차이 약 −0.04 dB로 가까웠다. 이는 0.55가 Default와 비슷한 출력 수준이라는 잠정 해석을 뒷받침하지만, 날짜 간 입력·설정·환경의 완전 일치나 Default 대비 인식률 향상을 증명하지는 않는다. 서로 다른 날짜의 증감 dB를 더해 “완전 복구”로 계산하지 않는다.
정정: 이전의 “0.6 미측정”은 260911 폴더에 없다는 뜻으로 범위를 명확히 했어야 한다. 260902의 0.6 실측을 이번 표와 SVG에 추가했다. 이전 분석 스크립트의 출력 선택은 outkardome이었으므로, 이번에는 outuser WAV를 직접 재계산했다. 그래도 과거 0.6에서 큰 증폭이 없었다는 관측은 유지된다. 과거와 현재 반응이 다른 원인은 이번 파형 비교만으로 확정하지 않는다.
측정 방법: 모든 표는 60/65 dB 각각 5회, 총 10발화의 3초 전체 대역 outuser RMS를 dB로 계산한 뒤 평균했다. 파일 끝에 가까운 Default 60 dB의 마지막 발화 1개는 3초 길이를 유지하도록 창을 안쪽으로 이동했다. Clean은 앞뒤 2초 제외 후 200–4000 Hz, 100 ms 프레임 RMS 중앙값이다. 두 지표를 빼서 SNR로 쓰지 않는다. 9프로필 90발화 검출을 확인했으며, 이 재분석이 과거 SDK/설정의 적용 로그를 새로 검증한 것은 아니다.
근거: 날짜별 재분석 요약, 90개 발화별 RMS, Clean 배경.
다음 단계는 후보를 더 늘리는 것이 아니라 F + 0.55로 실제 음성인식을 평가하는 것이다. Default는 비교 기준으로 남긴다. 0.6은 자동 채택하지 않고, 0.55의 음성 크기가 부족하거나 실제 인식에서 이득이 확인될 때 상향 후보로 사용한다.
1. 이제까지 시험으로 어디까지 결정할 수 있나?
| 결정할 항목 | 지금 판단 |
|---|---|
| 사용할 필터 | F 유지. 기존 형상·필터 시험에서 확보한 기준선 |
| 출력 크기를 조정하는 방법 | AGC ON에서 vol → AGC_MAX_GAIN_ZONE 사용 |
| 기본 gain | 55 / vol 0.55를 잠정 채택 |
| EQ_TOTAL_GAIN | 0 유지. AGC ON에서 이 값을 증폭 축으로 시험하지 않음 |
| limiter | 변경하지 않음. 이번 파형에서 상한을 높일 근거 없음 |
| 인식률 최고값 | 미확정. 55보다 60/70이 실제 인식에 유리할 때만 상향 |
왜 55인가? 40보다 말소리 RMS가 +2.74 dB 커졌고, 70보다 배경 잡음 증가가 작았다. 두 조건 모두 full-scale clipping은 없었다. 따라서 출력 확보와 불필요한 잡음 증폭 사이에서 낮은 gain을 우선하는 판단이다. 55의 SNR이 더 좋다거나 인식률이 더 높다는 측정은 아니다.
2. 260911 실측 결과
| 첫 F_AGC40 대비 | vol 0.55 | vol 0.7 | 0.4 반복 |
|---|---|---|---|
| 발화별 3초 전체 대역 outuser RMS | +2.74 dB | +4.76 dB | −0.06 dB |
| MIC 입력 차이를 보정한 음성대역 전달량 | +2.78 dB | +4.77 dB | −0.18 dB |
| Clean 음성대역 배경 레벨 | +2.65 dB | +4.11 dB | −0.55 dB |
호출어 60/65 dB 각각 5개 발화, 총 10개 이벤트를 비교했다. 음성대역 전달량은 기존 방식의 200–4000 Hz 발화 프레임 75백분위 레벨로, 첫 행 RMS와 정의가 다르다. Clean은 앞뒤 2초 제외, 100 ms 음성대역 프레임 RMS 중앙값이다. 표의 차이를 빼서 정밀한 SNR 개선량으로 해석하지 않는다.
- 총 20조건, WAV 100개 정상 읽기·유한값 확인. 20조건 모두 property, gain setter 성공, SDK 1.1.18 및 설치 파일 4개 해시가 맞았다.
- outkardome은 같은 정도로 커지지 않았다. 실제 증가가 나타난 출력은 outuser다.
- 전체 WAV에서
|sample|≥0.99clipping 0%. outuser 최대 절댓값 약 0.243,|sample|≥0.299표본도 없었다. AGC enable·limiter 내부값 조회는 없는 상태이므로 limiter 0.3 적용을 독립 검증했다고 쓰지 않는다. - ref는 모두 0. 첫 40의 60 dB allinout 5회 검출은 실패했고 65 dB도 별도 WAV와 시간차가 있어 완전 정합을 주장하지 않는다. standalone 발화 비교는 가능했으며, 나머지 6개 voice run의 보조 상관은 ≥0.9905였다.
- 같은 run의 outuser/outkardome 발화 레벨 비율 변화도 55 +2.89, 70 +4.90, 반복 +0.02 dB여서 증폭과 복귀를 지지한다.
- 잡음도 커졌다. dropout 0%, STT 정확도 향상, 원래 A1 대비 완전 회복은 판정하지 않았다.
근거: 발화별 요약, 실제 3초 RMS, WAV 지표, 정합성 검증.
보조 CSV의 전체 대역 MIC RMS 보정값은 55 +4.56/70 +6.21 dB지만 반복에서도 +1.54 dB로 움직인다. 전체 대역 입력 변동에 민감하므로 주 gain 결론으로 사용하지 않았다. 주 판단은 음성대역 입력 보정과 보정 전 출력 RMS의 일치에 근거한다.
3. 잠정 기본값 — F_AGC55
기기 root shell에서 아래 전체를 실행한다.
setprop persist.vendor.audio.sndflow.vol 0.55
setprop persist.vendor.audio.sndflow.krdm.kws.sensitivity ""
setprop persist.vendor.audio.sndflow.krdm.pre_filter "5,150,0,0"
setprop persist.vendor.audio.sndflow.krdm.eq_filter "0,1800,2.5,1;0,2800,1.5,1"
setprop persist.vendor.audio.sndflow.krdm.eq_total_gain 0
4. 선택적 비교값 — F_AGC60
55에서 실제 인식용 말소리 크기가 부족할 때 비교할 중간값이다. 260902 실측은 위 표에 포함했으며, 당시 outuser 증폭은 나타나지 않았다. 260911에는 0.6 프로필이 없으므로 이 과거 결과를 현재 설정의 0.55와 직접 비교해 순위를 정하지 않는다.
setprop persist.vendor.audio.sndflow.vol 0.6
setprop persist.vendor.audio.sndflow.krdm.kws.sensitivity ""
setprop persist.vendor.audio.sndflow.krdm.pre_filter "5,150,0,0"
setprop persist.vendor.audio.sndflow.krdm.eq_filter "0,1800,2.5,1;0,2800,1.5,1"
setprop persist.vendor.audio.sndflow.krdm.eq_total_gain 0
5. 참고 이력 — F_AGC70 (이번 1차 실행 대상 아님)
실측된 높은 gain 후보다. 55보다 크지만 잡음도 증가했으므로 자동으로 최종값으로 올리지 않는다.
setprop persist.vendor.audio.sndflow.vol 0.7
setprop persist.vendor.audio.sndflow.krdm.kws.sensitivity ""
setprop persist.vendor.audio.sndflow.krdm.pre_filter "5,150,0,0"
setprop persist.vendor.audio.sndflow.krdm.eq_filter "0,1800,2.5,1;0,2800,1.5,1"
setprop persist.vendor.audio.sndflow.krdm.eq_total_gain 0
6. 각 조건 적용 후 — 재시작·확인
기존 녹음이 끝나고 PC에 저장됐는지 먼저 확인한다. 녹음 중에는 재시작하지 않는다.
stop soundflowservice
getprop init.svc.soundflowservice
stopped 확인 후:
start soundflowservice
getprop init.svc.soundflowservice
running 확인 후:
/vendor/bin/soundflowctl start
getprop sys.audio.sndflow.krdm.version
getprop persist.vendor.audio.sndflow.vol
getprop persist.vendor.audio.sndflow.krdm.pre_filter
getprop persist.vendor.audio.sndflow.krdm.eq_filter
getprop persist.vendor.audio.sndflow.krdm.eq_total_gain
logcat -d -b all | grep -E 'AGC_MAX_GAIN_ZONE|applied filters|EQ_ENABLE|EQ_TOTAL_GAIN|Invalid value'
가장 최근 재시작 시각의 AGC_MAX_GAIN_ZONE=55/60/70 result=0, 필터 적용 성공, EQ_TOTAL_GAIN readback 0, 버전 1.1.18을 확인한다. 이전 성공 로그로 현재 적용을 대신 판단하지 않는다. AGC ON은 기존 서비스 설정을 유지하며 새 AGC/limiter property를 추가한 것은 아니다.
녹음 시작·종료·WAV 저장은 기존 테스터 명령서 4절의 B–D를 그대로 사용한다. 저장 폴더는 F_AGC55_60dB, F_AGC60_60dB, F_AGC70_60dB처럼 구분한다. 같은 폴더를 덮어쓰지 않는다.
7. 더 시험해야 한다면 최소한만
55를 기본값으로 진행하고, 기존의 “설정이 먹는가?” 시험은 끝낸다. 세 후보를 반드시 모두 재녹음해야 기본값을 정할 수 있는 것은 아니다.
남은 것은 실제 STT 입력이 outuser인지 확인하고, 같은 문장·같은 거리에서 조용한 환경과 팬 소음 환경의 인식 결과를 비교하는 일이다. 인식 차이가 없으면 낮은 gain을 유지한다. 파형만 확인할 경우 “입력 크기 확보”까지만 판정한다.
실제 Original Default와의 원본 재분석에서는 RMS +0.46 dB, Clean 배경 +1.76 dB를 확인했다. 위 직접 비교표의 관측 차이와 별개로, 인식 성능의 동등성을 판정하려면 같은 음원·거리·음압의 비교가 필요하다.